MoE部署别把激活参数当成存储需求
文章以Kimi K3.1 Pro所报参数量说明,MoE每次激活的参数只是总权重的一部分。按理想4位量化计算,2.8万亿总参数约需1400GB权重存储,且尚未包含元数据与运行开销。
AI 深度解读
Kimi K3.1 Pro 标出的 2.8 万亿总参数和 1040 亿激活参数,回答的是两个不同的问题:一次计算会动用多少模型,以及部署时要为多少权重安排存储。把后者看成前者,硬件预算可能从一开始就算错。
原文最有用的部分,是把这个区别算清楚了:理想四比特表示下,完整权重是 1400 GB,激活部分是 52 GB。但作者没有加载 Kimi 检查点,也没有跑推理,不能把这些数字当成部署实测。
104B 激活参数,为什么不能按 52 GB 部署
混合专家模型(Mixture of Experts,MoE)会通过路由机制,让一个 token 只经过部分专家网络。它节省的是每次计算都调用全部专家的工作量,未被选中的专家权重仍然存在。
可以把它理解成一家有许多专业工位的车间。这件零件只去其中一个工位加工,不代表其他工位就能从厂房里消失。
激活参数描述稀疏计算,总参数仍要进入权重存储预算。
按原文给出的参数量,Kimi K3.1 Pro 的完整权重与激活子集,在不同精度下分别是:
| 每参数位数 | 2.8T 完整权重 | 104B 激活子集 |
|---|---|---|
| 16 bit | 5600 GB | 208 GB |
| 8 bit | 2800 GB | 104 GB |
| 4 bit | 1400 GB | 52 GB |
这里的 GB 全是十进制单位。计算方法是「参数量 × 每参数位数 ÷ 8」,得到字节数后,再除以 1,000,000,000。若除以 2**30,得到的则是 GiB,硬件估算时不能混用。
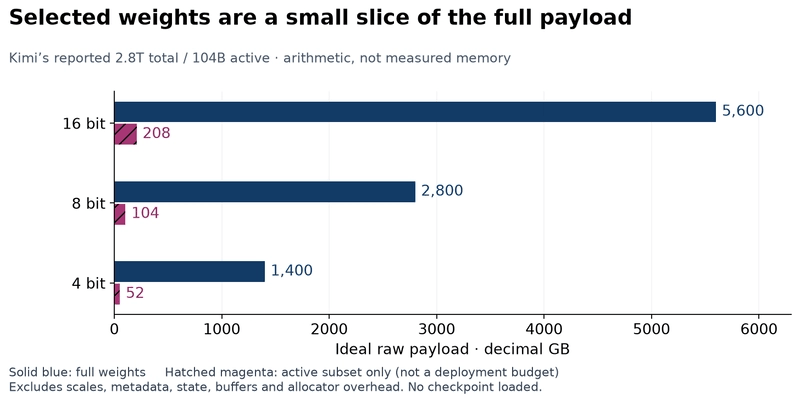
不过,1400 GB 也只是理想的原始权重载荷。量化格式可能额外保存缩放系数、分组信息,部分张量还可能保留更高精度,运行时也要另占内存。
因此,算出四比特载荷,不代表合适的四比特检查点已经存在,更不代表推理框架支持它,或量化后仍能满足质量要求。
单个 token 用得少,为什么批量服务仍会碰到更多专家
「每个 token 只激活一部分参数」还有一个容易漏掉的前提:不同 token 选中的专家,可能并不相同。
原文用了一个教学模型:共有 8 个专家,每个 token 选择 1 个,选择相互独立且均匀分布。对于某个专家,一个 token 没选中它的概率是 7/8;B 个 token 全部错过它的概率就是 (7/8)**B。因此,一批 token 触及的不同专家数量,其期望值为 8 × (1 - (7/8)**B)。
下面这段标准库 Python 同时核对权重算术和教学模型。保存为 payload.py,执行 python3 payload.py 即可:
from decimal import Decimal
from itertools import product

total = 2_800_000_000_000
active = 104_000_000_000

def gb(parameters, bits):
    return Decimal(parameters) * bits / 8 / 10**9

for bits in (16, 8, 4):
    print(f"{bits:2d} bit: total={gb(total, bits):.0f} GB, "
          f"active subset={gb(active, bits):.0f} GB")

experts = 8
for tokens in (1, 2, 4):
    expected = experts * (1 - (1 - 1 / experts)**tokens)
    exhaustive = sum(
        len(set(route))
        for route in product(range(experts), repeat=tokens)
    ) / experts**tokens
    assert abs(expected - exhaustive) < 1e-12
    print(f"toy batch={tokens}: {expected:.6f} unique experts")
需要看清的是 experts = 8 和后面的路由假设:它们用于演示,不能视为 Kimi 的真实配置。assert 则用穷举结果核对期望公式,误差阈值为 1e-12。
原文给出的输出是:
16 bit: total=5600 GB, active subset=208 GB
 8 bit: total=2800 GB, active subset=104 GB
 4 bit: total=1400 GB, active subset=52 GB
toy batch=1: 1.000000 unique experts
toy batch=2: 1.875000 unique experts
toy batch=4: 3.310547 unique experts
一个 token 只选一个专家,但 4 个 token 平均已经触及约 3.31 个不同专家。实际路由还可能存在选择偏斜、一次选择多个专家、共享组件和调度约束。
这个例子证明的范围很窄:不能用单个 token 的激活参数量,替代服务系统在一段时间内需要提供的权重集合。它没有证明 Kimi 的专家访问分布,更没有测出批量服务的内存峰值。
真正估算部署,要先拿到哪些信息
按照原文转述,Moonshot 宣称 K3.1 Pro 由 K3 后训练而来,支持百万 token 上下文,并通过产品和 API 提供服务;发布时承诺在 11 月 4 日前提供完整权重。这里是原文记录的发布承诺,并非本文核验过的交付状态。
对团队而言,评估托管 API 和评估未来的自部署检查点,是两项可以分开推进的工作。
自部署首先要拿到实际检查点清单和张量数据类型,再确认运行时如何分配专家、哪些张量会复制、哪些权重会卸载,以及业务负载需要多少临时空间和序列状态。
作者提到 vLLM 的专家并行文档,是因为跨设备分布专家、增加冗余专家,都会影响内存占用。但这份文档不能单独证明 vLLM 已支持这个新检查点。
权重卸载(offloading)也只是改变存放位置和搬运时机,同时引入传输与调度成本。它不会把总参数变成激活参数。同样,百万 token 上下文说明模型接受的长度上限,无法直接回答某条请求会占多少内存。
我的判断
这篇的价值在于纠正了预算口径,而且作者清楚划出了证据边界:核对过的是参数算术和合成路由模型,没有运行 K3.1 Pro 推理。
其中,权重载荷计算可以复核;真实部署需要多少设备、能达到什么吞吐、量化后质量怎样,原文都没有给出答案。也没有 API 与自部署的成本对照数据,因此不能据此宣布哪种方案更划算。
我认可用总参数开始盘点存储需求,但也不能进一步把 1400 GB 理解成「必须同时占用这么多 GPU 显存」。权重可以分布在不同设备或存储层级,实际安排取决于运行时和服务目标。
相比只看激活参数的简化估算,这套思路更完整;相比真正的容量测试,它还只是准备工作。尤其对主要通过 API 接入模型的前端、全栈团队,先验证任务效果和调用表现,往往比围绕参数量猜设备配置更直接。
能拿来做什么
- 给 Node 服务做模型接入评估时,把托管 API 的任务测试与自部署预算分开记录,避免用一个参数数字同时决定效果和基础设施方案。
- 阅读 MoE 发布信息时,分别记下总参数、每 token 激活参数和权重精度;计算容量时标明 GB 或 GiB,并给额外开销单独留项。
- 准备自部署前,先检查权重文件、张量精度、运行时支持和专家放置方式,再按实际请求长度与批量配置测试内存。
- 向团队解释激活参数时,可以运行原文脚本展示批量访问专家的变化,同时明确它是教学模型,不能代替 Kimi 的服务压测。