让 Kafka 按 AI 分类结果动态分发事件
教程通过开源 Kafka Connect sink 连接器,将支持工单交给 JEV 分类,再把判断结果写回事件并选择目标主题。提供代码与配置,并围绕 2 万次评估测量延迟和成本。
AI 深度解读
Kafka 里的客服工单,能不能先让模型判断「该找谁、是否紧急、要不要人工」,再自动进入对应的 topic?作者用 Kafka-JEV-Connector 做了一条这样的流水线:JEV 负责给出结构化答案,Kafka Connect 按明确规则完成分流。
这套方案值得看的地方,是模型判断和业务规则如何分工,以及一次 20,000 次评估的实测。但先留一个问号:调用成功、延迟低、费用少,都不能直接证明工单分得准。
事件不会自己选路,真正选路的是答案和规则
Kafka-JEV-Connector 是作者开发的开源 Kafka Connect sink connector。它消费指定 topic 的记录,把事件整理为模型上下文,交给 JEV 回答一组问题,再将答案补充回原始事件,发布到目标 topic。失败记录可以进入死信队列(DLQ)。
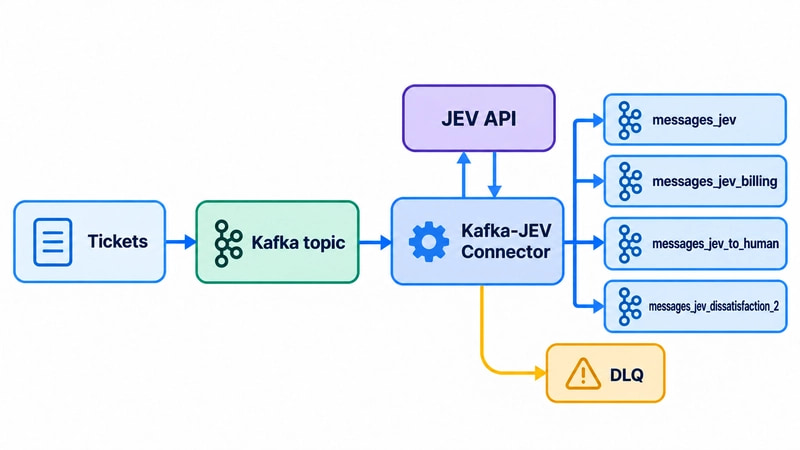
演示从 CSV 读取客服工单,写入 messages,处理结果进入以 messages_jev 开头的 topic。每次成功评估只向一个目标发布一条记录,不会同时广播到多个 topic。
接入前先定义两件事:问什么,以及提供哪些信息。
问题覆盖人工介入、取消风险、部门、客户意图、紧急程度和不满程度,混合使用 noul、choice、score 类型。原文没有完整解释 noul 的语义,只展示了它的数值可以参与阈值比较,因此不能直接将它当成经过校准的概率。
这些问题保存在 config/questions.json,通过 python3 config/set_questions.py 序列化到连接器配置。问题的答案键和取值也是接口契约:例如 department.choice 会进入 topic 名称,改动部门选项就可能影响下游消费者。
模型负责估计,业务规则负责决定估计如何影响流程。
为什么上下文模板比整条 JSON 更值得先配置
连接器支持 state.mode 为 FULL_VALUE,直接发送完整记录值。接入方便,但也可能带上无关字段或敏感信息。
作者选择 TEMPLATE,只提取工单编号、主题和正文,并为字段补上标签:
{
  "state.mode": "TEMPLATE",
  "state.template": "Ticket: ${key}\nSubject: ${value:/subject:-(no subject)}\nMessage: ${value:/body:-(no message)}"
}
要留意 ${value:/subject:-(no subject)}:它通过 JSON Pointer 读取字段,并用 :- 提供缺省值。没有缺省值时,引用缺失会被视为永久失败,记录进入 DLQ。
例如 key 为 ticket-42,主题为 Payment failed,正文为 My card was charged twice,JEV 收到的是带标签的三行文本。这样既能说明字段含义,也能控制哪些数据离开 Kafka。
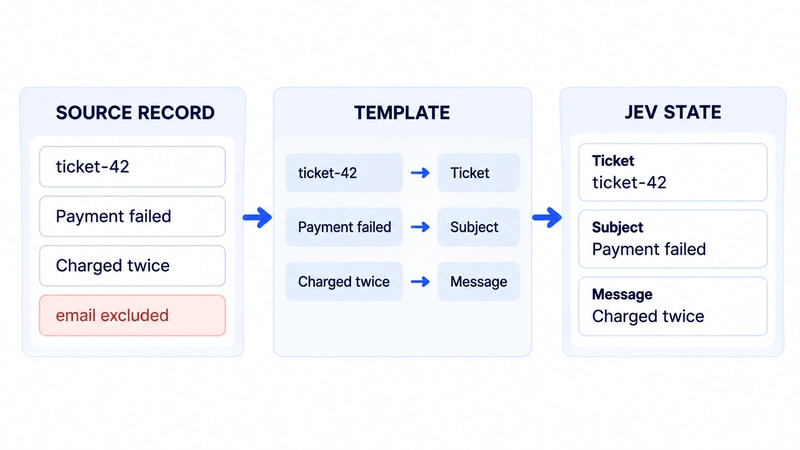
模板还可以读取完整 key、value、headers 和 Kafka 元数据。不过,「能给缺省值」不等于「应该给缺省值」。正文缺失仍继续分类,是否符合业务要求,需要团队自己决定。
连接器类是 io.github.smatiolids.kafkajev.JevSinkConnector,示例设置 tasks.max 为 1、question.set.id 为 message_classification/v1,空值处理为 behavior.on.null.values: IGNORE。服务端点是 https://api.typesafe.ai/v1/systemone,配置模型为 jev-latest。
连接配置通过 ${env:KAFKA_BOOTSTRAP_SERVERS} 读取输出 Kafka 地址,通过 ${env:TYPESAFE_API_KEY} 读取 JEV 密钥。成功输出默认到 messages_jev,失败输出到 messages_jev_dlq。连接器不会创建 topic,所有可能的目的地都要提前准备。
四种路由方式,实际测了五份配置
固定输出最简单:output.topic 设置为 messages_jev,答案只用于丰富事件。
按部门分流则使用 messages_jev_${answers.department.choice}。返回 billing 就进入 messages_jev_billing,返回 technical_support 就进入 messages_jev_technical_support。
阈值路由适合表达人工介入策略,原文配置如下:
{
  "output.topic": "messages_jev_${answers.requires_human.noul > 0.8; \"to_human\", \"to_agent\"}"
}
关键是 > 0.8:只有超过阈值才进入 messages_jev_to_human,其余进入 messages_jev_to_agent。阈值由业务设定,原文没有证明 0.8 对其他团队也合适。
紧急程度用相同机制:messages_jev_${answers.urgency.score > 2 ; "urgent", "normal"}。保留完整等级则使用 messages_jev_dissatisfaction_${answers.customer_dissatisfaction.level},四项判定标准对应后缀 0、1、2、3。
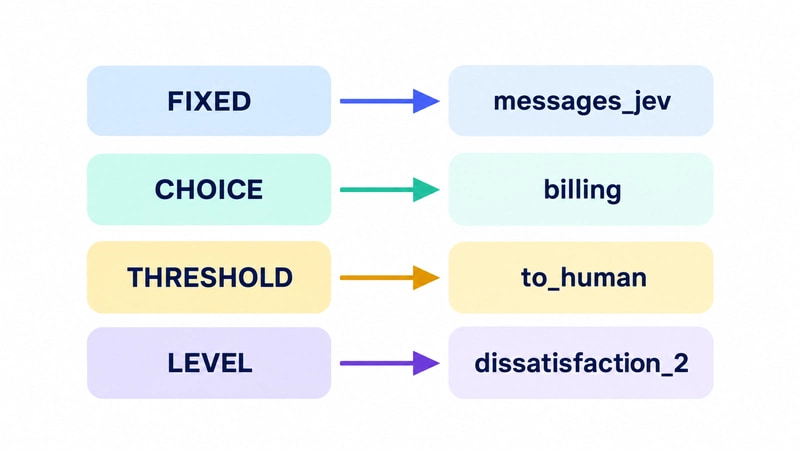
四类模式包含两份阈值配置,所以测试共有五份输出配置。作者将同样的 4,000 张工单分别评估,得到 20,000 条增强记录,另有 4,000 条原始输入。实际解析到的模型均为 jev-1.14.0。
人工需求值平均为 0.74;阈值取 0.5 时,90.1% 会被判为需要人工。采用 > 0.8 后,1,797 张进入人工,2,203 张继续交给 agent。紧急程度按 score > 2 分流,1,573 张进入紧急路径,占 39.3%。
每份配置都重新调用模型,结果并不确定。因此,这些分布同时受规则和模型输出变化影响。
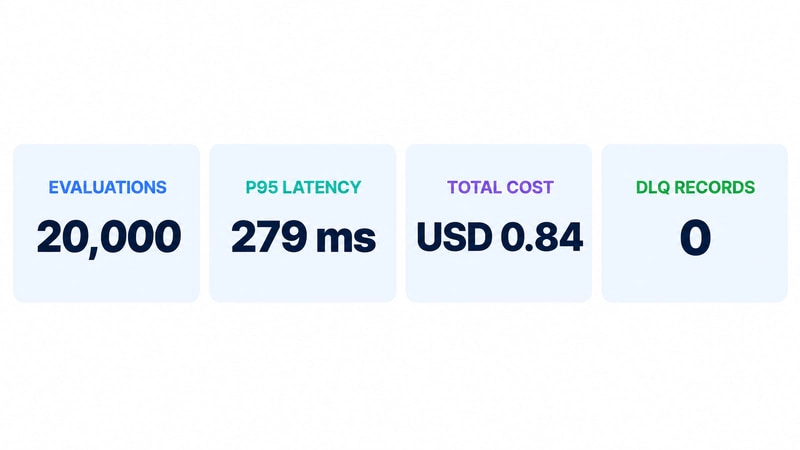
这次测试全部首次成功,没有重试或 DLQ 记录,JEV 调用延迟的 p95 低于 300 ms。所给正文没有展开其他延迟分位数,也没有给出完整流水线延迟,不能据此推算端到端表现。
输入消耗为 20,002,245 tokens,输出为 3,737,920 tokens,平均每条共 1,187 tokens。按测试采用的每百万输入 tokens USD 0.042 计价,全部约 USD 0.84,单轮 4,000 张约 USD 0.17。这是当时的模型调用费用记录,不能当作当前报价或完整运行成本。
我的判断
我认可它把结构化判断、业务阈值和消息管道分开处理。相比直接让模型返回最终 topic,显式规则更方便审查和调整;相比固定关键词规则,模型可以尝试处理工单正文中的语义。但作者没有提供两者的分类效果对照,这仍是方案取舍,不能写成已验证的优势。
最大的缺口是准确性。原文没有人工标注集、误分率,也没有说明真正需要人工的工单漏掉多少。阈值提高后,人工队列变短是可观测结果;服务质量是否保持,并没有证据。
性能结论也有边界。tasks.max: 1 和单次测试结果不足以说明高峰吞吐、积压恢复能力;首次全部成功,也没有验证故障时的恢复行为。原文没有说清发布与消费进度提交之间的重复处理边界。
另外,配置里的 jev-latest 最终解析到 jev-1.14.0。未来模型解析结果变化后,原阈值是否仍然适用,需要重新评估。
这份实测证明了流程能跑通,还没有证明分类质量足以承担业务后果。
能拿来做什么
-
已有 Kafka 工单流的团队,可以先固定输出到
messages_jev,对照人工处理结果检查部门、紧急程度和人工需求答案,再决定是否让答案直接控制分流。 -
接入前先用模板列出必要字段,并逐项判断缺失时应当补默认值还是进入 DLQ。同时预建所有输出 topic,避免模型判断成功后无法发布。
-
复现时,从仓库示例创建
.env并设置TYPESAFE_API_KEY,执行docker compose -f compose.kafka.yaml -f compose.yaml up -d --build --wait,再用curl --fail --silent localhost:8083/connectors/jev/status检查状态。依次运行python3 -m venv .venv、.venv/bin/pip install -r requirements.txt和.venv/bin/python helper/send_message.py --limit 10,先验证十张工单,因为每张都会触发一次 JEV 调用。 -
用
.venv/bin/python helper/receive_messages.py --from-beginning --pretty查看结果,用.venv/bin/python helper/summarize_results.py汇总数据。切换策略时,将.env的CONNECTOR_CONFIG_FILE改为相应的connector-local*.json并重启连接器环境,记录分流变化,再检查被转交给 agent 的工单是否适合自动处理。