拆解 LiteLLM Rust 网关性能宣传
文章围绕 LiteLLM Rust 的性能宣传与 Bifrost 团队的反驳,对照原始基准数据分析双方论据。测试使用本地模拟提供方,主要衡量网关自身开销;作者也披露了此前采用 Bifrost 的背景。
AI 深度解读
LiteLLM 在 2026 年 7 月公布 Rust AI 网关基准测试,宣称比 Bifrost 开销低约 7 倍、内存少约 9 倍。Bifrost 团队随后检查其公开文件,发现这些标题与原始数据之间存在多处断点。
这篇解读的价值,在于把「跑得快」拆成可检查的问题:比较的是哪个版本,开启了哪些功能,数字来自实测还是推算。现有数据支持 Rust 资源占用较低,却不足以支持它在延迟和吞吐上全面领先 Bifrost。
「快 7 倍」为什么对不上原始数据
这轮测试比较了 LiteLLM Rust beta、LiteLLM Python v1、Bifrost v1.6.4 和 Portkey OSS。四者都连接同一个本地模拟服务(mock provider),目的是排除真实模型生成时间,观察网关转发请求时增加的开销。
LiteLLM 给出的宣传包括:相对 Bifrost,开销低约 7 倍、内存少约 9 倍、每美元请求数多约 4.5 倍;另有一项「比下一个 AI 网关开销低 3.5 倍」。
问题首先出在数字的出处。
支撑「7 倍」的 Bifrost 开销是 4.5 ms,但 Bifrost 团队没有在公开的延迟扫描数据中找到对应行。「3.5 倍」比较的则是 Portkey,数字为 2.29 ms 对 0.66 ms,不能把它理解成对 Bifrost 的比较。
原文作者表示,自己逐项核对了 results/latency_vs_concurrency.csv,下述记录均无请求错误。按相对直连增加的 p99 延迟看,并发为 1 和 64 时 Bifrost 更低,并发为 4 和 16 时 LiteLLM Rust 更低。并发为 4 时,两者只差 0.02 ms。p99 可以理解为请求耗时分布的第 99 百分位,用来观察较慢的一端。
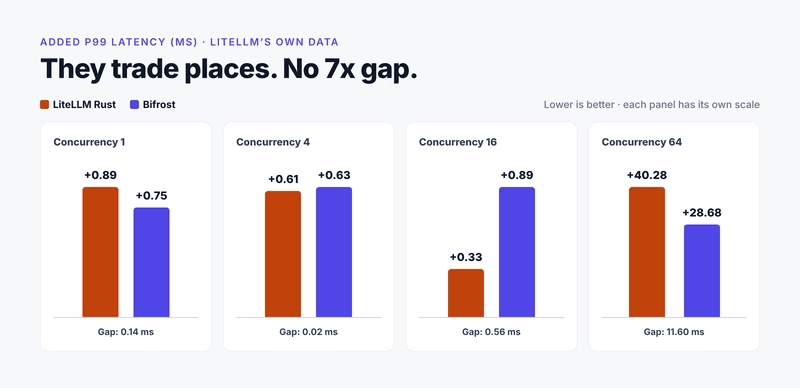
吞吐量也没有拉开明显距离。原文指出,两者吞吐差距约为 0.1% 至 2.5%,而汇总表中 Bifrost 一栏却用了横线。在已列出的最高并发档位,两者只差约 0.1%,实际选型时可以视为接近。
公开扫描数据呈现的是随并发变化互有胜负,无法支撑普遍快 7 倍的结论。
还有几处口径需要补齐:脚注写着「single client」,扫描却包含 1 至 64 个并发请求,客户端数量和并发数量需要解释清楚;宣传中的约 21% CPU 未出现在 Rust CPU 文件中,其中最高值是 15.9%;结果目录存在并发 256 的记录,却没有进入扫描汇总。
这些问题未必都指向性能造假,但会影响读者能否从图表追溯到具体实验。
Rust 的资源优势成立,倍数还要打问号
内存和 CPU 是 Rust 表现更有说服力的部分。
原文汇总的文件中,Rust 内存读数最高约 36 MB,仍低于 Bifrost 最低的约 144 MB;平均 CPU 为 0.66%,Bifrost 为 2.59%。这些记录支持「该测试配置下 Rust 更省资源」。
但「省约 9 倍」还涉及指标名称和配置是否一致。
图表把内存称为「memory at rest」或「idle」,底层列名却是 peak_rss_mb,记录的是峰值常驻内存。空闲占用和负载期间的峰值回答的是不同问题,不能混用。
文件里还有三组比较:199.1 MB 对 21.8 MB、144 MB 对 26.1 MB,以及 282 至 298 MB 对 35 至 36 MB。宣传采用了差距最大的一组。读者需要知道各组对应什么场景,才能判断这个倍数是否有代表性。
更关键的是日志配置。LiteLLM 表示所有网关都关闭了日志、费用跟踪和持久化;Bifrost 团队却指出,仓库配置没有显式设置 enable_logging 为 false,而 gateway 模式默认启用日志插件,可能连带承担 SQLite 的资源开销。
这里必须保留限定:这一判断基于较新的 Bifrost 代码,尚未在被测的 v1.6.4 上确认。因此,不能把「可能开启日志」写成已经证实。
版本也有影响。测试使用 v1.6.4,原文列出其后已有 v1.6.5 至 v1.6.11、v2.0.0 至 v2.4.0,变更日志还列到了 v2.5.1。Bifrost 团队称 2.x 大幅降低了内存,但这篇没有提供相应复测数据。
「每美元请求数多约 4.5 倍」则又多了一层推算:它基于假设的 4 vCPU / 16 GB 实例,以及前述 CPU、内存读数计算,并非端到端测出的账单。每 100 万次请求成本也是同类模型结果。资源比较的配置疑点,会继续传导到成本结论中。
复测之前,先确定比较的是同一种工作
LiteLLM 自己也披露了限制:测试由厂商执行,streaming 和完整功能仍在补齐,结果应按数量级理解。
Bifrost 团队进一步指出,按源码字节计算,仓库中 Rust 占比为 3.11%;LiteLLM 自有追踪器显示,截至 v1.107.0-rc.2,主要 API 完成了 24%。
源码占比不能直接代表请求路径的性能,API 数量也不能直接代表业务覆盖率。不过,这些信息提醒我们:被测对象是功能仍在建设中的 Rust beta,不能直接替代对完整 LiteLLM 产品的评价。
原文还保留了一个对 Rust 有利的结果:在单次并发 256 实验中,Rust 的 p50 为 55.5 ms,Bifrost 为 89.3 ms;p99 分别为 2,667.8 ms 和 5,421.3 ms。但连直连基线都超过了测试阈值,因此 Bifrost 团队把它视为探索性实验,没有当作容量结论。
复测时,本地 mock 可以帮助隔离网关自身成本。原文启动它的命令是:
cargo run --release -p mock-upstream
注意 --release:这是原文采用的运行方式,复现时应保留。各网关随后按 gateways/<name>/README.md 接入 mock;运行场景后,再生成图表:
python analyze/make_chart.py
注意这行只负责重新生成图表,不能代替实际压测。原文没有给出具体运行场景的命令,需要继续查看仓库说明。
有效复测还要补上机器型号、核心数、worker 数和 mock 延迟,让各方日志配置一致,分别报告空闲和峰值内存,多次运行并展示波动,同时保留所有已测试的并发档位。当前结果看起来每个场景只有一次运行,没有误差线,也缺少上述环境细节。
Bifrost 团队承诺在 Part 2 使用当前版本,分别测试日志开启和关闭的情况,并披露硬件与重复实验结果。这仍是后续计划,不能提前当作证据。
我的判断
这篇对「7 倍」的质疑有明确依据:公开数据无法对应宣传使用的关键数值,延迟与吞吐的实际差距也小得多。它同时承认 Rust 的资源优势,没有因为标题存在问题就否定全部结果,这一点合理。
但读者也要知道,作者此前已经写过从 LiteLLM 转向 Bifrost 用于生产系统的经历,而主要反驳材料来自 Bifrost 团队。它们提出的问题值得核查,双方的性能主张都应接受同样标准。
对于一般团队,关闭所有插件的 mock 压测适合定位代理层开销。真实选型还需要另一组测试:打开业务实际使用的日志、预算、fallback 和缓存,观察完整请求链路。原文没有给出这些条件下的对照数据,因此无法判断谁在你的生产环境里更好。
现在足以质疑宣传倍数,还不足以宣布最终赢家。
能拿来做什么
- 如果你的 Node 服务正在接入 LLM 网关,先把候选版本和功能配置写进测试记录,尤其核对日志是否真正关闭,避免只比较配置说明。
- 用本地 mock 测网关自身开销,再用实际模型和业务功能测完整链路;分别记录延迟、吞吐、CPU 与内存,别用其中一项代替整体表现。
- 面对「快几倍」的宣传,要求它对应具体数据行、并发档位和重复运行结果;面对成本结论,先确认它来自实际账单还是实例规格推算。
- 如果正在评估 LiteLLM Rust beta,先检查所需 API 和 streaming 能力是否覆盖业务,再决定是否值得继续做性能验证。