用固定评测集验证提示词改动
作者以 WhatsApp 助手为例,介绍用固定样本和证据引用检查提示词改动,替代少量手工试问。文章还提醒托管评测用户关注服务停用安排,将用例和评分规则迁至可版本管理、自行运行的环境。
AI 深度解读
改完 prompt,拿三个熟悉的例子试一下,回答看着顺眼就上线,这是很多 AI 功能的发布流程。作者用自己的 WhatsApp 助手和一组公开实验说明:这种办法很容易漏掉误报,也看不见改动带来的退步。
他的结论是,先把「什么算答对」写成固定用例,再讨论 prompt 有没有变好。文章更有用的部分,是作者承认自己做过的检查也有漏洞:测试可能只验了接线,AI 裁判可能赞同错误,纠错记录也可能从未参与回归。
先证明消息里有这句话,再判断它是不是待办
作者的 Message Yourself OS 会读取 WhatsApp,整理谁在等他回复、他向谁作过承诺。这类助手一旦把闲聊认成承诺,就会直接污染用户的待办列表。
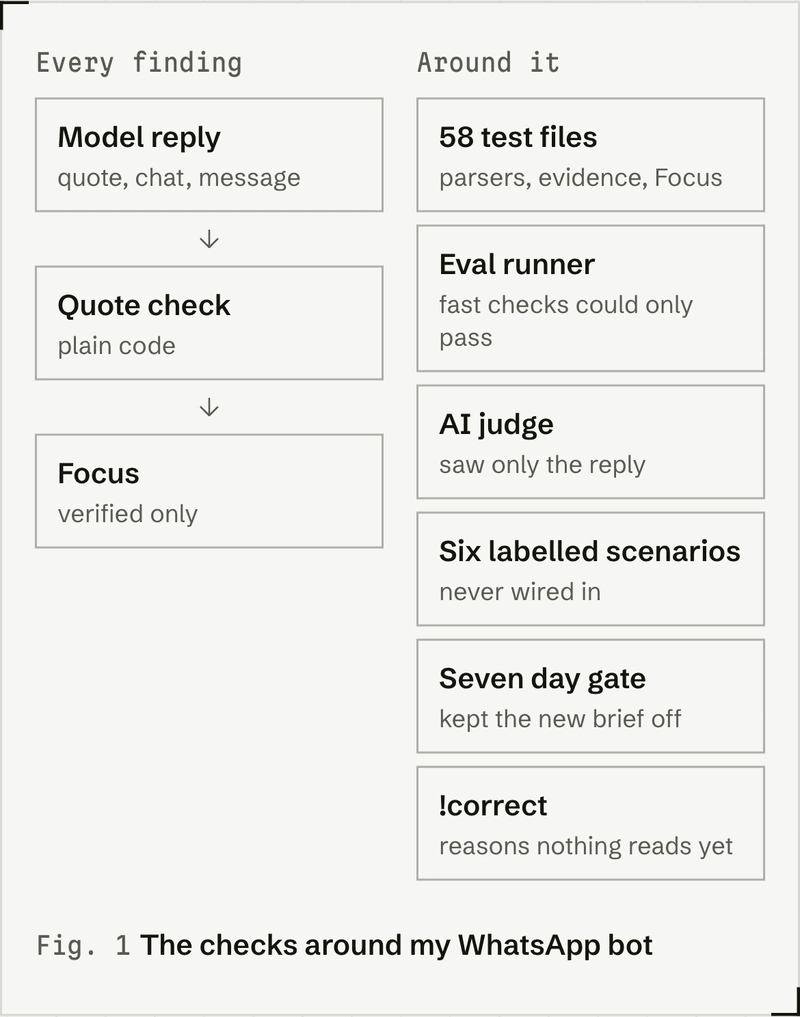
他们的第一道检查很具体:模型返回每条发现时,必须附上原文引用、所在聊天和消息。普通代码再取回对应消息,检查引用是否存在、时间是否一致,结果分成 verified、missing、not found、quote mismatch 和 time mismatch。
只有 verified 能进入 !today 顶部的 Focus 列表,其余放进「Needs verification」,不能直接当作事实展示。
引用核验能证明模型没有捏造这句话,却不能证明这句话就是一项待办。
这两层正确性必须分开。模型可以准确引用一句反问,但依然错误地认为用户需要回复。
围绕这条链路,作者还建立了 58 个测试文件,覆盖解析器、证据检查,以及未经核验的条目不能进入 Focus 的规则。本地评估器分两档:快速档不需要 WhatsApp 连接或网络;完整档通过本地服务器运行命令,跟踪延迟和回归。AI 裁判自身执行失败时,结果显示为 not scored,不能冒充有效分数。
新版排序式 !today 还有上线门槛:必须经过七天真实使用的人工复核,没有错误,也没有遗漏。但截至作者在 2026 年 8 月检查时,它只有三天里的九次运行,几乎都没复核,因此开关继续关闭。
这个门槛发挥作用的方式很朴素:证据不够,就不上线。
为什么三个例子全对,换成 24 个就露馅
作者也检查了自己的测试,发现不少只是「看起来做了评估」。
快速检查确认了全部 44 个命令已经接通,但标题检查比对的是他手写进测试的文本,没有检查命令真实输出。最初的 AI 裁判只看生成回复,看不到原始消息,因此只能评语气和格式,不能判断事实。
另外六个标注场景,包括明确承诺、隐含承诺、已完成事项、群聊噪声、多人对话和沉寂对话,虽然写进文件,却没有被任何代码读取。!correct 能记录提取出错的原因,也没有把记录送回评估器。
有文件、有命令、有分数,都不等于检查真正生效。
为了避开私人聊天,作者另做了 24 个合成用例。每例包含一到三个聊天,人工写好预期结果;合计 17 条应提取事项,另有九个用例应该返回空结果。覆盖范围包括普通提问、没有问号的请求、印地语和英语混用的 Hinglish、问别人的群消息、已经回复的请求、已经兑现的承诺,以及反问句。
比较的两个 prompt 中,v1 对「等我处理」和「我的承诺」定义较含糊;v2 明确要求提取尚未回复、指向自己的问题或请求,识别包括 Hinglish 在内的承诺,并排除陈述、反问、问别人的问题和已完成事项。
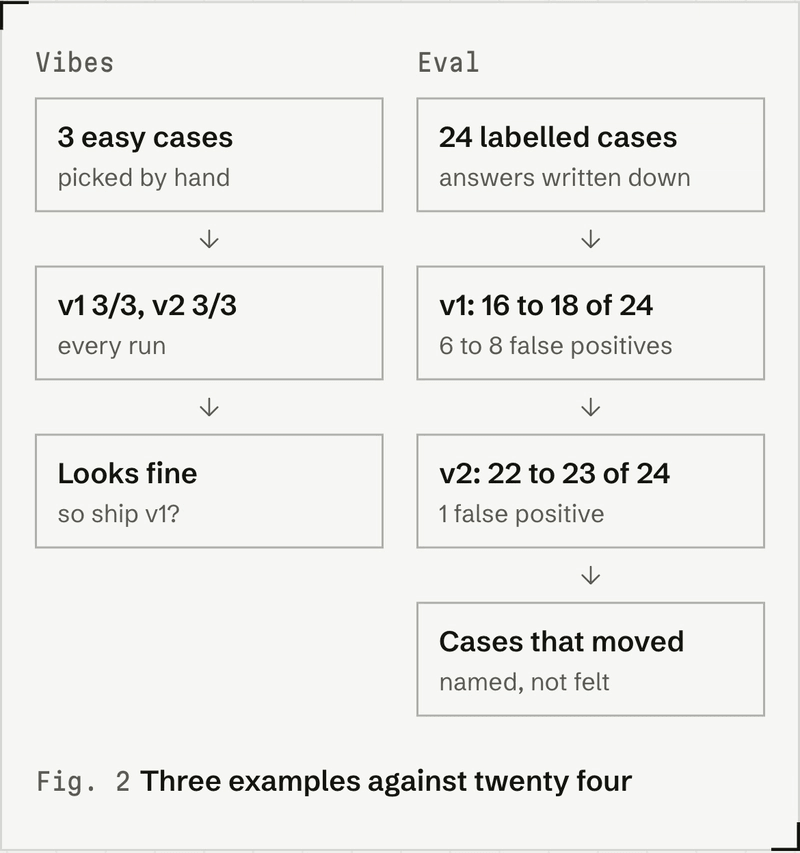
作者通过 Groq 调用 openai/gpt-oss-120b,重复运行三次:
| 检查范围 | v1 | v2 |
|---|---|---|
| 三个简单用例 | 每次都是 3/3 | 每次都是 3/3 |
| 全部 24 个用例 | 通过 16 到 18 个 | 通过 22 到 23 个 |
| 误报数量 | 每次 6 到 8 条 | 每次 1 条 |
通过标准很严格:预期事项必须齐全,不能多报,类型必须正确,引用还要通过证据检查。一条错误发现,就可能让整个用例失败。
v1 把已经发送发票后的催发票请求继续列为待办,也把抱怨 Bengaluru 交通的反问当成需要回答的问题。v2 改善了整体结果,但三次都没识别对那句反问,还在其中一次漏掉了 v1 能识别的 Hinglish 承诺。
固定用例的价值就在这里:能指出修好了什么、还错什么、又弄坏了什么。
AI 裁判为什么会给错误答案放行
公开实验里的裁判比早期版本多看了原始聊天。它针对每条提取结果判断通过或失败,并解释理由。作者随后把裁判结果与人工标签比较。
结果是,每次 v1 运行都有六条人工判错的发现被裁判放行;它没有否决任何被评审的正确发现。对于损坏的 API 文档链接,裁判认为用户需要回应或修复;对于交通反问,它认为对方合理期待回复。理由都通顺,却与作者定义的任务边界不一致。
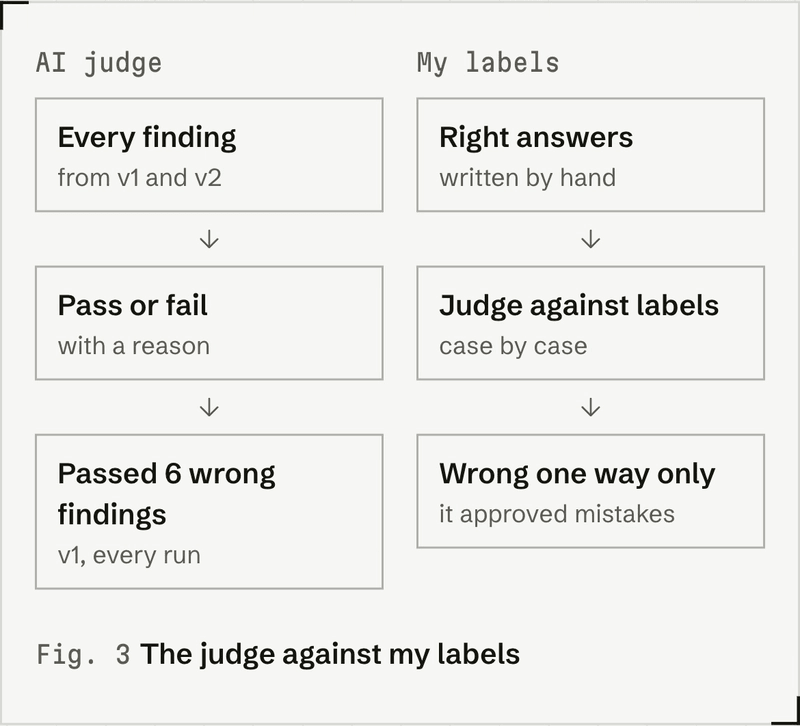
这里还有一个更容易忽略的限制:裁判只看模型已经提取出来的事项。模型漏掉一个承诺,裁判根本收不到它,自然无法指出遗漏。因此,裁判的同意率不能当作 prompt 的第二份总分,更不能当作召回率。召回率关心的是:所有本该找出来的事项,究竟找到了多少。
原文引用的 2023 年 LLM as a judge 研究还讨论了位置、篇幅和自我偏好等偏差;作者据此强调,要用自己任务的人工标签校准裁判,并检查分歧。
解释听起来合理,只能说明裁判给出了理由,不能替代正确性证据。
我的判断
我赞成作者把确定性检查放在前面。引用是否存在、发送者是否匹配、JSON 是否有效,都有明确答案,交给代码更容易追查。语义边界不清的地方,再引入人工标签或经过校准的模型裁判,这个分工适合日常 AI 功能。
但「待办」本身带有产品判断。「API 文档链接坏了」到底只是陈述,还是隐含请求,取决于助手的服务范围。人工标签也需要讨论,不能因为写进测试文件就自动成为真理。
实验的证据范围同样有限:24 个合成用例、一个模型、三次运行,只能说明两个 prompt 在这组数据上的表现。没有真实聊天的对照结果,就不能认定 v2 在生产环境一定更好。七天零错误、零遗漏的上线门槛,也没有对照数据证明适合一般团队,应视为作者的经验选择。
工具信息则属于迁移背景。按原文所述,OpenAI 托管 Evals 平台于 2026 年 10 月 31 日对现有用户转为只读,仪表盘和 API 计划于 11 月 30 日关闭;迁移指南指向 Promptfoo。Promptfoo 在 2026 年 3 月宣布已同意被 OpenAI 收购,并表示将保持开源。另一选择是 UK AI Security Institute 与 Meridian Labs 开发的 Inspect AI。
这些日期属于原文信息,本文未另行核验。作者引用的 LangChain 调查中,52.4% 的受访组织运行离线测试集评估,也只代表该调查样本。
对普通开发者,最有参考价值的是启动成本:作者的 demo 只有 JSONL 文件、两个评分器和一个循环,TypeScript runner 没有包依赖。实际调用模型仍需提供方 API key,并遵守其调用限制。
能拿来做什么
- 给已有的 AI 提取功能整理首批 20 到 50 个用例,这是原文转述的 Anthropic 建议。优先收集真实失败,脱敏后手写预期答案,保留「应该什么都不返回」的负例,不要只收集成功示范。
- 在 Node 或 TypeScript 流程里先补确定性检查,例如 JSON 格式、消息归属、引用与时间匹配。具体规则尽量给出通过或失败,让失败结果直接指出需要修复的地方。
- 每次修改 prompt 或切换模型都运行固定集合,保留历史失败用例,并留出一部分不参与调参的留出集。对比哪些用例发生变化,避免只看总分;反复用同一批题改 prompt,也可能只是把答案调熟了。
- 把用户纠错接回评估流程,并定期审查 AI 裁判与人工标签的分歧。若裁判只检查已返回条目,就另外通过完整预期答案检查遗漏,别让一份看似漂亮的评分遮住盲区。