HyperPod托管扩展简化Slurm集群运维
Amazon SageMaker HyperPod 为 Slurm 集群新增可观测性和用户管理托管扩展,可通过声明式配置、API 和控制台管理节点软件。文章结合共享集群一个季度的运行场景,解释扩展的使用方式。
AI 深度解读
共享 GPU 集群最难维护的,往往是那些散落在脚本、配置文件和用户清单里的状态:新节点装了什么,旧节点有没有更新,谁还能 SSH 登录,监控为什么突然断了。AWS 这次给 HyperPod Slurm 增加的 cluster extensions,就是把其中一部分交给持续维护的声明式配置。
它的价值不在于少写几行安装脚本,而在于提交后有人负责校验、分发和报告健康状态。不过,这是一套特定平台上的托管能力。原文展示了工作机制和故障示例,没有给出效率、成本或稳定性的对照实验。
为什么已经有 AMI 和脚本,还需要扩展
原文把 Slurm 集群拆成六层:集群定义、节点初始化、容量、网络拓扑、硬件健康,以及节点上持续运行的软件。2026 年已有的能力,主要覆盖前五层。
例如,管理员可以在 CreateCluster、UpdateCluster 中声明节点角色、分区、Amazon FSx for Lustre 和 Amazon FSx for OpenZFS 挂载,以及外部 accounting 数据库。AMI 预装 Slurm、Docker、Enroot、Pyxis 和用户主目录相关配置,组织自己的软件则交给 custom AMI 或 OnInitComplete。
容量不足时,continuous provisioning 在后台继续申请,MinInstanceCount 指定最低可用数量。原文的场景是申请 8 个 GPU 节点,至少 6 个就能开始运行,剩余节点继续补齐并接受健康检查。Slurm 25.11 及以上还支持按分区设置 tree 或 block 拓扑;GPU 压测与 NVIDIA Collective Communications Library(NCCL)连通性检查期间,节点留在维护预留中,不接作业。
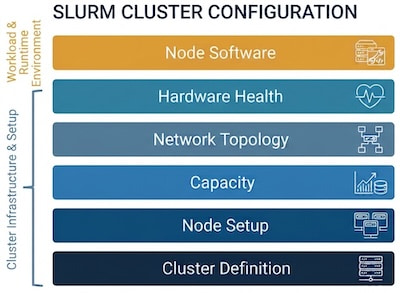
但运行中的软件会不断变化:研究人员加入或离开、exporter 修复发布、某次排查临时需要更细的 GPU 指标。生命周期脚本通常在节点创建时执行,后续变化需要重新分发执行,或者替换节点,脚本本身也不提供持续的安装状态报告。
初始化成功,只能证明当时执行过,不能证明整个集群一直保持一致。
2026 年 11 月推出的扩展,针对的就是这段持续维护工作。HyperPod 仍保留所有节点,包括 controller 的 SSH 访问和直接配置权限,并没有取消管理员的控制权。
扩展真正接管的是哪些维护工作
原文提供两种扩展:sagemaker-observability 收集节点、GPU、Elastic Fabric Adapter(EFA)、Slurm 作业与集群指标;sagemaker-user-management 管理统一的用户和组 ID、SSH 与 sudo 权限,并对接 Slurm accounting,也支持 Active Directory。
工作流程是:通过 API 或 SageMaker AI 控制台声明版本和配置,HyperPod 先按该版本的 schema 校验,再记录期望状态,由节点 agent 应用。各节点只安装角色需要的组件,例如 GPU 节点上的 DCGM、EFA exporter,以及 controller 上的 Slurm 集群指标组件。新增或替换节点启动几分钟后也会取得相同配置。
配置更新采用合并方式,只提交要修改的字段。下面的命令用于临时打开更深入的 GPU 与 NCCL 指标:
aws sagemaker update-cluster-extension \
    --cluster-arn {{cluster-arn}} \
    --extension-arn {{observability-extension-arn}} \
    --configuration-values '{"metricsProvider":{"acceleratedComputeMetrics":{"level":"ADVANCED"},"ncclMetrics":{"level":"ENABLED"}}}'
要看的是 --configuration-values:它提交的是局部变化,HyperPod 只重启配置受影响的组件。排查结束后,把这两个配置项设为 null 可恢复默认值,无须替换节点。
状态反馈也比安装脚本明确。变更期间是 Creating 或 Updating;全部节点满足请求且没有报告问题时是 Active;部分节点失败或报告问题时是 Degraded。DescribeClusterExtension 的 Health 按原因聚合错误,给出代码、消息和受影响节点数量。
原文用一个权限故障说明它能提供的信息:
{
    "NodeSummary": { "TotalCount": 19, "ActiveCount": 11 },
    "Health": {
        "Issues": [
            {
                "Code": "ExtensionUnhealthy",
                "Message": "otel-exporter-health: no successful exports in 5m6s",
                "NodeCount": 8
            }
        ]
    }
}
这里应先看 NodeCount: 8 和导出失败消息。示例中的新实例组缺少 aps:RemoteWrite,补齐权限后恢复健康,无须重装。内部故障由 HyperPod 自动重试;其他问题修复后,可以不带配置变化调用 UpdateClusterExtension,重试受影响节点。
监控和账号托管都有明确的使用边界
监控数据可以发往 Amazon CloudWatch 或 Amazon Managed Service for Prometheus,也可以接入 Amazon Managed Grafana。预建的 Clusters 看集群、节点、GPU、EFA 与主机状态,Jobs 按作业关联 CPU、内存、GPU、磁盘 I/O、加速器与 NCCL 指标,帮助定位闲置 GPU、卡住的作业和通信瓶颈。
账号管理则支持本地用户、通过 LDAPS 接入的 Active Directory,或者两者并用。配置中的 sharedFilesystemMount 指向共享主目录位置,例如 /fsx;用户通过 username、uid、groups 声明,组通过 gid、ssh、sudo 和 nodeTypes 控制权限,节点类型包括 controller、login、compute。目录接入还涉及 ldapUri、查询基准、绑定身份和证书等配置。
安装后,只有明确授予 SSH 权限的组以及默认 ubuntu 用户可以登录。合作实验室的本地用户保持统一 ID 和主目录,并使用默认 Slurm root account;这里的 accounting 账户与 Linux root 用户不是一个概念。
启用条件也不能略过:需要 2026 年 11 月 2 日及之后的 HyperPod AMI,并开启 continuous provisioning。用户管理还需要共享文件系统。
扩展以 root 身份运行,因此 CreateClusterExtension、UpdateClusterExtension、DeleteClusterExtension 应视作管理员权限。原文建议不要把它们授予集群 execution role,因为能登录节点的用户可以使用该角色凭证。这个角色仍需具备数据目的地访问权限,例如 aps:RemoteWrite、读取目录密钥的 secretsmanager:GetSecretValue,使用客户管理 KMS 密钥时还需要 kms:Decrypt。
迁移也不是点一下安装就结束。原文要求先用 UpdateClusterSoftware 升级到 2026 年 11 月 AMI 或更新版本,再关闭生命周期脚本中的对应能力并上传 S3;随后在维护窗口停止、移除所有节点上旧脚本安装的 agent,最后调用 CreateClusterExtension。
同一个 exporter、用户或服务,应当只有一套配置负责管理。
组织专用的安全 agent、许可证服务、存储布局仍适合放在 custom AMI 或生命周期脚本里。两种机制可以共存,但不能互相争抢同一个组件。
我的判断
我认可这套方案对配置漂移的处理:校验不再等到脚本跑上节点才发生,新增节点也不必依赖管理员记得补装,故障还能按组件和节点数量集中呈现。对已经使用 HyperPod Slurm 的团队,这些是直接相关的运维改进。
但原文的平台团队是用于说明功能的场景,不是完整的生产实测报告。它没有提供人工投入、故障恢复时间、采集开销或费用的前后对比,也没有展开大规模升级失败后的回滚行为,不能据此断言托管扩展必然更便宜、更稳定。
与团队自己维护配置管理工具、agent 和监控部署相比,扩展能减少对应组件的维护工作,代价是接受 AWS 提供的能力和配置边界。独立版本升级允许不更新 AMI 就升级扩展,新版本也会先校验已有配置;不过输入原文在升级流程末尾截断,后续异常处理并未交代清楚。
能拿来做什么
- 如果团队已有 HyperPod Slurm,先盘点监控和账号分别由哪些脚本、AMI 或人工操作维护,选一项能力迁移,并把旧组件清理纳入维护窗口。
- 如果经常排查训练任务,优先确认指标能否关联到具体 Slurm job,再决定是否临时开启
ADVANCED和 NCCL 指标,避免只有机器总览却找不到具体作业。 - 如果负责平台控制台或 Node 运维服务,可以借鉴其状态表达:区分提交校验、应用进度和运行健康,并返回错误原因与影响范围。
- 如果维护共享 AI 开发环境,应分别审查 Linux 登录权限、sudo、Slurm accounting 和 AWS execution role,避免把创建账号误当成权限配置已经完成。