单卡运行编程模型:量化后的任务表现
作者报告,POCKET-27B-Pi 的 Q4_K_M 文件为 16.5GB,可在单张 24GB 显卡运行,在相同设备与时限下完成 48 项共同测试中的 28 项,高于两个对照版本。文章围绕响应速度、代理步骤数与任务完成率解释量化收益,并提供模型地址及运行说明。
AI 深度解读
16.5GB 的模型文件,在同一块显卡上,竟然比 53.8GB 的原精度模型完成了更多编程任务。POCKET-27B-Pi 给出的解释是:编程 Agent 的成绩既取决于模型会不会做,也取决于它能否在截止前完成读取、执行、检查和修正。
这组结果值得看,但不能直接理解为「量化让模型更聪明」。它展示的是模型、推理速度和 Agent 工作方式共同形成的收益。对想在本地部署编程助手的团队,更有用的问题是:该选哪个文件,以及怎样复测才能避免被一个分数带偏。
小文件为什么能多做出几道题
作者报告,在 Terminal-Bench 2.1 四个版本共同完成评估的 48 道任务中,POCKET-27B-Pi Q4_K_M 完成 28 道,解决率为 58.3%;原始 Qwen3.8-27B 完成 19 道,为 39.6%;53.8GB 的原精度 pi 模型完成 21 道,为 43.8%。
所谓提升 47% 和 33%,指的是完成数量的相对增幅,不是解决率增加了同样多的百分点。16.5GB 的文件则约为 53.8GB 的三分之一。
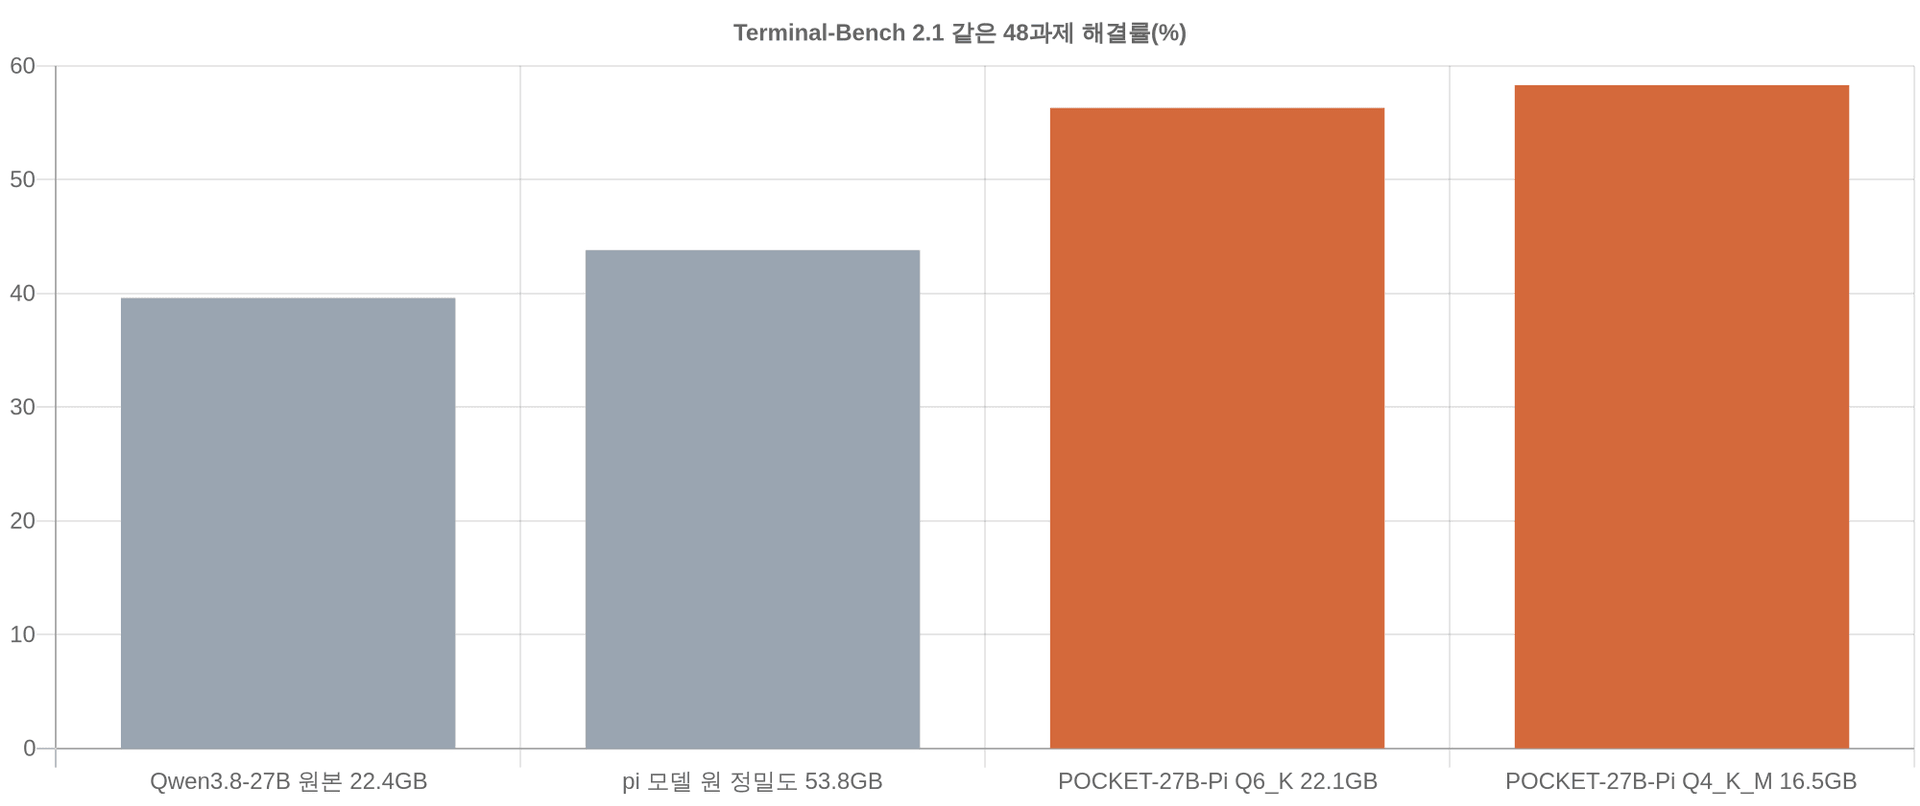
关键在评测条件:每题只尝试 1 次,限时 1 小时,同时运行 8 个会话,全部关闭思考功能。
编程 Agent 要反复读文件、调用命令、查看结果,再决定下一步。模型每次响应慢一点,整个循环就多等一次。在固定时间内,推理速度会影响任务能否完成;8 个会话共享显存带宽时,文件大小也可能影响吞吐。
这里比较的是限时 Agent 系统的任务完成能力,不能据此断言低精度模型的单次回答更准确。
另外两组数据需要分开看:两两比较的共同 50 题中,Q4_K_M 完成 30 题,原精度原版完成 23 题;Q4_K_M 与 Q6_K 在共同 62 题中都完成 39 题。不同题集不能混成一张排行榜,后者也只能说明这组任务没有测出两种量化版本的完成数量差异。
少走步骤,可能比每步更快更重要
POCKET-27B-Pi 并非只把 Qwen3.8-27B 压小。按照原文,它合并了 Hugging Face harness 团队公开的 pi 编程 Agent 适配器,再进行量化。适配器通过验证器奖励进行强化学习,合并后不再需要单独加载。
适配器作者公布的原精度成绩是:SWE-bench Pro 高难度 51 题从 39.2% 提升至 64.7%,Terminal-Bench 2.1 从 39.5% 提升至 55.8%;关闭思考后,仍可达到原模型最高强度思考模式的水平,每题生成字符量约为原来的 1/4.5。这些是适配器作者的报告,不能当作量化版本的新测量。
原文另一组共同 50 题的比较中,POCKET-27B-Pi 每题 Agent 步数中位数为 15,原始权重版 POCKET-27B 为 36.5;前者没有一次触及 100 步上限。
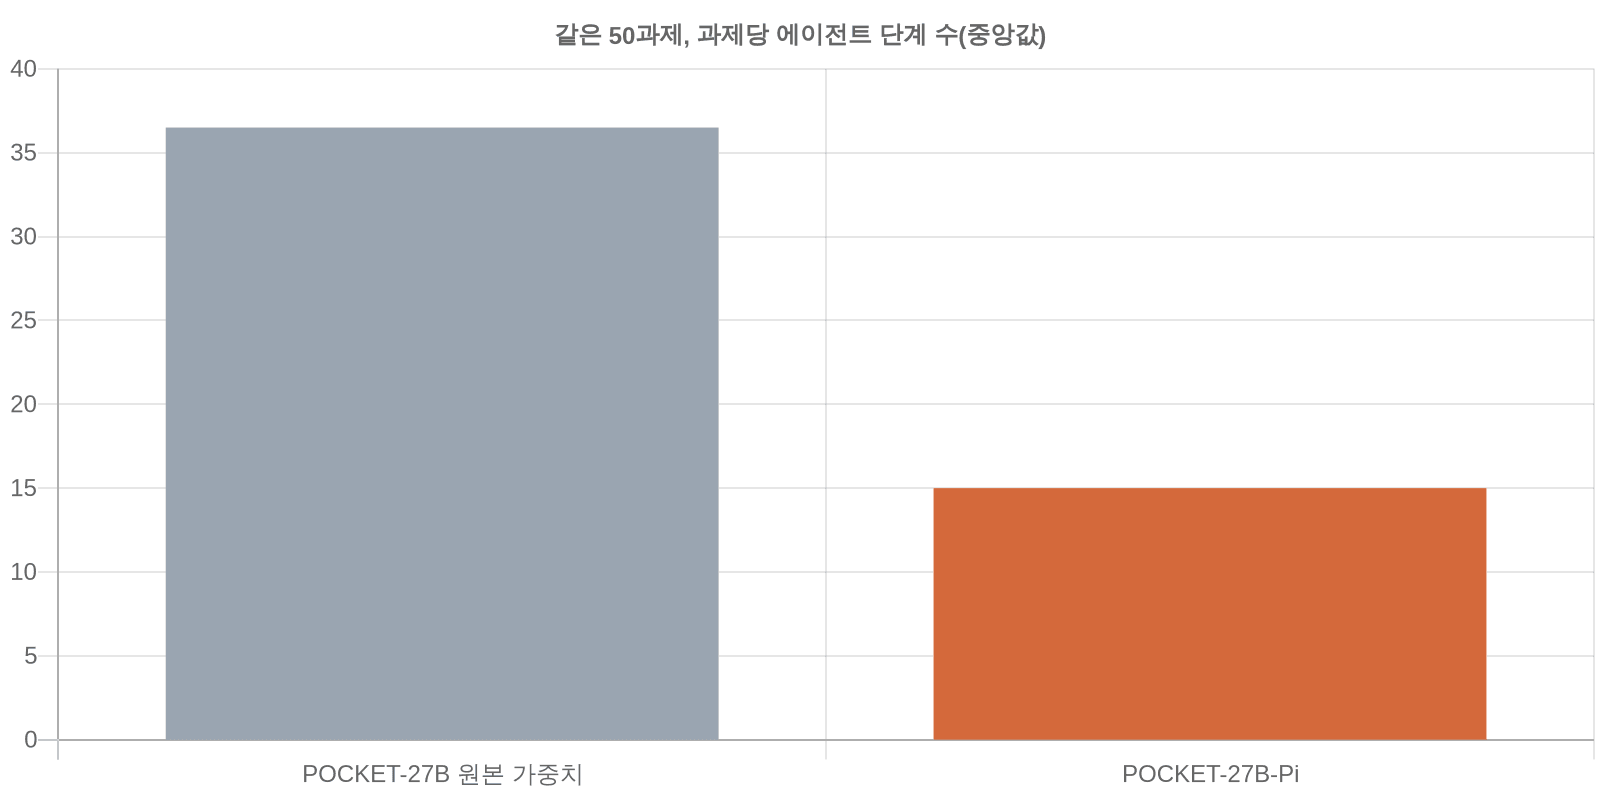
少几次循环,就少几次模型等待和工具调用,也可能减少重复读取历史上下文的开销。但步数不是费用账单:每步生成长度、上下文长度和工具耗时都可能不同。
原文用每步 250 token 估算出 9125 与 3750 token,又用 3600 秒预算、每步 60 秒和 40 秒推算出 60 与 90 步。这两段都是解释机制的假设计算,不能引用为实测吞吐或成本。
24GB 显卡该选哪个版本,怎样接入
Q4_K_M 文件为 16.5GB,Q6_K 为 22.1GB。原文建议,24GB 显卡优先考虑 Q4_K_M,为上下文缓存留出空间;示例配置的上下文窗口为 65,536 token。
这里要区分文件大小和运行显存。权重之外,还要容纳 KV 缓存及运行开销。原文没有给出完整显存曲线,不能把「24GB 可运行」扩展成任意并发和上下文长度都能装下。
以下命令启动 llama.cpp 的 llama-server,并沿用模型卡的采样与思考设置:
llama-server -hf FINAL-Bench/POCKET-27B-Pi-GGUF:Q4_K_M -ngl 999 -c 65536 --port 8080 --alias pocket-27b-pi --temp 0.8 --top-p 1.0 --top-k 0 --min-p 0 --chat-template-kwargs '{"enable_thinking":false}'
要留意 -c 65536 和 enable_thinking:false:前者影响缓存需求,后者对应文中的评测条件。
接着在 ~/.pi/agent/models.json 添加本地服务,让 pi 通过兼容接口调用模型:
{
  "providers": {
    "local": {
      "baseUrl": "http://localhost:8080/v1",
      "api": "openai-completions",
      "apiKey": "dummy",
      "models": [{ "id": "pocket-27b-pi" }]
    }
  }
}
这里的 "api": "openai-completions" 是接口配置,baseUrl 指向本机。随后可执行原文示例:pi --provider local --model pocket-27b-pi --print "tests/test_parser.py 테스트가 왜 실패하는지 찾아서 고쳐 줘.",要求 Agent 排查并修复测试失败。
原文称材料与产物均采用 Apache-2.0,下载后可离线运行。它属于 POCKET 产品线,同系列还有面向数学科学推理的 POCKET-Darwin-180B、面向笔记本和手机的 POCKET-35B,以及面向多语言对话的 POCKET-26B。
我的判断
我认可它把模型选型从「参数和分数」推进到「完成数量、步骤和等待时间」。对实际跑任务的团队,这比只比较聊天回答更有参考价值。
但「更小所以更快,因此完成更多」仍是机制解释。原文没有提供足够的逐步延迟、显存占用和超时明细,无法拆清量化、适配器训练和部署方式分别贡献多少。53.8GB 权重如何放到同一块 24GB 显卡上运行,原文也没说清,这会影响速度比较。
共同完成评估的 48 题让分母一致,却没有交代被排除任务的原因和完整表现。每题一次也无法展示重复运行的波动。作者还用自测原始权重版 38.0% 接近适配器作者的 39.5%,推断起点相近;这可以作为线索,不能证明两套评测等价。
因此,它支持的是特定硬件和限时条件下的选型方向。与直接使用原精度模型相比,Q4_K_M 展示了部署效率优势;与云端编程助手相比,文章没有给出对照数据。本地部署能控制推理请求的去向,但 Agent 调用的联网工具仍需另行检查。
能拿来做什么
- 有 24GB 显卡的团队,可以先用 Q4_K_M 跑固定的一组仓库修复任务,再决定是否尝试 Q6_K;不要只凭文件名判断质量。
- 比较模型时,固定题目、每题 1 次、1 小时、关闭思考、8 会话及采样参数,同时记录完成数、步数中位数和触及上限的次数。
- 排查 AI 编程助手效率时,把「每步等待太久」和「反复走错路」分开记录,分别判断推理部署与 Agent 行为需要怎样调整。
- 需要代码留在内网时,可以按示例接入本地 pi 服务,并检查命令、依赖下载和其他工具实际访问了哪些地址。