Mercury 3 发布,主打低延迟语言生成
Inception 宣称扩散语言模型 Mercury 3 比 GPT-6 Luna 和 Claude Haiku 5.5 快四至八倍,并在十二项基准中的八项领先。目前尚无独立测试支持这些比较。
完整中文译文
Mercury 3 想挑战的,是语言模型逐个生成 token 的速度限制。Inception 宣称,这款扩散语言模型能以每秒超过 1,000 tokens 的速度输出,并在自家测试的 12 项基准中赢下 8 项,对手包括 GPT-6 Luna 和 Claude Haiku 5.5。
对做 AI 应用的程序员,这条消息的价值在于:多步骤 Agent 的等待可能缩短,实时交互也可能有新的选择。不过,速度、质量和价格需要分开看,目前最亮眼的数据仍来自厂商及其早期合作伙伴。
一次修改整份答案,为什么可能更快
GPT、Claude 这类常见模型采用自回归生成:每个新 token 都依赖前面的结果,需要依次推进。token 是模型处理文本的单位,并不严格对应一个汉字或一个英文单词。
Mercury 3 使用扩散路线。按原文的解释,它先形成整份答案的粗略版本,再经过多轮修改,同时处理多个位置的内容。可以把它理解为先铺出全文,再反复修订。图像生成里常见的扩散思路,被用到了文本生成上。
Inception 报告,Mercury 3 在 Nvidia GPUs 上达到每秒 1,068 tokens;同一份比较中,Claude Haiku 5.5 约为 240,GPT-6 Luna 约为 130。厂商因此宣称速度快了 4 至 8 倍。
输出吞吐量更高,不代表用户等待时间会按相同比例缩短。
请求传输、输入处理、工具调用都可能占用时间。原文没有交代完整的硬件配置和测试条件,也明确表示尚无独立测试,因此这些数字适合用来筛选候选模型,还不足以直接预测线上延迟。
Inception 还称,Mercury 3 的参数量超过 Mercury 1 的 40 倍,却保持相同速度;相较更小的 Mercury 1 mini,性能提升了 3 倍。不过,准确参数量没有公开,原文也没说清「性能提升」对应哪个具体指标。
赢下八项测试,能替代现有编程模型吗
先看测试条件:三款模型都使用 medium 设置,数据来自 Inception 内部。
Mercury 3 最突出的优势之一是指令遵循。IFBench 得分为 76.84,比 GPT-6 Luna 高约 15 分。在自主编程测试 SWE-Bench Atlas 上,它得到 51.08 分,两个对手分别为 33.33 和 32.26 分。
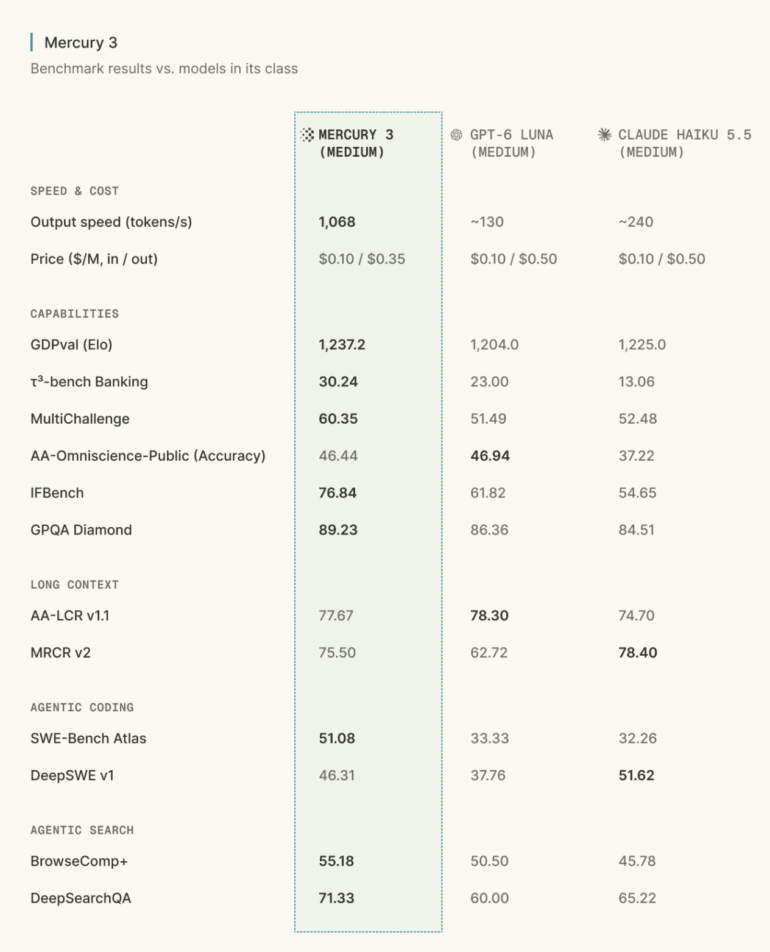
但更长程的编程测试 DeepSWE 由 Claude Haiku 5.5 获胜,长文本信息检索也是它更好。GPT-6 Luna 则在 Artificial Analysis 的两项测试中略微领先。
这组结果不能支持「编程任务全面领先」。修一个局部问题、跨多个步骤修改项目、从长文档中找约束,考验的是不同能力。Mercury 3 支持最多 100 万 tokens 的上下文,也不能据此认定它更擅长利用这些内容。
TinyFish AI 的合作反馈同样需要留出判断空间:Mercury 3 在真实网站的 50 个导航任务中完成了 25 个,联合创始人称其超过 GPT-6.1-Sol,却没有给出后者的成绩。这个结果提供了可测试的方向,但缺少完整对照。
哪些应用能真正用上速度优势
Inception 面向的场景包括 Agent、搜索、客服、辅导和智能眼镜。它们的共同点是用户对等待敏感,或者一次任务需要反复请求模型。
Agent 尤其如此。读取页面、决定操作、调用工具、检查结果,每一步都可能等待模型。单次调用省下的时间不多,累积起来就可能影响整个任务的体验。
智能眼镜搜索公司 Octen AI 给了一个更具体的案例:搜索本身只需约 80 毫秒,语言模型才是瓶颈。接入 Mercury 3 后,响应中位数为 0.9 秒,全流程耗时 2.2 秒。创始人认为,在眼镜上等 5 秒才拿到答案,会让用户觉得产品出了问题。这里的 0.9 秒和 2.2 秒是不同口径,不能混为一个响应时间。
General Learning 表示,给学生提供提示和纠错约需 1 秒;Lorikeet 则报告响应更快、结果更好,但原文没有提供具体幅度。这些属于合作伙伴反馈,并非独立评测。
接入方面,Mercury 3 提供 OpenAI-compatible API,可通过 Inception、OpenRouter、Baseten 和 Vercel 使用。接口兼容降低了迁移起点,但原文没说明所有参数和行为是否一致,现有调用代码仍需验证。
常规定价为每百万输入 tokens 0.20 美元、输出 tokens 0.70 美元,首发减半,结束时间未公布。优惠结束后,短输入场景下,它的输出单价高于两款对手的 0.50 美元;超长输入场景中,对手收费则高得多。
我的判断
我更看好它作为低延迟场景的候选模型。原文呈现出的优势集中在吞吐量、指令遵循和部分自主编程任务,尚不足以支持团队全面迁移。
扩散路线也有其他参与者。Google 在 Gemini Diffusion 演示后,于 6 月推出开放模型 DiffusionGemma,称其速度最高为标准 Gemma 4 的 4 倍,但效果略弱。Inception 则在 2 月发布 Mercury 2,称它能在作答前进行中间步骤推理。它此前融资 5,000 万美元,投资方包括 NVentures、M12 和 Snowflake Ventures。这些信息说明路线受到投入,不能代替 Mercury 3 的独立验证。
与更换模型相比,减少无效调用、压缩冗余上下文也值得纳入同一轮比较。原文没有这些方案的对照数据,因此不能认定换模型就是最划算的提速办法。
更有用的判断标准,是完成一次合格任务需要多久、花多少钱。
首发优惠、单项跑分和每秒输出量,都只能解释其中一部分。
能拿来做什么
- 如果正在做网页操作 Agent,可以拿一组固定导航任务比较 Mercury 3 与现有模型,同时记录完成率、总耗时和重试次数,检验速度优势能否保留下来。
- 如果 Node 服务已经使用 OpenAI 风格接口,可以先接入一个测试环境,核对现有参数和响应处理是否兼容,再评估客服、搜索等链路的实际等待时间。
- 如果主要处理长文档或复杂编程任务,应分别验证信息检索和持续修改能力,并按每百万输入 0.20 美元、输出 0.70 美元的常规价格估算成本。