直接改模型权重,哪些场景能奏效
作者让 AI 编程 Agent 检查并修改六类模型的权重,通过留出数据测试并记录版本。实验称传统模型和小型网络更容易取得效果,小型语言模型虽能定位行为成因,稳定修改仍有困难。
AI 深度解读
模型出了问题,除了补数据、重训,还能直接修改权重。作者让 AI 编程代理充当「模型工程师」,在逻辑回归、小型神经网络、梯度提升树、RL 智能体、CNN 和小型 LLM 上做实验:先定位错误来源,再写补丁,用新数据验证,最后保留可撤销的修改记录。
结果有边界:传统模型和小模型的一些局部行为确实能修;到了 LLM,找到相关方向不等于能写出稳定补丁。对程序员最有用的,是它把模型维护变成了一套接近代码维护的流程。
不用标签,能先写出一个可用模型吗
作者受 MIT CSAIL 的《Sparks of Weight-Space Programming》启发,尝试让 AI 直接读写模型参数,绕过梯度下降。第一个实验更激进:不给标签,也不训练,让 AI 根据已有知识写模型。
任务是利用今天的气压、气压变化、湿度、云量、风和降雨,预测欧洲 10 个城市明天是否降雨 ≥ 1 mm,数据来自 Open-Meteo。测试期设在 2026 年 7—10 月,作者称其晚于 AI 的知识截止时间,用来降低记住答案的可能。
AI 只能查看无标签特征的分位数,例如用 p20 表达低气压,而不是凭空猜一个 hPa 阈值。它写出的树带有解释,下面这段把气压变化转成预测贡献:
{"why": "falling barometer = low approaching; rising = high building",
 "if": ["pressure_change_24h", "<", -3.4],
 "then": {"if": ["pressure_change_24h", "<", -7.2], "then": 1.1, "else": 0.6},
 "else": {"if": ["pressure_change_24h", ">", 3.4], "then": -0.7, "else": 0.0}}
要看的是 then、else 返回的数值:它们是模型贡献值,不能直接当成降雨概率。一个小型编译器会把这些规则转成标准 XGBoost 模型文件,由原版 XGBoost 加载。
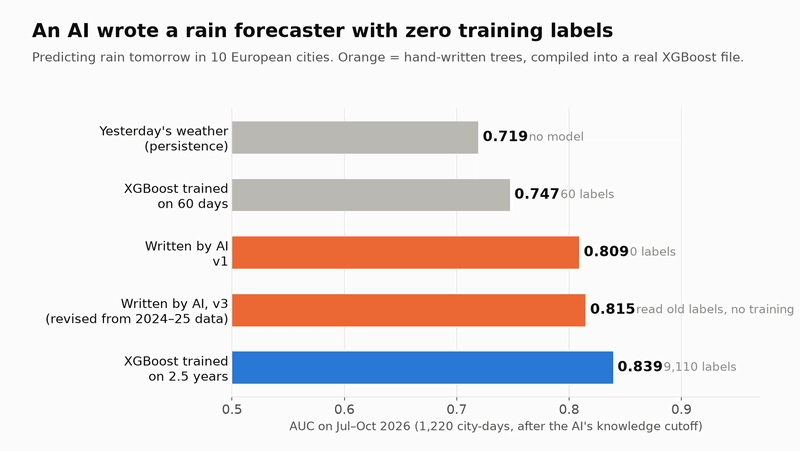
零标签模型 AUC 为 0.809;用 2.5 年、9,110 个带标签日样本训练的 XGBoost 为 0.839;用 60 个带标签日样本训练的版本为 0.747;直接预测「明天和今天一样」为 0.719。AUC 衡量排序能力,不能读成预测正确率。
以最后一个基线计算,手写模型拿到了长期训练所带来增益的约 75%。但训练基线没有调优,作者也承认,调优可能拉大差距。
第二轮允许 AI 阅读 2024—25 年标签作诊断,再于 2026 年 1—6 月验证,最后只运行一次最终测试。AUC 从 0.809 升至 0.815,log-loss 从 0.493 降至 0.479。期间还发现分析脚本把 log-odds 当概率求平均,促成了校准修正。这一轮已经使用标签反馈,不能再视为完全零标签。
乳腺癌数据集上的手写模型也达到 AUC 0.972,训练模型为 0.985,但存在数据记忆风险。更有价值的结论是:在标签稀缺的第一天,领域知识可能先撑起一个可测量的模型。
局部修补为什么能成功
作者的实验都遵循同一流程:检查哪些输入和单元推动了错误,修改少量权重或增加规则块,再用未参与修改的新数据比较修改前后,并按业务分组检查回退。
规则块是一个带条件开关的小网络,只在条件满足时介入。补丁与基础模型分开保存,当前模型由「基础模型 + 生效补丁」组成。
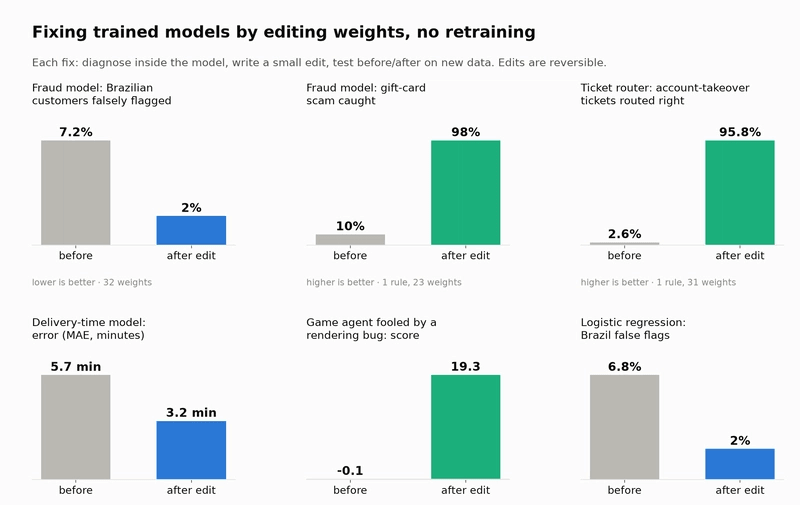
几个结果很直观:
- 欺诈模型把巴西雷亚尔 BRL 交易学成风险高出 3.9×,近期数据却只有 1.2×。修改 32 个权重后,BRL 误报率从 7.2% 降到 2.0%,整体 AUC 从 0.817 升到 0.837。
- 新骗局满足「礼品卡 AND 金额 > $500」。作者新增输入和规则块,共涉及 23 个权重,检出率从 10% 升到 98%,实验中规则范围外的输出没有变化。
- 一个 4 类 PyTorch 工单路由模型沿用旧政策,把企业技术工单交给客户经理,也漏掉账号接管工单。两份补丁让接管工单正确路由率从 2.6% 升到 95.8%;其他工单输出变化小于 1e-7,没有其他预测类别翻转。
这些结果的适用前提很重要:欺诈、路由和配送时间模型来自作者生成的合成数据,缺陷经过人为设计,正确行为也是已知的。它们证明方法能处理特定错误,还不能证明能在真实业务里稳定复现同样收益。
树模型最容易修改,可以调整分裂阈值,让某个特征失效,也可以追加手写树。修改后的 XGBoost JSON 仍能由原版 XGBoost 加载。
RL 实验则修复了一种特殊依赖:接球智能体学会跟随渲染错误产生的落点阴影。阴影移除后得分跌到 −0.1;作者补入根据球的位置和方向计算落点的小电路,得分恢复至 +19.3,接近原来的 +19.4。这是恢复熟悉的输入关系。作者也承认,重训这个玩具任务同样便宜。
删掉坏习惯,不会自动长出新能力
移除错误依赖,不等于模型已经学会正确能力。
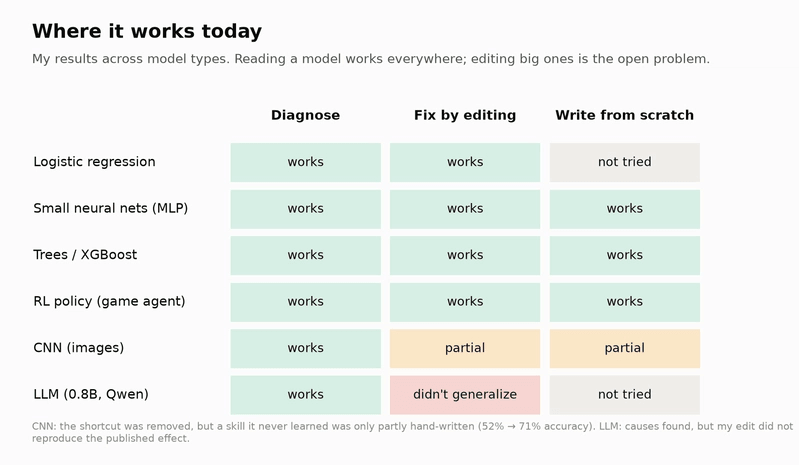
CNN 实验最能说明这一点。模型靠与类别相关的相机印记分类,清零 32 个权重后,捷径完全消失,准确率却停在 52%。因为它原本就没学会识别真实形状。再手写一个涉及 40 个权重的直边检测器,准确率也只恢复到 71%。
作者还踩过几个实现层面的坑。把偏置货币对应的行为改成「所有货币的平均」失败了,改成真实可比货币 USD 的行为才成功,因为非线性单元不能简单取平均。大权重也不一定最影响行为,仍要靠数据测试。
更隐蔽的问题是模型结构。导入含 BatchNorm 的 PyTorch state_dict 时,猜错层顺序也可能成功加载,却静默地产生错误结果。作者因此让工具在结构不明时拒绝继续,要求提供布局。
LLM 的结果更克制。作者验证了 MIT 发布的 Qwen3.5-0.8B 补丁,它让结束推理 token 的概率提高约 29×。但作者在笔记本上对 0.8B 模型自行寻找补丁时,虽然找到了与停止推理相关的方向,并自动选出搜索集上效果最强的三层,独立测量中却只提高到 1.2×,几乎没有实效。
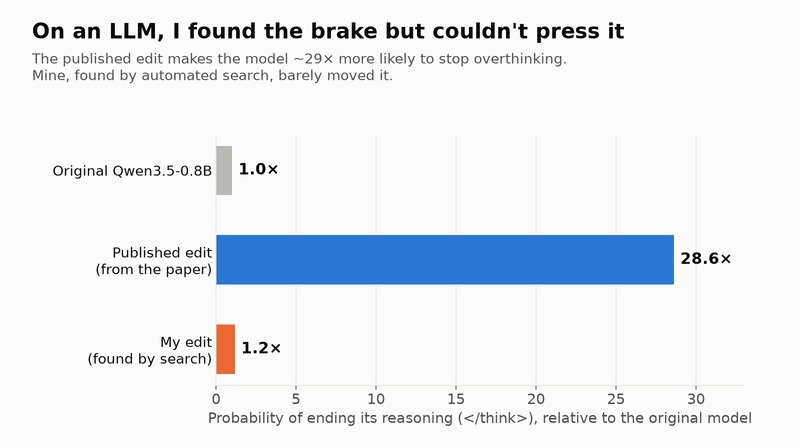
这里要分开看:发布补丁的效果得到作者复核,但自行生成补丁没有成功。结束 token 的概率变化也不能直接推导为完整任务更快、质量更好。原文没有给出这样的评估。
我的判断
我认可作者把模型补丁纳入版本管理、分组评估和回滚的思路。对于输入含义清楚、错误条件明确的小模型,这比笼统地要求 AI「优化模型」更容易审查,也更容易定位副作用。
但「几分钟修复,省掉重训周期」目前主要是经验之谈。原文没有统一对照人工成本、重训耗时、长期漂移或维护成本,几个漂亮结果又来自合成缺陷,不能据此判断修改权重总比重训划算。
与常见替代方案相比,条件明确的新政策也可以先写在模型外部的业务规则层。它更方便普通工程团队审查和回滚。把规则编进模型的实际好处,是还能沿用模型加载和推理接口;是否值得,要看部署约束,原文没有给出两种方案的对照数据。
把模型比作源码很有启发,但目前更准确的判断是:部分参数修改可以形成可测试的补丁,参数差异还不能像普通代码差异一样被可靠理解。作者也没有证明 LLM 已经跨过这道门槛。
能拿来做什么
- 如果 Node 服务加载了 XGBoost、scikit-learn 或 PyTorch 小模型,可以先挑一个条件明确的错误切片,建立独立评估,再比较修改权重、外置规则和重训的收益。
- 让 AI 编程代理修改模型时,应要求它同时交付修改理由、补丁范围、分组评估和撤销方式。作者的 CLI 提供
shrink_input_toward、project_out、add_rule等 JSON 操作,并支持导出到 PyTorch(torch.export)、scikit-learn 或 XGBoost,但这些接口不能替代效果验证。 - 标签不足时,可以尝试让 AI 把已有领域知识写成初始规则模型,再随标签到来逐步修正;若问题出在能力缺失,或希望稳定改变 LLM 行为,应继续把训练和独立验证放在主要位置。