实测 Rust 开源模型网关 Respan
作者在 Windows 上部署 Respan Gateway,连接 Gemini 并主动制造供应商故障来检验网关行为。网关以单个二进制提供统一入口,可兼容现有 SDK,供应商接入、路由和追踪等能力采用插件实现。
AI 深度解读
同一个 Gemini 模型,可以用 Anthropic 的 SDK 调,也可以走 OpenAI 的 Chat API。Respan Gateway 把协议转换、重试和模型路由放进一个 Rust 网关。作者在 Windows 上实测了两种请求格式,还故意让主线路连不上,观察备用线路能不能接住请求。
结果是两种格式都跑通了,故障期间客户端也一直收到 HTTP 200。但前两次降级各花了约 5 秒。对维护 Node 后端或 AI 工具的团队,这比单看「支持自动降级」更有用:接口能统一,故障时要等多久仍得自己测。
保留现有 SDK,换一个模型要改哪儿?
Respan Gateway 是一个可自托管的单二进制程序。应用把 SDK 的 base URL 指向网关,再把模型名改成 供应商/模型。网关从入口判断请求用了哪套协议,按上游需要的格式发出去,再把响应转回客户端认识的结构。
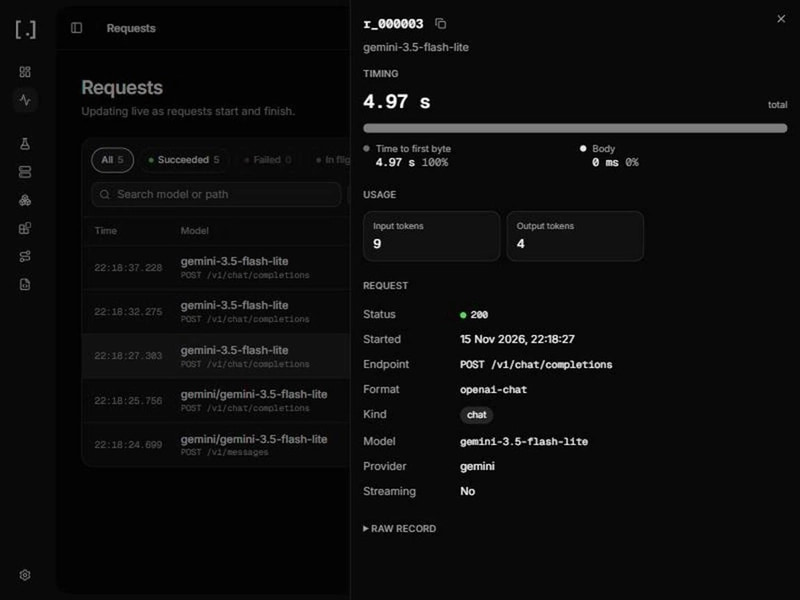
作者拿同一条提示词请求 gemini/gemini-3.5-flash-lite,分别走 Anthropic Messages 的 POST /v1/messages 和 OpenAI Chat 的 POST /v1/chat/completions,耗时依次是 1.03 秒和 1.52 秒,两次都返回了正确答案。Anthropic 入口返回的用量也转换成了 input_tokens 和 output_tokens。请求详情同时显示入口格式 anthropic-messages 和实际供应商 gemini,所以从界面就能确认请求走了哪条链路。
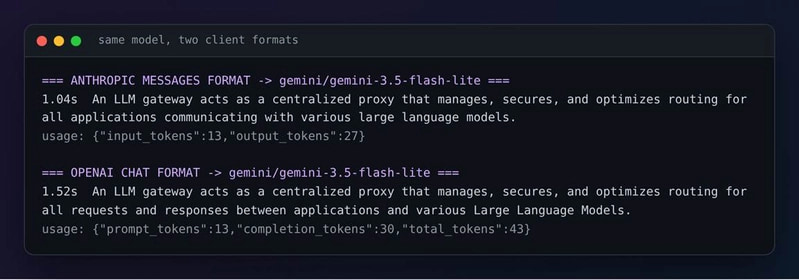
网关解决的是协议差异,上游的模型权限和生成预算照样会影响结果。作者最初选的 gemini-2.5-flash 对新用户关闭,网关透传了 Google 的 404。后来试完整版 Gemini 3.5 Flash,max_tokens=150 时有 140 个 token 花在思考上,回复被截断,用量里能看到 thinking_tokens: 140。作者调高预算并换用 Flash Lite 后,回复回到约 1 秒。两处一起改了,原文没给出各自的影响。
请求都返回 200,用户实际等了多久?
作者在 gateway.toml 里配置了两条上游线路。一条是真正的 Gemini,密钥通过 env:GEMINI_API_KEY 从同目录的 .env 读取。另一条叫 down,使用 formats = ["openai-chat"],指向没有进程监听的本地端口 http://127.0.0.1:9/v1。当应用传入不带供应商前缀的 gemini-3.5-flash-lite,就会命中 gemini-* 路由。下面这行决定了先试哪条线路。
to = ["down/{model}", "gemini/{model}"]
to 里的顺序决定了客户端先等 down 的连接尝试结束,再由 Gemini 接手。
三次调用都返回了 HTTP 200。前两次各耗时约 5 秒,其中一次的请求详情是 4.97 秒。累计四次失败后,网关让 down 进入冷却期,第三次直接请求 Gemini,只用了 0.79 秒。作者推测,前两次的大部分时间花在 Windows 等待本地连接失败上,tries = 2 又让这段等待发生了两次。原文没有拆分各阶段耗时,也没有用快速报错的上游做对照。
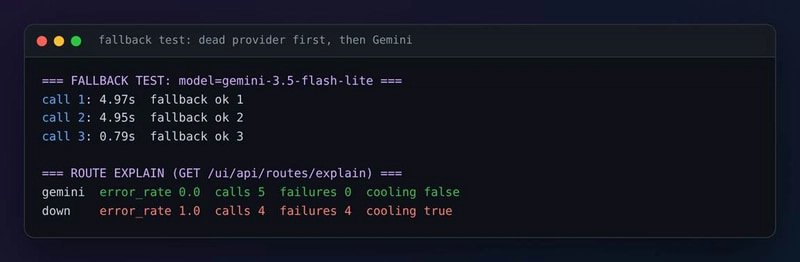
排查时,作者发现 Providers 页把 down 显示为 0 次请求,Routes 页却显示它的错误率是 100%。Routes 页的「Try a model」可以在不发送请求的情况下解释模型会走哪条线路,当时还显示 Gemini 的延迟为 682 ms。网关另有按价格、速度、权重或随机选路的 pick,可用 hedge = "200ms" 在等待 200 ms 后向第二家发起请求,也能用 needs = ["tools"] 筛选具备工具能力的线路。配置可通过 --watch 或 SIGHUP 热加载。作者实际演示的是顺序降级和冷却。
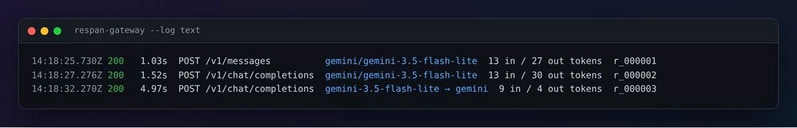
接入以后,网关能帮你看到什么?
安装有四种方式,分别是 pip install respan-gateway、cargo install、release zip 和 Docker。pip 包内带编译好的二进制,支持 Windows,作者在 Linux 上用它安装约花了 3 秒。最简方式是导出上游密钥后运行 respan-gateway。使用配置文件时,respan-gateway check 会列出供应商、端点、路由和客户端认证状态。未配置客户端密钥时,网关只允许监听回环地址。默认端口是 8080,作者最后用 --listen 127.0.0.1:8081 绕开了已占用的端口。
内置界面在 http://localhost:8080/ui/。作者那轮测试的仪表盘显示 5 次请求、0% 错误,同时记录输入、输出 token 和各供应商的统计。Requests 页支持查看、筛选和导出请求日志,Models 页列出了该 Gemini 密钥能访问的 57 个模型及其上下文窗口。Price / M 一列为空,因为 Gemini 返回的模型列表没有单价。原文给了一个手填费率的例子。
[models."gemini/gemini-3.5-flash-lite"]

pricing = { input = 0.30, output = 2.50 } # $ per million tokens, Google's list price (Nov 2026)
pricing 一行的单位是美元每百万 token,input 和 output 分开计价,数字是原文引用的 2026 年 11 月标价。
我的判断
这轮实测最有说服力的是两件小事。Anthropic 格式的普通文本请求能从 Gemini 拿回结果,顺序降级也能在主线路连不上时保住这几次调用。对已经维护多套 SDK 适配和重试逻辑的团队,把这两件事收进一份 TOML,排错时就有一个共同入口。只接一家模型、业务端还要深入使用供应商专有能力的团队,继续直连 SDK 也有道理,少一跳服务,接口行为也更容易对照官方文档。
性能优势还缺独立数据。原文提到 README 的基准,但给出的正文没有列出具体数字,LiteLLM 在厂商对照里也只用了一个 worker。作者没做负载测试,也没给直连 Gemini 的耗时对照。约 1 秒的往返能说明这次试用中没有感知到明显额外延迟,至于并发上来后的吞吐量和尾延迟,仍是未知数。用空端口触发的降级也只覆盖了一种故障,无法据此判断上游限流或流式响应中断时的行为。
试用版本为 v0.3.0,内置 16 家供应商,也支持 OpenAI-compatible 端点,采用 MIT 或 Apache-2.0 许可。供应商、路由、定价、MCP 和追踪共用公开的 Rust 插件 API,接口是一个 trait、四个 hook。只维护 JavaScript 或 Python 的团队能先用配置和内置能力,要写自定义插件就得有人维护 Rust。网关还声明可以在聊天请求内执行 MCP 和内置工具,作者没有测试。若项目更看重集成覆盖和企业功能,可以把 LiteLLM 放进同一轮验证。
能拿来做什么
- 给现有 Node 服务挑一个普通文本调用,把 SDK 的 base URL 指向本地网关并改用带供应商前缀的模型名。用同一条提示词核对状态码、回复正文和用量字段,再决定是否扩大接入范围。
- 用不可达上游复跑顺序降级,分别记录冷却前后的端到端延迟。根据页面或 API 的等待预算调
tries和backoff,同时看 Requests 和 Routes 页,避免把客户端的 HTTP 200 当成所有上游都正常。 - 把供应商、路由和常用模型的费率写进
gateway.toml,变更后先跑respan-gateway check。需要核算调用成本时,确认 Models 页已有对应单价,再结合 token 用量算费用。