Replit Missions 推出目标驱动多智能体开发
Replit 发布 Missions,用户设定目标、预算和边界后,由多个 Agent 协调规划、构建、测试和迭代。官方案例称,其在两天、3000 美元预算内完成了包含仪表盘、告警和应用追踪的监控平台。
AI 深度解读
Replit Missions 想把 AI 编程的委托方式从「帮我完成这个任务」,推进到「在预算和权限内,把这个目标做成」。人负责定义结果,多个 Agent 负责拆解、执行、测试,再根据反馈调整路线。
它最有价值的部分,是把预算、审批和验收纳入同一个执行流程。Replit 用自建监控平台 DataCat 和多 Agent 优化实验展示了这套思路,但这些结果离「团队可以放心托管复杂业务」还有距离。对程序员来说,值得看的是哪些工作适合这样委托,以及怎样让结果可检查。
交给 Agent 的目标,必须先变成验收条件
Missions 接收的可以是业务目标,例如「拿下首批 10 个付费企业客户」,不要求用户事先确定行业、采购人或切入点。寻找路径,也是委托的一部分。
但目标越开放,越容易出现「看起来完成了,实际没完成」的问题。付费试点算不算企业客户?还是必须签订达到最低金额的年度合同?Missions 会在设置阶段追问这些问题,让答案决定执行优先级和成功标准。
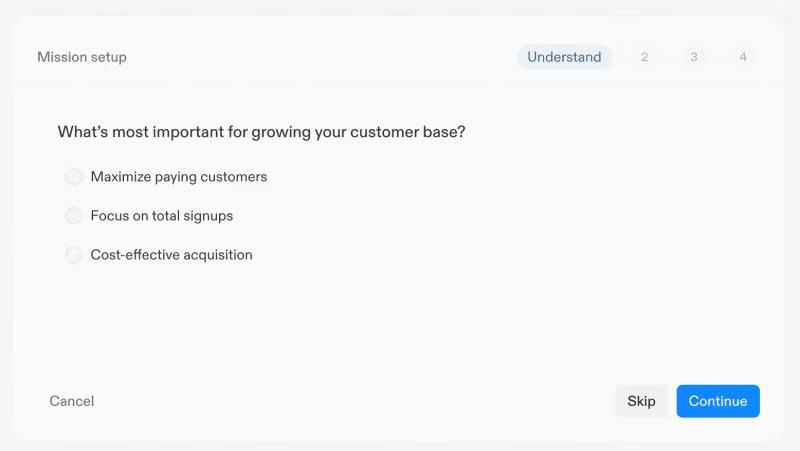
执行边界也要提前约定。原文举了一个 $1,000 的预算示例:联系潜在客户、发送方案、修改对外销售材料、作出产品承诺,都可以要求先审批;是否接受付费试点、是否允许年度合同折扣,也需要约定。
这些限制会在策略调整时继续生效。Agent 可以改变研究方向,但不能因为某条路线更有希望,就自行扩大权限。
目标负责说明要得到什么,验收标准负责证明它真的做到了。
进度通知支持立即发送、每日摘要或每周更新,内容可以包括阻塞、进展和总体状态。云端 Agent 持续工作,用户可以查看已完成事项、当前任务、下一步和待审批操作。
结果由独立的 AI judge 对照约定标准检查,执行 Agent 根据反馈继续修改。达到标准才标记完成;预算先耗尽,就停止工作,目标仍可能没有解决。这里的预算上限控制了投入,却不保证交付。
多个 Agent 的价值,是同时尝试不同解法
Missions 用 Agent swarm,也就是多个协作的 Agent,承担规划、构建和迭代。企业销售场景里,一个 Agent 可以研究采购人,另一个制作演示,再根据获批外联的回复调整行业选择、演示内容和措辞。
性能优化更容易解释这种并行的价值。同一个问题可能有多种实现,有的适合减少计算,有的适合改善内存访问。多个 Agent 同时探索,再共享发现,比让单个 Agent 沿一条路线反复修改,有机会找到更好的解法。
Replit 在 13 个使用 NumPy 的代表性基准任务上做了测试,包含替代实现探索、内存访问优化和自动正确性验证:
| 配置 | 单个 Agent | 16 个 Agent | 32 个 Agent |
|---|---|---|---|
| Auto (Max) | 最高 4× | 17× | 19× |
| Auto (Power) | 2× | 7× | 9× |
这些数字描述的是找到的实现能获得多少性能加速,不能读成「开发速度提升 19 倍」。
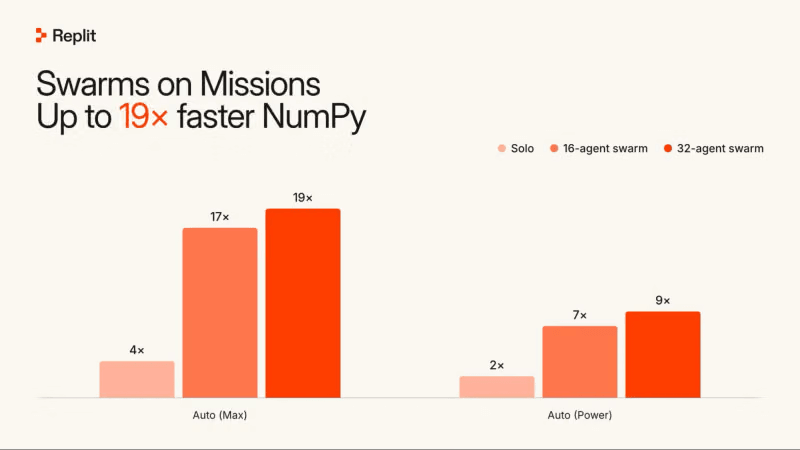
结果支持一个较窄的结论:在这些任务中,扩大并行探索范围,确实找到了更快的实现。但收益没有随 Agent 数量等比例增长,Auto (Max) 从 16 个增加到 32 个,加速比只从 17× 增至 19×。
原文没有交代各配置的总成本、耗时和重复实验分布,因此还不能判断哪种规模最划算。对一般团队,协作基础设施由 Missions 承担,省去了自行维护的工作,但并行探索是否值得付费,仍要看任务和验证成本。
DataCat 展示了什么,又没有证明什么
Replit 希望把应用监控搬到自己的基础设施,以降低成本并获得更多控制权。他们给 Missions 设定目标,在 2 天、$3,000 预算内得到 DataCat:包含仪表盘、告警、应用追踪,以及自建的数据采集 Agent 和追踪库,可以脱离原平台的 Agent 与库运行。
比功能清单更有参考价值的是验收过程。
团队故意引入数据库故障,DataCat 在 38 秒内发出告警,达到低于 60 秒的目标,并将问题定位到具体数据库查询和日志。在 3 小时负载测试中,它存储了 2600 万条应用活动记录和 440 万条日志,没有数据丢失,搜索和告警持续运行;36 项数据正确性检查与 15 项告警可靠性检查全部通过。
这些是作者报告的受控测试结果。它们说明 DataCat 已经具备可工作的基础,不能直接证明长期生产运行的可靠性。
原文还给出了两组比较。第一组是在匹配负载和监控工作的 Node.js 测试中,DataCat 让应用处理了更多请求,监控相关 CPU 开销更低;其采集 Agent 内存占用更少,日志也更早可搜索。不过,提供的正文没有列出具体差值,也没有证明它优于原平台的托管服务或 Replit 生产环境中的表现。
第二组是与 Claude Code 比较:在相同云机器上,用相同初始提示,通过 /goal 构建另一个监控平台,每种设置只运行一次,只评价双方共有的产品领域。
DataCat 能接收原平台 Agent 发来的日志、指标、主机数据和追踪,Claude Code 的构建结果只接收日志。DataCat 通过更多 API 兼容性检查,追踪和指标摄入更快;Claude Code 的结果覆盖更多产品领域,日志摄入更快。
测试使用原平台 Agent 7.56.2。采集 Agent 对比采用同一工作负载重复运行,每次运行一个 Agent,并发送到同一个 Radar server。API 兼容性检查则是独立套件,不能与前面的正确性、告警检查混为一谈。
Replit 表示已开放 DataCat 的可自托管版本。原文也提到 E-Commerce Bench:Agent 以 ¥100,000 起步,经营模拟网店一年,Missions 单次运行得到 ¥4.82 million,约为本金的 48 倍,超过公开榜单最佳成绩的 3 倍。它展示的是模拟环境中的一次结果,不能当成真实电商收益预期。
我的判断
我认可 Missions 把目标、预算、权限和验证绑在一起的方向。日常 AI 编程最难的一步,往往是判断「现在到底能不能交付」。DataCat 至少展示了把抽象目标落成故障注入、负载测试和兼容性检查的做法。
但独立 AI judge 仍然是 AI。原文没有说清它如何避免误判、评估标准能否被执行 Agent 钻空子,以及业务结果如何接入真实证据。测试脚本能证明某些行为发生过,评审模型给出通过意见,则需要继续追问依据。
DataCat 与 Claude Code 的比较也只能视为一次案例。每种设置各跑一次,且正文没有提供足够的成本和耗时对照,无法据此判断 Missions 普遍优于 Claude Code。双方各有领先项,已经说明「谁更强」取决于评价范围。
多 Agent 更适合扩大可验证的探索,不会自动解决需求模糊和责任归属。
与单 Agent 相比,它可能更适合存在多条技术路线的工作;与人工拆解、持续集成配合单 Agent 的方式相比,它提供了更集中的协调流程。原文尚未证明这些收益能覆盖所有任务中的额外成本。「Self-Driving Company」是 Replit 对未来组织方式的判断,不是这些实验已经验证的结论。
能拿来做什么
- 给 Node.js 性能优化任务补上可执行的成功标准,例如固定负载下的响应时间、监控 CPU 开销和正确性检查,让 Agent 有明确的停止条件。
- 遇到多条实现路线时,让不同 Agent 探索替代方案,并用同一套测试比较结果;记录总花费和耗时,判断并行是否值得。
- 评估自建监控或替换现有工具时,参考 DataCat 分别检查数据接收、故障定位、持续负载和 API 兼容性的做法,避免只凭演示页面验收。
- 尝试 Missions 时,可从侧栏点击
New,选择Mission,写入目标,并同步约定预算与审批边界;涉及客户联系和产品承诺的权限尤其需要写具体。