用笔记本 CPU 训练小模型理解安全风险
作者用 Intel MacBook 的 CPU 和 llama2.c 训练约 26 万参数的模型,并用 C 运行推理。文章记录了约 90 分钟的训练过程、验证损失从 6.25 降至 1.62 的结果,以及训练和推理各环节涉及的安全风险。
AI 深度解读
作者在 Intel MacBook 的 Core i9 CPU 上,用 llama2.c 花约 90 分钟训练了一个约 26 万参数的语言模型。跑完 5,000 步,它从吐出乱码变成了能写几句像样的儿童故事。作者借这次实验拆开了分词、训练和推理,也解释了提示注入为什么会成为应用层的问题。
对接过文档问答或工具调用的开发者,这篇最实用的启发是把指令优先级和操作权限分开设计。模型可以学会优先听谁的,应用仍要决定它能读什么、能改什么、能把结果发给谁。
同一句话为什么能切出 20 个 token,也能切出 8 个?
分词器(tokenizer)把字符串切成片段,每个片段再映射成整数 ID。作者用儿童故事训练了一个词表大小为 512 的分词器。Once upon a time 被切成 ▁Once(403)、▁upon(407)、▁a(261) 和 ▁time(378)。括号里是模型接收的 ID,▁ 标记片段前的空格。
作者又用 30 篇 AI 安全论文训练了一个词表大小为 2,048 的分词器。同一句英文在故事分词器里占 20 个 token,在论文分词器里只占 8 个,后者把 ▁instructions 收成了一个片段。这里同时换了语料和词表大小,这组结果能展示两套分词器有多不同,无法单独算出语料贡献了多少差异。
真正踩到的坑发生在模型之前。制作论文数据集时,一个 PDF 转出来的文本含有孤立代理字符,直接让处理流水线崩了。这和提示注入是两类问题。前者发生在解析和编码阶段,后者发生在模型解释上下文时。对要接收用户上传文档的应用,两层各有自己的失败方式。
训练 5,000 步之后,模型究竟学到了什么?
llama2.c 用一个 PyTorch 脚本训练模型,再用约 1,000 行的 run.c 加载 model.bin 做推理。model.bin 存放权重,也就是训练过程中被反复调整的浮点数。作者的模型约有 26 万参数,Meta 的 Llama 2 7B 有 70 亿参数。实验把规模缩小了,仍能观察同一类架构怎么生成文本。
在 Transformer 里,嵌入层先把 token ID 查表变成向量。因果注意力让当前位置参考之前的 token,前馈网络再处理每个位置上的表示。这个过程逐层重复,最后给词表中的每个候选 token 打分。Llama 2 还用了帮助模型感知顺序的 RoPE,以及 RMSNorm 和 SwiGLU。
下面是作者在 TinyStories 上训练模型的完整命令,用交叉熵衡量下一个 token 猜得有多准,再通过反向传播调整权重。
python train.py --out_dir=outmini --device=cpu --compile=False --dtype=float32 \
  --vocab_source=custom --vocab_size=512 \
  --dim=64 --n_layers=5 --n_heads=8 --n_kv_heads=4 --multiple_of=4 \
  --max_seq_len=256 --batch_size=32 --gradient_accumulation_steps=1 \
  --learning_rate=1e-3 --dropout=0.05 --weight_decay=0.01 --beta2=0.99 \
  --max_iters=5000 --warmup_iters=500 --eval_interval=500 --eval_iters=20
最后一行把训练限制在 5,000 步,每 500 步评估一次,每次评估跑 20 个批次。作者实测约 1.1 秒一步,总计约 90 分钟。
初始损失约为 6.25,换成困惑度是 e^6.25 ≈ 518,接近在 512 个 token 里均匀猜测。第 5,000 步的验证损失降到 1.62,困惑度约为 5。这个数字表示模型平均有多难猜中真实的下一个 token,词表仍是 512 项。
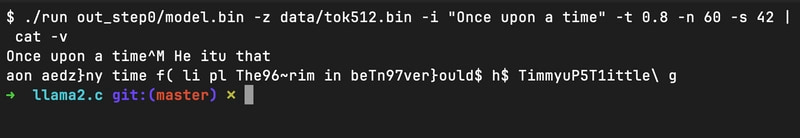
采样文本的变化更直观。训练中途,模型已经会写故事开头、给角色起名字、用引号写对白,但还会造出 housels 这样的词。训练结束时,句子通顺了许多,情节还是会跑偏。
为什么系统消息有优先级,操作权限还得由应用控制?
这条命令让训练好的模型从一句故事开头继续往下写。
./run outmini/model.bin -z data/tok512.bin -t 0.8 -p 0.9 -i "Once upon a time"
这一行里,-z 指定与权重配套的分词器,-t 0.8 设置温度,-p 0.9 把采样限制在累计概率达到 0.9 的最小候选集合中。温度为 0 时,每步取概率最高的 token。每生成一个 token,它就被追加到上下文,参与下一轮预测。
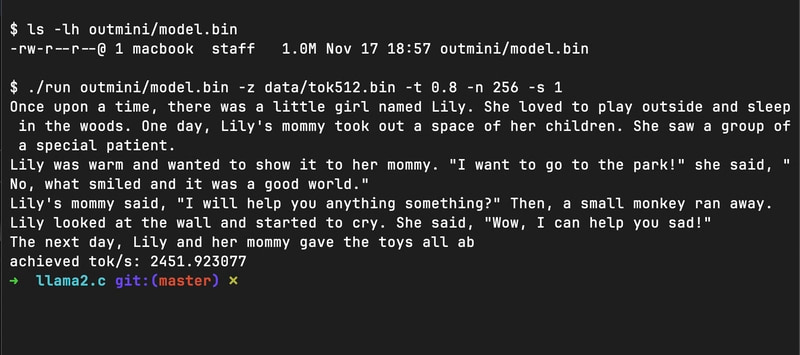
作者的小模型拿到问题,也会把它当成待续写的故事。ChatGPT、Claude 一类助手能按指令作答,还涉及指令微调、RLHF 或其他偏好调优,以及区分系统、用户和助手消息的对话格式。角色标记能影响模型怎么回答,但应用侧的授权检查要在执行操作时生效。
这就是文档问答与工具调用的交界处。检索增强生成(RAG)会把查到的网页、PDF 或邮件放进上下文,文档里的指令也可能影响模型输出,这属于间接提示注入。模型生成一段错误摘要,影响还在回答里。若应用照着模型的输出发邮件或改数据,影响就跨出了对话。SQL 参数化查询能由数据库强制区分语句和参数。LLM 应用也可以在工具接口上强制校验权限,至于模型如何理解文档内容,仍要用评测观察。
我的判断
这次实测最能说明两件事。分词结果取决于具体的分词器,下一 token 的预测能力也确实可以在普通 CPU 上看着它一点点学出来。至于分隔符、分类器和权限隔离分别能减少多少风险,作者没有提供对照数据,相关判断属于机制分析和经验之谈。温度调到 0 可以减少采样带来的变化,模型仍可能稳定地产生同一个错误结果。
作者把接近的训练损失和验证损失解读为模型学到了可泛化的规律。按文中列出的 1.60 和 1.62 计算,差值是 0.02,原文写的是 0.01。这组数据支持模型在留出的文本上也能预测得不错,无法判断个别训练样本是否会被逐字复现。原文也没有做训练数据提取实验。Chinchilla 给出的每参数约 20 个训练 token,是特定计算预算下的训练配比经验,不能拿来判断隐私风险。
对一般团队,文档分隔符和工具授权可以同时做。前者成本低,适合改善指令与引用材料混在一起时的表现。后者能在模型判断出错时拦住越权操作。两者的效果要分开测,尤其要看服务端是否真的拒绝了超出当前用户权限的调用。
能拿来做什么
- 给前端上传和 Node 文档处理链路补上解析失败用例。覆盖损坏的 PDF、含非法字符的提取结果和单页解析失败,确认任务能返回明确错误,并保留可用的处理结果。
- 给 RAG 应用做两套回归评测。一套检查摘要有没有被文档内容带偏,另一套检查模型输出超出权限的工具参数时,服务端有没有拒绝执行。对外发送和写入操作由应用校验权限,必要时再让用户确认具体内容和目标。
- 在团队的模型加载脚本里检查权重来源与格式。优先使用
safetensors等仅存权重的格式,兼容的 PyTorch 检查点可以用torch.load(..., weights_only=True)。把下载模型和加载模型分成两个可审查的步骤,避免开发脚本拿到ckpt.pt就自动反序列化。