Claude 审查实验:找到缺陷也会误判后果
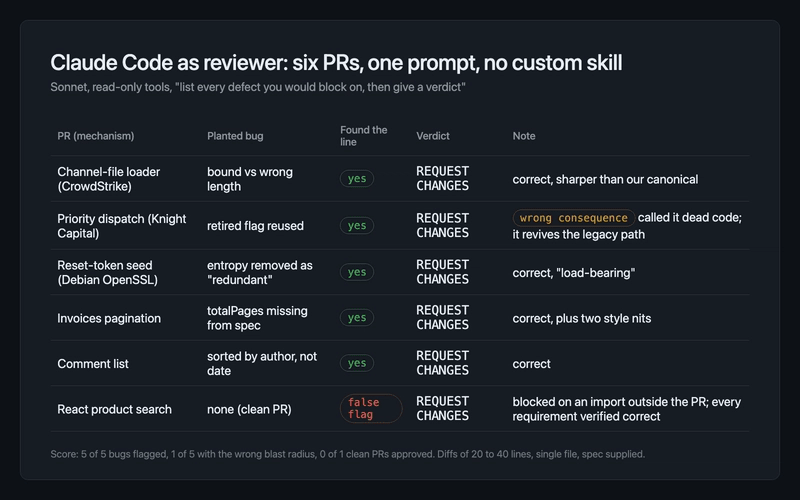
作者用六个独立 PR 测试 Claude Code,其中五个植入缺陷、一个无缺陷;模型发现了全部五个缺陷,但误判了其中一个的后果。实验使用只读工具、普通提示词和独立 Git 仓库,未配置专用审查技能。
AI 深度解读
Claude Code 在六个小型 PR 中找出了全部五个预埋缺陷,却把其中一个高风险问题解释成了「新功能无法启用」,还拦下了唯一没有缺陷的 PR。作者想检验自动审查的能力下限,结果暴露出比漏报更隐蔽的问题:找对出错的行,不代表理解了后果。
这次实验值得读,是因为它把代码审查拆成了三个不同能力:定位缺陷、判断影响、决定是否放行。模型在第一项上表现很好,后两项仍需要人来兜住。
五个缺陷全找到,这个成绩要放在多大的场景里看
作者把六道审查题分别做成小型 Git 仓库:基础提交保存修改前的状态,功能分支保存 PR,PR.md 放入用户看到的原始需求。随后在每个仓库内,以非交互方式调用一次 Claude Code,使用 Sonnet、只读工具和默认 effort。
提示词也很朴素:对比当前分支与 main,列出足以阻止合并的缺陷,给出文件、行号和最终结论。没有自定义 skill,也没有仓库指令。作者测的是默认配置能做到什么。
五个问题覆盖数组边界检查、退役配置复用、随机熵删除、分页接口漏字段,以及评论排序键错误。第六个是正确处理请求取消的 React 搜索组件。
模型的一些评论确实有质量。边界检查题里,它指出 rules.length 与 INPUT_REGISTER_COUNT 分别代表规则数量和固定输入数组容量,不能相互替代,而且检查可能向两个方向出错。随机熵题里,它识破了删除 randomBytes(32) 的「清理」提交:那块缓冲区承担实际作用,并非多余分配。排序题里,它还补充了证据:代码用了作者字段排序,而时间戳在整个文件里都没有被引用。
但这些都是单文件、20 到 40 行、需求明确的 diff。这个范围不能省略。
找对配置键,为什么仍然低估了事故后果
最有价值的是仿照 Knight Capital 事故设计的题目。
新功能想复用 priorityDispatch,控制优先级标签。需求已经说明,这个配置键属于退役功能,必须保持关闭。模型立刻发现复用问题,阻止合并,并建议换一个新键。
下面这段审查意见解释了它为什么阻止合并,也留下了关键误判:
As deployed, the flag stays off forever, so the new priority-tagging
feature can never be enabled through its intended path. It's permanently
dead code.

If priorityDispatch were ever accidentally turned on, it would silently
activate the *new* feature too, an unintended coupling of two unrelated
behaviors under one flag name.
要盯住第二段的 *new* feature too:模型认为开关打开后,新旧功能会一起运行。
实际控制流并非如此。同一文件前面的遗留分支也检查这个键,而且会先执行,最后以 continue 跳过当前循环后续代码。开关一开,新功能根本到不了,旧调度逻辑却被重新接通。
更严重的是,旧调度器没有记录已处理订单的台账。它会在每个 tick 把所有订单重新提交给真实承运方,包括已经发货的订单,持续制造重复发货请求。模型却把问题解释成了新功能无法启用,以及两个功能意外耦合。
定位、阻断和修复建议都正确,事故影响仍然可能判断错。
原文自己把「永久死代码」也判为错误,但这里应区分两件事:新功能不可达,确实符合给出的执行路径;真正危险的误判,是模型漏掉了旧逻辑被激活后的副作用。
这会影响后续处置。收到「换个配置名」的意见,开发者可能改完就结束;知道旧路径会重复提交订单,团队才可能进一步清理遗留代码、排查配置入口。审查意见描述的严重程度,会改变修复范围。
连正确实现都确认了,为什么还是不肯放行
无缺陷的 React 搜索组件同样被要求修改。
原因是组件导入了一个搜索 API 模块,但题目仓库没有提供这个模块。模型将其判为损坏的 import。作者承认,这与实验材料不完整有关。
更有意思的是,模型已经逐项确认防抖时机、过期响应防护、保留此前结果、ARIA 角色和稳定 key 都实现正确,最后仍因缺失模块阻止合并。
从代码审查角度看,区别在于:这是完整仓库里确实不存在的文件,还是审查材料没有包含它?前者可以构成阻断理由,后者需要补充上下文。这次输入不足以干净地区分两者,因此不能直接把结果解释成模型不会审查 React 请求取消。
它至少提醒我们,自动审查需要校准,也就是让阻断力度与证据强度相匹配。遇到疑问就要求修改,确实保守;但如果疑问反复变成误报,团队会逐渐忽略机器人评论。
我的判断
我认同作者对能力边界的拆分:模型适合逐行核对明确需求,人还需要追踪执行路径、判断副作用,并确认哪些疑问足以阻止合并。相比只跑 lint 或类型检查,这种审查能发现语法合法、业务语义却错误的问题。
但六个样本只能支持有限结论。原文没有给出 Sonnet 的具体版本,也没有重复运行、不同提示词、完整仓库或人类审查者的对照数据。「比匆忙的人类审得好」仍是作者的经验判断。
尤其需要收紧的是跨文件推理结论。关键误判发生在同一文件,漏掉的是距离 diff 约 15 行的 continue。它能证明这次审查没有追完整控制流,不能单凭这一例衡量模型普遍的跨文件能力。作者提到的年度基准共识,也没有在文中展开证据。
作者提到 superpowers 超过 280,000 stars、Addy Osmani 的 skill pack 接近 95,000 stars,以及内置 /code-review,是在交代需求热度。这次实验没有测试自定义 SKILL.md,所以它既不能证明 skill 无效,也不能证明加上清单就能补齐推理缺口。
五个缺陷全部检出,只能说明这五个样本被检出,不能当作真实项目的召回率。
能拿来做什么
- 在日常 AI 审查中,除了要求文件、行号和修复建议,再要求模型解释触发条件、执行路径和外部副作用。配置复用、循环跳转这类改动,尤其要回看 diff 之外的代码。
- 审查 React 搜索组件时,可以让模型逐项核对防抖、过期响应、结果保留、ARIA 和 key;遇到缺失依赖,则先核实完整仓库是否包含文件,再决定是否阻止合并。
- 给团队的审查评估保留无缺陷 PR,同时记录漏报、误报和后果判断错误。只统计「抓到了多少 bug」,会把不会放行和低估风险的问题藏起来。
- 对退役配置的修复,不要止于换一个新键。原文最直接的教训,是继续检查旧键还控制哪些路径,以及那些路径是否仍能触达真实外部系统。