开源项目用音频和弹幕筛选直播高光
可自托管的 ClippingShorts 面向 2 至 10 路并发直播,结合音频和聊天信号定位候选片段,再用 Gemini 评估并通过 FFmpeg 剪辑。系统用 Docker 组织服务,将直播接入、AI 处理和视频渲染交给独立进程。
AI 深度解读
ClippingShorts 想省掉的是守着几个直播间找素材的时间。它同时盯着 Twitch 和 YouTube Live,用音量和弹幕圈出可疑片段,再交给 Gemini 判断,最后把候选视频送进浏览器编辑器。上传默认关闭,发布前由人审片。
这套开源自托管方案最值得拆开看的是「先筛选,再判断」。本地规则负责缩小模型的处理范围,滚动缓冲负责把事件发生前的画面留下来。对做前端和全栈的读者来说,编辑器、后台渲染和上传状态怎么串起来,也比单看一个模型调用更有参考价值。
为什么要在调用 Gemini 前先看音量和弹幕
ClippingShorts 面向同时监控 2–10 路直播的场景。每路直播由一个独立的操作系统进程处理视频接入、音频提取、弹幕分析和本地高光检测。视频默认只在滚动缓冲里保留最近 180 秒。新片段进来,旧片段就会被清掉,已经标记为候选素材的片段会继续保留。
本地检测用的是容易持续计算的信号。音频侧看 RMS(均方根,用来估计一段音频的信号强度)、分贝和相对音量突增。弹幕侧看独立发言人数、表情、反应词、重复消息和刷屏活动。每路直播都跟自己的近期水平比。同样的音量,在平时很安静的直播间可能是一次突发反应,在一直放音乐的直播间可能只是日常波动。检测器发现异常后,会先锁定相关视频分段,给后续处理留出时间。
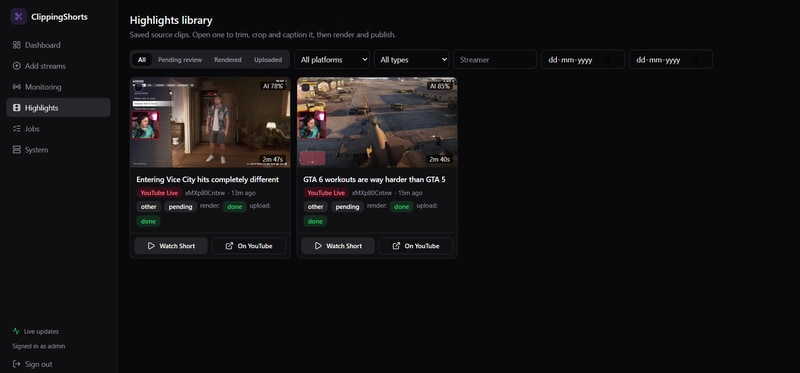
候选片段会进入两条独立的 Gemini 评估路径。一条先通过 Google Cloud Speech-to-Text(Chirp 3)生成转写,再判断对话、发言和口头反应有没有剪辑价值。另一条主要看音量和弹幕反应。系统合并两路结果,决定是否保留候选。原文交代了两路各看什么,没说两边意见相左时如何取舍。还有一个由处理顺序带来的限制:如果一段精彩对话没有触发本地检测,后面的转写评估也很难补救。
为什么镜头要往高光发生前找 120 秒
候选获准后,系统默认提取事件前 120 秒、后 40 秒的素材。往前取是为了留下铺垫,比如失误前的操作或笑点前的对话。往后取是为了保住结果和现场反应。如果几个候选的时间窗重叠,系统会合并它们,减少重复素材。这个窗口给编辑留出了上下文,成片时长可以在时间线上继续调整。
浏览器编辑器提供缩略图和波形,可切换 9:16、16:9 和 1:1,支持智能裁剪和模糊背景填充。字幕、开头文案、音量、响度和发布文案都可以调整。每次编辑都生成独立的渲染版本,原始片段会保留。实际做竖屏时,同一段素材可以先试主体裁剪,再试背景填充,两版都能回到同一份源片段。
渲染异步交给专门的 FFmpeg worker。审片通过后,系统用 YouTube Data API 上传,支持断点续传、提交标题和描述,并记录发布后的 YouTube 视频 ID。自动上传默认关闭,用户可以在公开视频前检查字幕、画面和文案。
自托管时,多路直播和渲染怎么共用一台机器
前端用 Next.js 15、TypeScript 和 Tailwind CSS,后端用 Python 和 FastAPI。Redis 管队列和实时状态,数据库可选 SQLite 或 PostgreSQL。整套服务用 Docker Compose 启动,使用者需要配置 Google Cloud、Google Cloud Speech-to-Text 和 YouTube OAuth 所需的凭据。
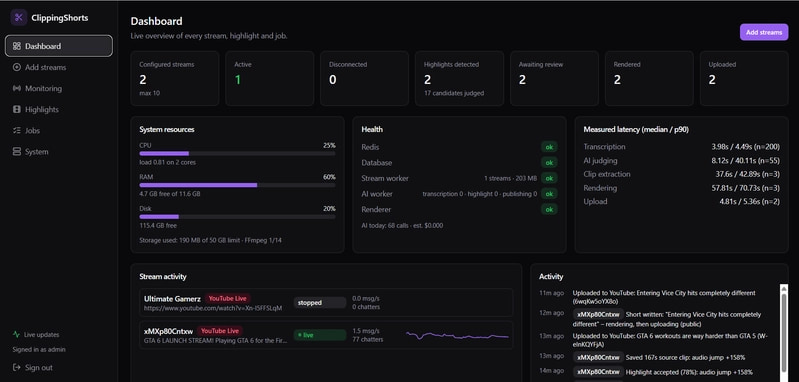
采集要跟上直播,候选审核可以排队,视频渲染又可能突然吃满 CPU。作者把这三类任务拆开,并用资源准入控制决定什么时候启动任务。固定并发上限约束同时执行的工作量,Redis 队列也有容量上限。再配合单路进程隔离、重启指数退避和临时文件清理,目的是减少一路直播反复重启或一批渲染任务挤占整台机器的情况。项目还提供合成直播流,可以在没有真实直播时走一遍检测流程。
我的判断
先用流内基线筛选,再让模型判断内容,是这篇最有参考价值的设计。规则适合持续盯着变化,模型适合处理已经缩小范围的候选。相比直播结束后再做全量转写,这套做法能更早交付候选片段,也只需为近期画面保留滚动缓冲。全量转写则更适合事后按语义回看,尤其是访谈或技术分享,亮点可能出现在音量平稳、弹幕稀少的时候。
原文展示的是作者已经实现的处理流程,并未给出单路与多路的资源实测、候选命中率、漏检率或模型调用成本。2–10 路是设计目标,具体机器能扛几路还得看输入规格和渲染负载。双路评估也缺少与单路评估的对照。它让不同信号有各自的判断路径,能否提高最终入选片段的质量,原文只给出了经验判断。对小团队来说,可以先用单路评估跑一批人工标记过的素材,看漏掉的是对话亮点还是集体反应,再决定第二路是否有必要。
能拿来做什么
- 给现成的 Node 直播工具加高光检测时,可以先选几场有人工时间点标记的素材,记录音量和弹幕触发的候选,逐个核对误报和漏报,再决定哪些候选值得送给模型。
- 做浏览器剪辑页时,可以把源片段、编辑参数和渲染结果分开保存。切换比例或修改字幕后提交新的 FFmpeg 任务,前端展示任务状态,用户可以随时回到原始片段重剪。
- 接入 YouTube Data API 时,可以把「渲染完成」「待审片」「上传完成」设为独立状态,并保存上传返回的视频 ID,方便处理重试和核对发布结果。只处理自己拥有或获准使用的直播素材。