用检查点和自评让 Agent 跑完多步任务
作者以自动写作为例,用 AGENTS.md 加载工作规则,按需载入技能,再用待办清单和子 Agent 拆解执行。系统按会话隔离 Docker 环境,逐步保存检查点,并让 Agent 自评返修,通过 SSE 展示执行进度。
AI 深度解读
作者让 AI 写一篇带封面、YouTube 推荐和话题标签的博客,还要求它交稿前自查。模型写了 3 段就宣布完成,封面、视频和标签全漏了。于是作者做了 Content Studio,把长任务拆成可以追踪、恢复和验收的步骤。
这套做法值得前端和全栈开发者花几分钟看完。你能看到一次写作任务怎样从列计划跑到验收通过,也能分清哪些能力已经在演示里跑通,哪些还得靠故障测试和对照数据来验证。
长任务为什么会漏步骤
普通 ReAct 循环让模型调用工具、读取结果,再决定下一步,最后给出答案。查天气这类任务走几轮就能结束。任务一长,搜索结果和中间产物会占据上下文。作者举了个例子,12 步走到第 7 步,模型可能已经忘了还有第 9 步,直接宣布完成。
作者用 Agent Harness 指围绕模型运行的那层应用代码。Content Studio 基于 LangChain Deep Agents,复用它的规划、虚拟文件系统和子代理能力,再接入 Docker 沙箱、检查点和评估流程。作者用「提示词占 5%,Harness 占 95%」强调运行机制的重要性,原文没有提供这两个比例的测量依据。
固定规则、操作手册和当前进度各管什么
AGENTS.md 每次运行都会加载,适合放品牌语气和每次都要执行的规则,例如交给 researcher 做深入调研,评估没到 PASS 就继续修改。Skills 是按需读取的操作手册。提示词里只放简短描述,匹配任务后才读完整内容。写 LinkedIn 帖子时,长文用的 blog-post 手册可以留在上下文之外。
write_todos 负责记录这一次做到哪了。作者让它列出 6–10 个尽量能一步完成的任务,并根据用户或 evaluator 的反馈更新清单。封面一旦成了独立待办,就有了明确的进度记录。作者报告说,这样改完后,代理就没再漏掉封面。原文没交代跑过多少次。
下面这段 backend/agent_runner.py 展示了模型、工具、子代理和检查点怎样接进同一个入口。
TOOLS = [web_search, download_image, generate_hashtags, move_file]

subagents = (
    load_subagents(config.SUBAGENTS_YAML, {t.name: t for t in TOOLS})   # local
    + SubAgentRegistry(agent_list_path=config.AGENT_LIST_PATH).get_subagents()  # A2A
)

self.agent = create_deep_agent(
    model=model,
    backend=backend,              # Docker sandbox for this thread
    tools=TOOLS,                  # custom tools
    subagents=subagents,          # local + remote agents
    checkpointer=checkpointer,    # save every step
    middleware=[
        TodoListMiddleware(system_prompt=WRITE_TODOS_SYSTEM_PROMPT,
                           tool_description=WRITE_TODOS_TOOL),  # planning
        self.crash,               # crash testing (Part 2)
    ],
    memory=["./AGENTS.md"],       # always-on rules
    skills=["./skills/"],         # on-demand playbooks
)
看 subagents=subagents 这一行,本地子代理和通过 A2A 接入的远程代理共用一个调用入口,模型统一通过 task(...) 委派。作者把这套装配概括为一次 create_deep_agent(...) 调用接入 8 项能力。
一次运行怎样从起草走到验收
演示任务是写一篇关于 AI Agent 如何改变软件开发的博客。主代理先列计划,交给 researcher 调研,把结果保存到 research/<slug>.md,再在沙箱里写稿。封面由 download_image 下载,YouTube 视频交给远程的 A2A infotainment 代理推荐。
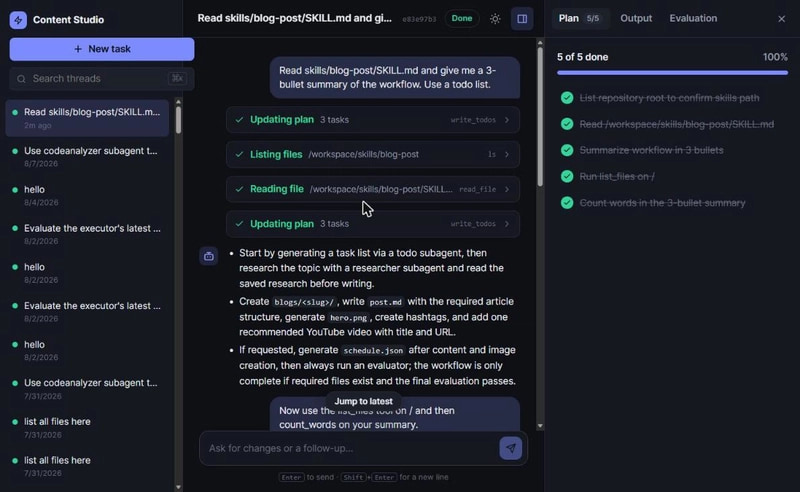
第一轮评估给出 FAIL。主代理根据反馈新增待办,修完再评,直到拿到 PASS。FastAPI 通过 SSE 把进度推给 React 界面,用户可以看到计划、文件、评分,以及工具调用的输入、输出和耗时。最后的清单显示 8 项全部勾选。
我的判断
我最认同的是把交付项记进任务状态。漏封面可以在待办里发现,评估失败也能留下具体的返工项。演示说明这条流程跑通了一次。原文没有拿普通 ReAct 循环、长提示词或固定工作流做对照,也没统计漏项率、耗时和调用成本。清单能降低漏项是作者的经验判断,改善幅度还没测清楚。
如果每篇博客都要检查封面、视频和标签,用固定工作流逐项校验,通常更容易定位哪一步失败。让模型动态更新待办,适合调研和返工这类步骤会随结果变化的工作。关于 evaluator 给出的 PASS,原文没说明评分标准和返工上限,也没交代评估结果与人工审稿结果有多一致。界面上的 8/8 可以用来看进度,文章质量还得看验收规则。
这篇是 5 篇系列的第 1 篇,项目也还处于学习阶段。代码接入了每步保存的检查点,并为每个会话分配一个 Docker 容器。作者计划在第 2 篇用约 20 行中间件主动制造崩溃,展示崩溃或点 Stop 后怎么恢复。对工程团队来说,还要实测一个具体边界:如果封面已经下载成功,检查点却没来得及写入,恢复后会不会重复下载。
能拿来做什么
- 做日常 AI 编程任务时,把可核验的交付项拆成独立待办,例如改完组件、补齐调用方、跑过现有测试,并让助手在拿到执行结果后更新状态。
- 给重复使用的代码分析流程建一份按需加载的
code-analysis手册,把每次运行都适用的仓库规则留在AGENTS.md。任务里需要哪份手册,就加载哪份。 - 给 React 长任务界面接 SSE 时,把计划更新、工具调用、评估结果和最终状态送到界面。用户点了 Stop 或看见
FAIL,可以直接定位停在哪一步。 - 给 Node 任务执行器加恢复能力时,挑一个会写文件的步骤做中断测试。分别在写入前和写入后中断,检查恢复时能否继续交付,以及会不会重复写入。