浏览器 Agent 用增量反馈压缩令牌开销
AgentGo 是基于 Rust 和 CEF 的 Windows 浏览器,通过 MCP 提供精简页面轮廓、稳定元素引用与操作后差异反馈。作者在同模型、24 个 MiniWoB++ 任务中测得其完成 22 项,输入令牌与交互轮数均低于两款对照工具。
完整中文译文
我试过的所有网页 Agent 都有同一个问题:读得太多。浏览器工具把页面快照交给模型,模型点击后,又收到一份整个页面的全新快照。大部分 token 都花在了重复阅读那些没有变化的内容上。
于是,我做了 AgentGo:一款面向 Windows、基于 Chromium 的浏览器,用 Rust 在 CEF 之上构建,专门供 Agent 通过 MCP 驱动。随后,我拿它和目前大家最常用的两款工具做了对比测试。
测试使用相同的模型(gpt-6-luna,medium reasoning)、相同的 24 个 BrowserGym MiniWoB++ 任务。每个任务都开启全新的 Agent 会话,只允许使用对应浏览器的 MCP 工具,最终结果由页面自身的 reward 判定。
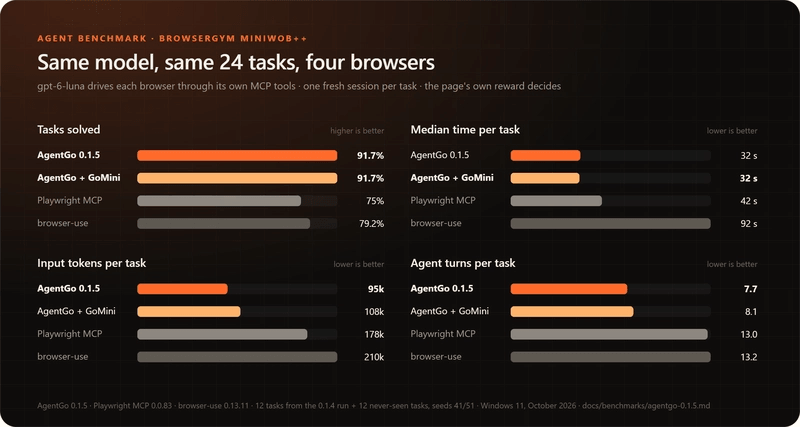
token 用量大约减半,交互轮次也大约减半,单个任务耗时的中位数最短。
为什么它用的 token 更少
主要靠三个设计选择:
用精简提纲代替页面快照。browser_open 返回标题和可操作的元素,每行一个,格式为 [ref] role "name"。页面发生变化时,这些 ref 仍保持稳定。
只返回发生变化的内容。执行 browser_act 后,返回的是差异:+ 表示新增元素,- 表示移除的元素,~ 表示值发生变化。模型不用重新阅读整个页面,就能知道刚才的点击是否生效。
让浏览器等待,而不是让模型等待。每次操作都会等页面稳定后再返回结果,Agent 就不必浪费交互轮次去调用 "wait",然后再读一遍页面。
它也是一款真正的浏览器,而不是测试框架:它有自己的指针和键盘,因此日期选择器、滑块以及监听按键的组件都能正常工作;Agent 可以使用自己独立登录的账号;付款或最终提交则会暂停,直到用户在浏览器窗口中批准。
有两个任务难住了所有测试配置,AgentGo 也不例外:
form-sequence-2:任务说明从未要求按下 Submit,因此没有任何 Agent 这么做。
click-pie:所有 Agent 都打开了饼状菜单并点击了目标菜单项,但页面没有认定这次点击有效。
测试本身也有局限:只用了一台机器,每个任务在每种配置下只运行一次,而且只用了一个模型。MiniWoB++ 的页面都很小;换一个模型,或者再跑一次,个别任务的结果就可能变化。完整的测试方法、每个任务的结果,以及另行在 20 个真实网站上进行的检查,都收录在 benchmark 报告中。
AgentGo 还附带 GoMini,这是一个在你自己的 GPU 上运行的小模型,参数量为 322M。它负责一些常规步骤,比如填入你提供的值,让大模型不必阅读每一个页面。在 13 类未参与训练的任务上,不同版本之间,它完成的子目标数从 65 个中的 15 个提升到了 39 个。它仍在开发中:开启后,AgentGo 同样完成了 22/24 个任务,但 token 用量略有增加。
AgentGo(Windows 11,免费):https://github.com/Moha2005269/agentgo
Claude Code:/plugin install agentgo --marketplace Moha2005269/agentgo-mcp
其他 MCP 客户端:安装程序可以连接 Claude Code、Codex 或 Droid,也可以运行 agentgo mcp。它也已收录于官方 MCP Registry,名称为 io.github.Moha2005269/agentgo。
这是我独立开发的项目。很想听听你遇到了哪些问题,以及希望我接下来测试哪些网站。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。