先定位代码入口,再让 AI 读代码和补测试
文章建议先用 ripgrep 找到真实入口,只向模型提供少量相关文件,再明确目标、约束和可验证的输出。示例用解析器对畸形 JSON 的处理说明如何把一次修复收敛为可审查的改动。
AI 深度解读
AI 编程助手最值得用的地方,可能是你还没开始写代码的时候。作者把它用在四件日常工作上:读陌生模块、把模糊的 bug 变成失败测试、提交前先审一遍自己的 diff,以及为偶发故障提出能验证的假设。
这些任务有个共同点:你能给模型一小份相关材料,也能独立核对它的输出。照着这套方法试一次,最省事的入口是提交前的 diff 自审,现成的改动就够用。
先找到代码入口,再把问题交给模型
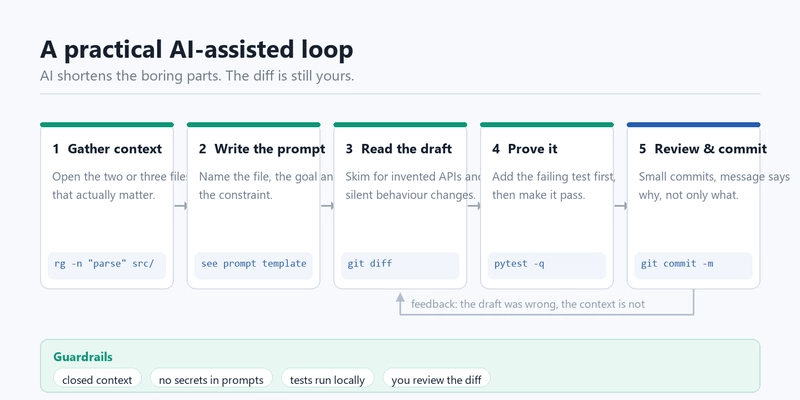
作者建议先花 30 秒自己找入口。他用 ripgrep 的 rg -n "def parse|class Parser" src/ 定位定义,再用 rg -n "parse\(" src/ --type py 查 Python 调用点。找到入口之后,只提供两三个真正相关的文件。整仓塞进去会增加认错同名符号的机会,也会把任务无关的文件内容一并交出去。
原文的提示词把事情交代得很具体:在 src/parser.py 和 tests/test_parser.py 的上下文里,让 parse_records() 遇到异常 JSON 时返回 [],保留公开函数签名和 I/O 错误的抛出行为,最后逐行引用改动并解释原因。要求引用具体行很实用。拿文件或实际 diff 一对,就能发现模型提到的改动是否真有那一行。
先用失败测试定行为,再用日志查原因
遇到描述模糊的 bug,作者建议由人先写测试,并在实现之前审过预期。下面这段测试通过 pytest 参数化,把三种输入的预期固定为 []。
import pytest

from app.parser import parse_records

@pytest.mark.parametrize("payload", ["", "{", '{"rows": "not-a-list"}'])
def test_malformed_payload_returns_empty(payload: str) -> None:
    assert parse_records(payload) == []
留意 @pytest.mark.parametrize 那一行。第三个输入能被解析成 JSON,只是 rows 的类型不对,因此测试也把数据形状纳入了约定。作者随后把 tests/test_parser.py::test_malformed_payload_returns_empty 报出的 json.JSONDecodeError 交给模型,限定它只改 app/parser.py,保留测试和现有依赖。如果模型觉得断言有问题,就停下来说明。这样,测试变绿仍然对应先前审过的预期。
偶发故障需要另一种问法。作者的例子里,app/sync.py 第 88 行的 sync_batch 读取 payload["id"] 时抛出 KeyError: 'id',样本里却有大写的 ID,值是 abc123。作者让模型结合日志、函数和样本,列出三种最可能的上游变化,并为每种原因给出一条能区分它的日志。字段大小写只是眼前的线索,补什么观测才能定位是哪一步改了字段,才是这次提问要拿到的结果。
提交前自审只问三类问题
开 PR 前跑 git diff --staged,把暂存改动交给模型,请它只报 bug、缺失的测试,以及会让下一个读者困惑的命名。某类没有发现,就写 none: <category>。范围小,结果也好核对。模型报出的问题逐条验证,实际 diff 仍然自己读一遍。
接受改动前,作者还会问:能否解释每一处改动,撤回修复后测试是否会失败,代码调用的 API 能否实际跑通,提交信息是否交代了改动意图。原文示例是 pytest -q && git add -A && git commit -m "return [] on malformed payload"。其中 git add -A 会把工作区的全部改动加入暂存,手里同时有别的修改时,要核对最终提交范围。
我的判断
这套做法讲得最扎实的是验证成本。失败测试给实现提供了明确目标,区分性日志给排障提供了下一步,窄范围的 diff 自审也容易人工复核。作者认为自审的投入产出比最高,但没给对照数据或节省工时的记录,这个排序属于经验判断。
前提是团队已经能说清预期。示例中的空字符串、残缺 JSON 和错误字段类型都应返回 [],这是测试写下的业务约定。要是接口调用方依赖异常做告警,这个约定就得先讨论,测试全绿也回答不了谁依赖旧行为。
原文对替代做法的取舍也有道理。刚接触一个领域时,先读文档更容易建立准确的概念。大范围重命名交给编译器和类型检查器更直接。生产数据迁移的错误可能悄悄发生,作者建议手写并复核两遍。涉及凭据或客户数据的任务,也不适合直接把原始材料交给助手。
能拿来做什么
- 下次接手陌生的前端或 Node 模块,先定位入口和调用方,再给助手两三个相关文件,明确要保留的行为,并要求指出支撑结论的具体代码行。
- 修输入解析问题时,先把空值、格式破损和字段类型错误写成失败用例。人工确认每种输入的预期之后,再让助手修改指定的实现文件。
- 提交前把
git diff --staged的输出交给助手,只查 bug、缺测和易误读的命名。用跑测试或读调用方验证每条意见,再决定是否修改。