Gemini 4 Hydrogen 上线 Copilot
谷歌发布面向日常编码和智能体任务的快速模型 Gemini 4 Hydrogen,支持百万 token 上下文和四档推理强度,每百万输入和输出 token 分别收费 1.50 和 7.50 美元。按文中引述的谷歌数据,Hydrogen 的默认推理档综合得分为 51,略高于 Argon 的 50,但其 Terminal-Bench 4.1 得分低于 Claude Sonnet 5.5。
AI 深度解读
Google 在 2026 年 11 月 12 日发布了 Gemini 4 Hydrogen,定位是 Gemini 4 系列里负责日常编码和智能体任务的快速档。按 Google 公布的数据,Hydrogen 在默认 high 档的综合指数拿了 51 分,比 Argon 高 1 分,切到 xhigh 则能到 54 分。
对前端和全栈团队来说,这次发布更值得看的是分项成绩和成本曲线。同一个模型有四档推理强度,在仓库修复和桌面操作上的表现也有差别。接入前要回答的是,平时交给 Copilot 或编码智能体的活,用哪一档做得完,每做成一单又要花多少。
百万 token 同一个单价,跑完任务要花多少
Google 把 Carbon 和 Argon 放在深度推理、长程任务的位置,把 Hydrogen 放在快速执行的位置。Hydrogen 提供 low、medium、high、xhigh 四个推理档位,high 是默认值,xhigh 是新增的最高档。交互式任务可以从 low 试起,能等到第二天再看的批处理可以试 xhigh。在 Google 公布的 Artificial Analysis Intelligence Index 耗时图里,Hydrogen 到达自身最高分时,用时仍比图中两款竞品达到各自最高分更短。文章没有给出能直接套到团队工作流上的延迟数据。
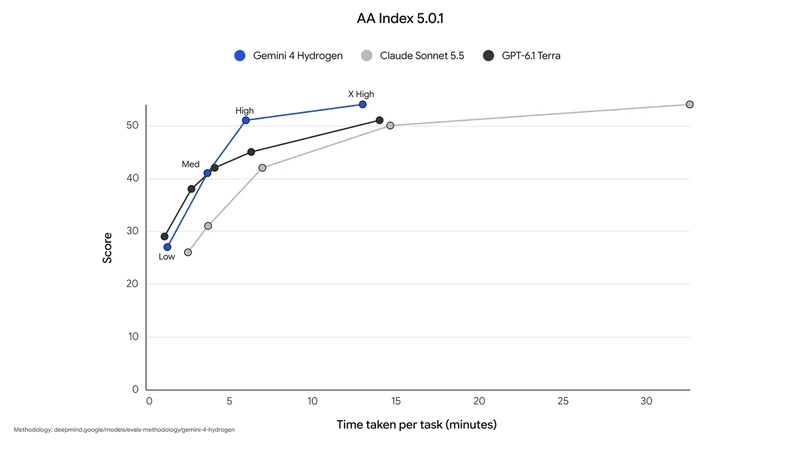
Hydrogen 的输入价格是每百万 token 1.50 美元,输出是每百万 token 7.50 美元。输入上下文上限为 100 万 token,原文称最多还可输出 100 万 token。整个输入窗口采用同一单价,所以塞进 90 万 token 的仓库和问一个 5,000 token 的问题,输入按同样的费率算,前者的输入费仍是后者的 180 倍。输出单价又是输入的 5 倍。让模型生成整份报告,和让它只返回改动与验证结果,账单会有明显差别。一次任务如果还要反复读取文件、调用工具和重试,评估时也得把这些尝试算进去。
综合分超过 Argon,仓库修复和桌面操作该怎么选
Google 的发布表列了十项对照。Hydrogen 在 SWE-sweep 上拿到 13.5%,Claude Sonnet 5.5 和 GPT-6.1 Terra 分别是 3.1% 和 5.8%。AutomationBench-AA 的三家成绩依次是 76.1%、71.8% 和 60.2%,HLE-Diamond 则依次是 58.8%、53.3% 和 47.3%。仓库缺陷修复和工具自动化,可以优先拿来做试点。
另三项给出了相反的排序。Hydrogen 在经过作弊校正的 Terminal-Bench 4.1 上是 57.0%,低于 Claude Sonnet 5.5 的 63.9%。OSWorld-2.1 是 77.6% 对 83.9%,Terminal-Bench-Science 0.1 是 51.4% 对 59.9%。如果智能体的主要工作是操作桌面软件,或者在终端里完成科学计算相关任务,这几行比综合指数更接近团队关心的问题。
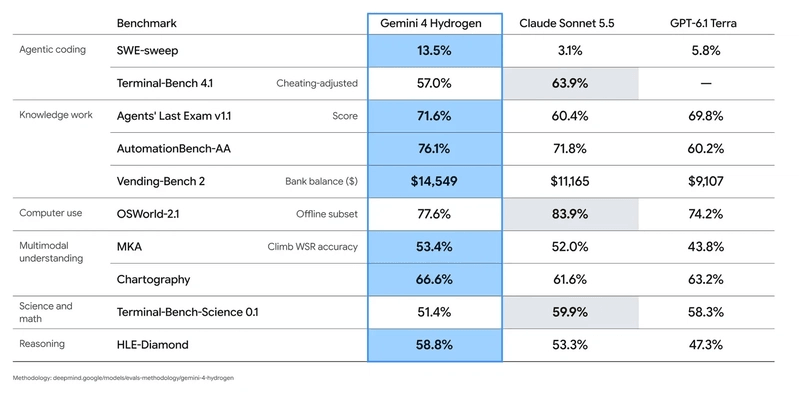
这里还有一个容易漏掉的细节。51 对 50 比的是 Hydrogen 和 Argon 的综合分,上面几组分项比较的是 Hydrogen 和另外两家模型。团队要决定是否把已有的 Argon 工作流迁过去,仍需要在同一批任务上让两个模型直接比较。SWE-sweep 的相对领先也要和 13.5% 的绝对成绩一起看,基准上的名次无法直接回答你们仓库里能合并多少个补丁。
同一个会话里,Carbon 和 Hydrogen 怎么分工
Google Antigravity 的 Orchestrator 能在一个会话内切换 Carbon 和 Hydrogen。按 Google 描述的并行方案,Carbon 负责协调,Hydrogen 在隔离工作区里执行和验证。放到一次编码任务里,可以理解为先由 Carbon 理清跨模块改动,随后由 Hydrogen 处理具体编辑、运行测试和检查结果。
Google 报告称,这套编排在 Terminal-Bench 4.0 上把任务成功率做到接近 Carbon,平均少消耗 24% 的配额,完成快 19%。这里用的是 4.0 版基准,前面单模型对比用的是 4.1。配额的降幅也需要按团队的计费方式解释。固定席位下,少用配额的直接收益是同一额度内能多跑一些任务,原文没有给出对应的美元节省额。
接入入口也会影响选型。Hydrogen 上线了 Gemini API、Google AI Studio、Android Studio 等入口,Antigravity 内面向付费 Google AI Pro 和 Ultra 用户。GitHub 于 2026 年 11 月 13 日按供应商标价把它带到 Copilot,覆盖 Pro、Pro+、Max、Business 和 Enterprise。Business 和 Enterprise 管理员通过 Copilot 设置里的模型策略控制访问。如果组织保留了默认启用,新模型会自动开启,管理员也可以关闭全局默认或单独禁用该模型。
我的判断
原文最扎实的做法是把评估单位放到「完成一项任务」。同一个修复需求,低档如果要多次重试,单次调用省下的 token 很容易被吃掉。反过来,如果改动范围明确、测试反馈快,直接给每个任务上最高档也可能只是多等一会儿。评估时要同时记成功率、实际档位的耗时和每个成功任务的总成本,才能看出差异出在哪。
原文给出的基准和编排结果来自 Google,Copilot 的上线与管理方式来自 GitHub。作者没有提供独立复测,也没给出同一批任务下自动编排、固定用 Hydrogen、失败后再升级档位的对照数据。「难题交给 Carbon,执行交给 Hydrogen」可以当试验假设,实际收益目前仍是厂商在特定基准上的结果。对任务类型比较单一的团队,固定档位加失败升级就能做出一个可比较的基线,也更容易查清钱花在了哪里。
能拿来做什么
- 从自己的前端或 Node 仓库挑一批已经有验收标准的修复任务,用 Hydrogen 的
low和默认high跑同样的测试。把失败尝试和工具重试记到同一任务里,再算每完成一项的成本和耗时。 - 给编码智能体安排一次工具调用失败、一次搜索结果为空的测试,观察它能否换路径、何时停止,以及最后能否交付可验证的结果。Google 把这一类行为列为相对 Gemini 3.8 Flash 的改进,文章没有给出你们工作流中的复测数据。
- 已经在用 Copilot Business 或 Enterprise 的团队,可以先看模型策略是否会自动启用 Hydrogen,再核对试用成员的编辑器里是否能选到它。这样能区分接入问题和模型表现,也方便按团队统计试用消耗。