编程 Agent 压缩上下文后会丢什么
文章用进程重启与交接笔记类比会话压缩:被读取却未写入摘要或文件的信息可能丢失,后续需要重新读取。开发者可在压缩前明确要求保留关键事实,减少任务恢复时的信息缺口。
AI 深度解读
Claude Code 或 Codex 在长会话里突然重读文件、追问已经回答过的问题,可能是上下文压缩丢了细节。作者把 compaction 比作进程重启:交接笔记和磁盘文件还在,只存在于旧对话里的信息可能已经消失。
这篇文章最有用的判断是:信息能否留下,与它如何进入会话有关。与其要求 AI 记住一切,不如识别哪些证据无法重取,再明确要求摘要保留。作者给了实验和配置示例,但 Claude Code 的小规模测试不能直接当作 Codex 的效果保证。
压缩以后,哪些信息还能回来
compaction 会用较短摘要替换原对话,让 agent 继续工作。作者的一次会话从 78,642 tokens 缩到 2,632,约二十秒丢掉了 97% 的上下文。界面仍然正常,缺失的信息也不会触发报错。
压缩后的上下文,是重新组装出来的工作现场。
作者把信息的去向分为三条通道:从磁盘重新加载、按预算直接保留、交给摘要筛选。判断某条信息会不会丢,先看它走哪条。
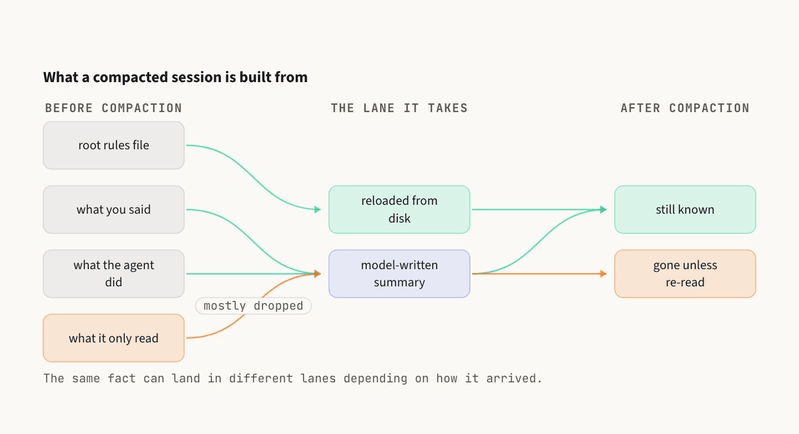
按原文描述,Claude Code 会重新加载根目录的 CLAUDE.md、auto memory 和计划文件,还会重读最多五个近期文件,每个文件低于 5,000 tokens。
带 paths: 的规则和嵌套 CLAUDE.md 则不同:它们以消息形式进入上下文,压缩时依赖摘要;只有再次访问匹配文件,才会重新加载。因此,「规则写在仓库里」还不够,加载位置也影响它跨越压缩的方式。
Codex 开源实现走另一套路径:从新到旧保留近期用户消息,预算最多 20,000 tokens,再加入摘要并重新注入起始上下文。更早的消息能留下多少,取决于摘要。
这里描述的是原文引用的实现路径。作者没有提供版本号,也没有实测 Codex,不能据此保证所有部署方式都完全一致。
实验支持的是「选择性遗忘」,不是固定丢失率
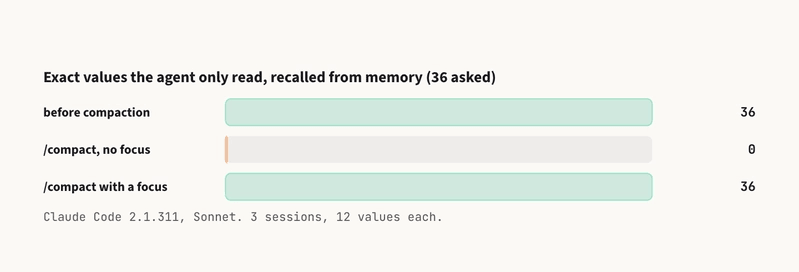
作者在三个真实 Claude Code 会话中植入信息,每个会话读取 25 个小配置文件,压缩后关闭工具,再让模型凭记忆回答。
实验里,所有指令都保留了,十个被编辑文件的信息也保留了,第二次压缩后仍然如此。只是读过的精确值,表现明显更差。模型在找不到值时也会承认缺失,即使提示要求它不要回答「unknown」。
摘要还会偏向当前任务。作者早先一次测试的最后任务是统计大于 5000 的 timeout;随后追问六个值,只有那两个超过 5000 的 timeout 留下了。摘要选择的是它认为对后续工作有用的信息,未必是用户下一轮恰好要问的信息。
作者还检查了自己会话中的 40 次压缩:只读标识符有 4% 进入摘要,作者或 agent 写过的标识符有 19% 进入摘要。这里的标识符是端口、路径、错误码等精确字符串。精确匹配会漏掉改写,所以作者建议关注两组差距,少把百分比当定律。
原文另引 Factory 对 36,611 条生产消息的研究:三种压缩方法在文件追踪上都表现最弱,评分只有 2.19 至 2.45 分,满分 5 分,尽管它们保留指令的表现较好。这与作者的小实验方向一致,但属于另一项研究,不能混成同一组证据。
真正该保存的,是无法重新取得的证据
配置值丢了,通常还能再读。失败测试的现场、生产日志、已经变化的网页、会改变状态的命令输出,未必能重现。重新执行一次,也可能得到不同结果。
最轻的干预,是在压缩前指定要保留的内容:
/compact Keep the exact failing test names, error strings and ids.
这条命令解决的是摘要不知道该优先保存什么的问题。要注意 Keep 后面列出的是精确字段;原文称,类似的定向要求让作者测试中的召回从 0 提升到 36/36,但没有证明任意长会话都能达到这个结果。
如果证据无法重取,先让 agent 保存到笔记文件。落盘提供了重新读取的机会,后续还要确保它确实会读。
Codex 可以在 ~/.codex/config.toml 设置 compact_prompt = "Summarize this session. Keep exact error strings, ids, file paths and test names.",把保留要求变成默认习惯。Claude Code 则可以在根 CLAUDE.md 加入 # Compact Instructions,正文写上 Keep exact error strings, failing test names, ids and every file edited.。
对于持续变化的状态,作者给出了 .claude/settings.json 配置:
{ "hooks": { "SessionStart": [ { "matcher": "compact", "hooks": [
  { "type": "command",
    "command": "git status --short; cat notes/session.md 2>/dev/null" }
] } ] } }
它会在压缩后的 SessionStart 阶段恢复工作区状态和笔记。关键是 "matcher": "compact",它限定触发时机;notes/session.md 也需要有人维护。
自己搭 agent 的团队,还可以把已编辑文件列表保存为结构化数据。原文的 rebuild(history, pinned, ledger, summarize, keep_tokens=20_000) 示例,用 newest_user_messages 保留近期消息,通过 ledger.edited 独立追踪文件,再将其与固定上下文和摘要一起放回会话。文件清单于是有了单独的数据来源。
验证同样要具体。原文提供的审计入口是 python3 code_example.py ~/.claude/projects/<project>/<session>.jsonl,但正文没有附脚本,单靠文章无法直接运行。
另一种验证是在压缩后分叉会话、关闭工具,询问精确事实:
claude -p --resume "$SESSION" --fork-session --tools "" "From memory, no tools. Which files did you edit? What was the exact error? Reply UNKNOWN if unsure."
其中 --tools "" 用来排除重新读取,UNKNOWN 让缺失变得可见。改动前后使用同一组问题,才知道配置是否有效。
我的判断
我认同「按恢复成本保存信息」这条原则。错误字符串、失败测试名、请求 id 一旦变模糊,后面的排查就容易走偏;能廉价重读的配置值,则没必要全部塞进摘要。摘要越长,后续每一轮都要承担更多 tokens。
但「指令和编辑信息一定保留」只能算作者测试中的观察。他明确说了:实验是单个模型上的小型合成会话,Codex 一侧没有实测。原文也没有系统比较手动聚焦、笔记、hook 各自的成本和收益,相关选择仍是工程经验。
此外,压缩后重读文件只是线索。工作区可能已经变化,agent 也可能主动核对状态,不能见到重复读取就断定摘要出了问题。
短任务不需要这套配置。任务已经换题时,原文建议用 /clear;大型研究可以交给 subagent,减少主会话承载的读取量。它们解决的是上下文组织问题,与提高摘要保真度各有适用范围。
能拿来做什么
- 排查前端或 Node 测试失败时,把准确测试名、错误全文和相关 id 保存到
notes/session.md,再要求压缩摘要保留这些字段。 - 长时间使用 Claude Code 时,先检查关键规则位于根 CLAUDE.md、嵌套文件还是带
paths:的规则中,再决定是否调整位置。 - 在自己的真实任务里选五个必须记住的事实,压缩后关闭工具提问,并允许回答
UNKNOWN;用结果决定是否需要增加配置。 - 自建 agent 时,独立维护已编辑文件列表和不可重现的证据,让摘要负责解释进展,让结构化记录负责保留精确事实。