批量研究 API:并发执行与逐项结果核对
文章用约百行 Python 调用 Valyu 批量研究 API,对 10 家支付公司执行仅限 SEC 文件的同一研究任务,报告耗时 4.9 分钟、费用 1.56 美元。实践强调保存批次 ID,并逐项核对输入与结果,避免仅查询已完成任务而漏掉失败项。
AI 深度解读
把同一份调研要求交给 AI,让它同时研究十家公司,难点往往在任务管理:报告有没有漏、失败怎么查、费用怎么汇总、不同公司的口径是否一致。Valyu DeepResearch Batch API 把这些事情收进一个批次,研究任务仍然逐家公司执行。
作者用十家支付公司的 SEC 年报做了一次测试:全部完成,耗时 4.9 分钟,总费用 $1.56,核对的 40 个数字全部匹配。比这组成绩更值得程序员借鉴的,是它如何统一输入、限制来源,并把每个输入核对到最终结果。
批量研究省下的,主要是任务管理代码
这个案例的问题很明确:从每家公司最近一期 Form 10-K 中,提取财年、收入及增长、净利润,以及管理层强调的三个风险因素。
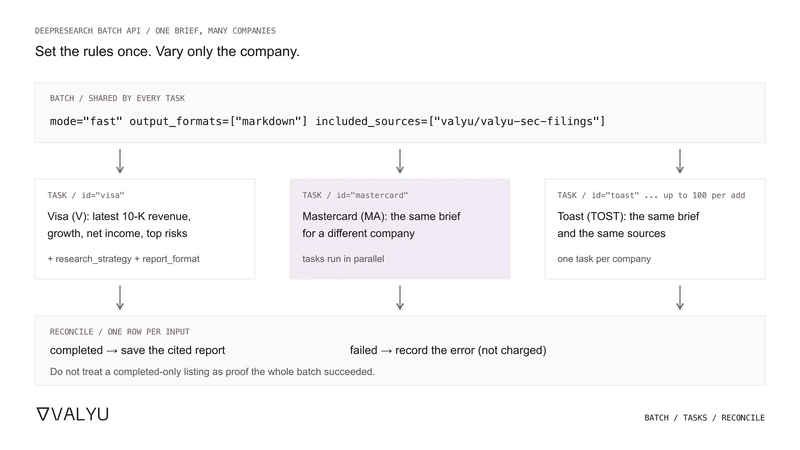
如果逐个创建 DeepResearch 任务,做到十家、五十家时,就得自己维护队列、任务 ID、状态和费用。Batch API 把公共配置集中起来,提供统一状态、结果分页、整批取消和完成通知。
配置分成两层:
- 批次统一设置
mode、output_formats、search,任务继承后不能覆盖。 - 每个任务可以分别设置
query、research_strategy、report_format、urls、metadata,以及自定义id。
Batch API 的主要价值,是让同一套研究要求稳定地应用到整张名单。
下面这段创建代码,把速度档位、输出格式和允许使用的数据源固定在批次上:
from valyu import Valyu

valyu = Valyu()  # reads VALYU_API_KEY

batch = valyu.batch.create(
    name="payments-10k-screen",
    mode="fast",
    output_formats=["markdown"],
    search={"included_sources": ["valyu/valyu-sec-filings"]},
)
重点看 included_sources:这里限定为 valyu/valyu-sec-filings,避免新闻、分析师预测和年报数据混在一起。作者还要求读取利润表与 Item 1A,每个数字引用申报文件,报告控制在 250 词以内。
安装命令是 pip install valyu,密钥通过 export VALYU_API_KEY=your-key 设置,并保留在服务端。前端接入时,这一步应该放在后端。
4.9 分钟和 40 个数字,分别证明了什么
作者使用 fast 模式研究十家美国上市支付公司。十个任务在加入后数秒内全部进入运行状态,最终十个完成、零失败,从创建批次到最后一份报告返回用了 4.9 分钟。
原文给出的顺序执行耗时约为 24 分钟。并行处理后,总耗时主要由最慢的任务决定。不过,实际并发仍受账户限制和服务容量影响,不能把这次成绩直接外推到任意规模。
作者把报告中的本年、上年收入与净利润,与 SEC EDGAR 的 XBRL 数据逐一比对,40 个数字全部一致。六份报告主动说明年报没有给风险排序,四份指出了一次性税收收益、终止经营或上年数据重列等可比性问题。
这些提醒比提取数字更有用。例如,Global Payments 的报告使用 FY2025,财年截至 2025 年 12 月 31 日,Form 10-K 于 2026 年 2 月 20 日提交。收入为 $7,705.9 million,上年为 $7,736.0 million,减少 $30.1 million,下降 0.4%。
但这组收入只覆盖持续经营的 Merchant Solutions;Issuer Solutions 已列为终止经营,因此不能直接与 2025 年以前的全公司收入比较。净利润为 $1,456.0 million,上年为 $1,644.2 million;其中归属于 Global Payments 的为 $1,400.1 million,另有 $55.9 million 归属于非控股权益。
报告列出的网络安全、软硬件缺陷、第三方依赖,也只是 Item 1A 摘要的前三项,并非年报认定的前三大风险。Visa 的财年在九月结束,Affirm 在六月结束,同样不能默认属于同一个自然年区间。
数字匹配只证明核对过的数字正确,不能替整份报告背书。
批次结束之后,还要检查有没有漏公司
这篇教程最实用的提醒,是先保存 batch.batch_id。本地进程退出后,远端研究仍会继续,有 ID 才能重新收集结果。
完整脚本约 100 行,拆成 python screen.py start 和 python screen.py collect <batch_id> 两个入口。收集时按 15 秒间隔轮询,再逐页读取所有任务。
下面这个函数解决分页读取问题,并检查每一页请求是否成功:
def all_tasks(valyu: Valyu, batch_id: str) -> list:
    tasks, last_key = [], None
    while True:
        page = valyu.batch.list_tasks(batch_id, include_output=True, last_key=last_key)
        if not page.success:
            sys.exit(page.error)
        tasks += page.tasks or []
        if not page.pagination or not page.pagination.has_more:
            return tasks
        last_key = page.pagination.last_key
关键是 list_tasks 没有加 status="completed" 过滤。只取成功任务会把失败和取消任务一起藏掉,让结果看起来很完整。完整脚本为每家公司在 reports/index.csv 写入状态、来源数量、费用、报告路径和错误。
wait_for_completion 遇到 completed 或 completed_with_errors 都会返回;批次取消或等待超时则抛出异常。因此,等待结束后仍需检查具体任务状态。
生产环境可以在 batch.create 中传入 webhook_url。用于签名验证的 webhook_secret 只在创建时返回一次,需要立即保存。
费用也要在提交前理解:创建批次免费,每次 add_tasks 接受 1 到 100 个任务,并预占该次请求所有任务的模式费用。余额不足会返回 402,整次请求一个都不会加入;失败任务不收费。超过 100 个任务,可以在批次处于 open 或 processing 时继续追加。
原文列出的单任务价格为:fast 25 credits、standard 100、heavy 500、max 2,500。此次总费用 $1.56 是作者的运行结果,原文没有给出 credits 到美元的完整换算依据。
我的判断
我认同先固定研究口径、再扩大名单的做法。来源限制、统一格式、自定义 ID 和完整状态记录,都能降低批量处理时的混乱。
但这仍是一次范围很窄的测试:十家公司、公开 SEC 年报、明确字段、fast 模式。作者没有提供不同模式之间的准确率对照,也没有证明复杂网页、多语言资料或非上市公司研究能达到同样效果。风险选择的质量,也没有像财务数字那样逐项验证。
与自己写循环相比,Batch API 的研究过程相同,优势在统一管理。已经具备成熟队列和任务监控的团队,应比较接入成本与节省的维护工作。
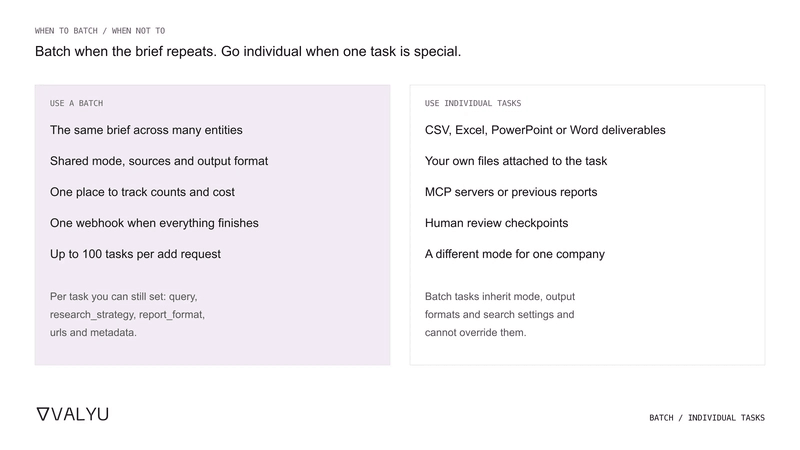
它也有配置边界。需要交付物、附加文件、MCP servers、人工审核检查点,或每项任务使用不同模式时,原文建议使用独立 DeepResearch 任务。批次任务中的代码执行始终开启。
需要进入数据库或表格时,可以让 output_formats 接受 JSON Schema,统一约束所有任务;它不能与 markdown 或 pdf 混用。作者此次只测试了 Markdown,结构化输出仍要先做小批量验证。
能拿来做什么
- 从已有的公司对照名单、投资组合或目标客户清单中挑五家,用
fast运行一次,先检查来源、财年和字段口径,再扩大规模。 - 用 Node 接入时,可以采用
valyu-js的valyu.batch.create、addTasks、listTasks。后端保存密钥、批次 ID 和原始查询,前端展示完成数、失败数与总费用。 - 给每项输入分配稳定 ID,并核对它是否对应到成功、失败或取消结果。收集报告时保留错误记录,避免页面只展示成功项而掩盖遗漏。
- 把财年结束日期、持续经营范围、重列说明一起存入结果。引用让报告便于检查,关键数字进入正式分析前仍需回到原始申报文件核验。