用双工具接口为 Agent 接入深度研究
教程使用 TypeScript 和 Vercel AI SDK,将深度研究拆成任务启动与结果查询两个工具,并保存任务 ID 获取带来源的报告。应用代码掌控研究范围、预算审批和任务身份,限制模型擅自追加调查。
AI 深度解读
给 AI Agent 接上深度研究,关键不只是多一个搜索入口,而是让它能提交一项范围明确的调查,过一会儿再取回带引用的报告。作者用 TypeScript 和 Vercel AI SDK 演示了这套流程:应用控制研究题目、费用授权和任务身份,模型负责调用工具、解释结果。
案例也很贴近工程现场:客服工单搜索已经有 PostgreSQL,到底要不要再引入 Elasticsearch?文章提供的是收集证据的办法,并没有替团队做架构决定。其中最值得借鉴的,是异步任务和付费操作该怎样划清边界。
研究工具该回答什么,才能帮到工程决策
能生成两套搜索代码,不代表能判断哪套更适合现有系统。关键词搜索、容错和过滤分别能靠数据库内置能力、扩展还是应用逻辑实现?多部署一个搜索服务,又要承担哪些运维工作?这些问题需要查文档、核对版本,最后回到自己的数据上验证。
Valyu DeepResearch 接收研究问题、调查要求和报告结构,在后台完成调查,再返回带引用的报告与来源记录。它与 Valyu Search 的区别在于任务分工:Search 把逐次查询和材料组织留给宿主 Agent,DeepResearch 则接走一项完整调查。作者没有提供两者的成本或质量对照,不能据此认定哪种始终更划算。
研究质量首先取决于 brief,也就是交给研究服务的任务说明。下面这段配置把证据范围和结论边界写得很具体:
export const BRIEF = {
  query: "Compare PostgreSQL full-text search and Elasticsearch for a support-ticket " +
    "search feature. We already run PostgreSQL and need keyword search, typo " +
    "tolerance and filters. Explain trade-offs and propose an evaluation plan. " +
    "Identify the product and extension versions covered by each source.",
  mode: "fast",
  research_strategy: "Prioritize official PostgreSQL and Elastic documentation. " +
    "Separate built-in features from extensions. Do not invent performance " +
    "benchmarks. Identify missing workload information and conflicting evidence.",
  report_format: "A concise decision brief with a feature comparison, operational " +
    "trade-offs, unknowns and a test plan. Cite factual claims. Do not claim " +
    "either option is faster without a relevant measured workload.",
  output_formats: ["markdown"],
  search: { search_type: "web", included_sources: ["postgresql.org", "elastic.co"] },
};
重点看 research_strategy 和 report_format:要求区分内置能力与扩展,标明版本,不准凭空生成性能结论。included_sources 限制到两个官方域名,只是缩小材料范围,不能保证资料完整或推理正确。
为什么必须拆成启动和查询两个工具
作者暴露两个后端工具:start_deep_research 创建任务,get_deep_research_status 查询已有任务。创建后保存 deepresearch_id,立即把控制权交回来,后续再取结果。
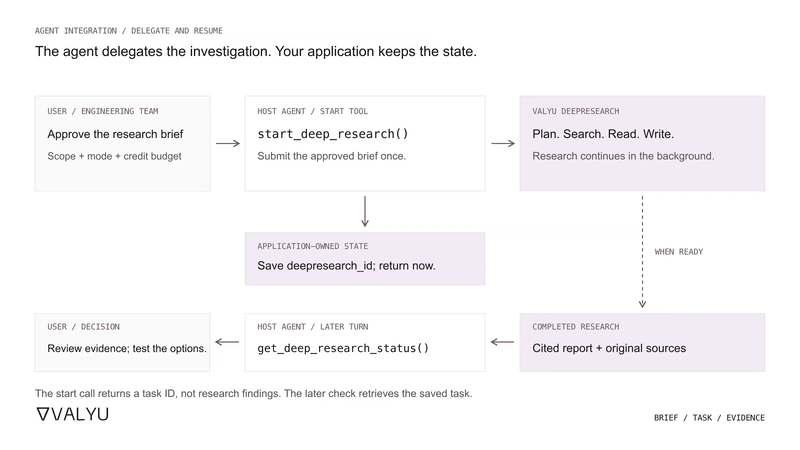
两个工具都不接收模型提供的参数。原因很直接:应用已经知道批准过的题目和当前任务,模型无需重新填写预算、授权或任务编号。把参数藏起来,也就减少了模型擅自扩大调查范围、查错任务的机会。
示例要求 Node.js 24.2 或更新版本,作者称已在 Node.js 24.12.0 检查过,使用原生 TypeScript 执行。依赖固定为 ai@7.0.143、@ai-sdk/openai@4.0.96、zod@4.6.7,项目通过 npm pkg set type=module 启用模块模式。
.env.local 配置 VALYU_API_KEY、OPENAI_API_KEY 和 OPENAI_MODEL。宿主模型需要支持通过 Responses API 调用函数,密钥留在服务端。REST 请求通过 fetch 访问 /v1/deepresearch/tasks,使用 x-api-key 请求头和 snake_case 字段;换用 valyu-js 时,要按 SDK 的 camelCase 选项填写。
执行分三步:
node research-agent.ts start只预览 brief,不联网,也不需要凭证。node --env-file=.env.local research-agent.ts start --approve-fast才授权创建固定的研究任务,并产生宿主模型调用。node --env-file=.env.local research-agent.ts check每次只查询一次状态;未完成就稍后再查,不能重新执行start。
作者引用的 SDK 建议是,fast 模式大约每 2—5 秒查询一次,手动操作可以更慢。每次调用宿主模型也有独立费用。代码中的 AbortSignal.timeout(30_000) 只约束一次 HTTP 请求,不代表后台研究必须在 30 秒内结束。
请求超时后,为什么不能直接重试
客户端没收到响应,不等于远端没创建任务。
付费任务最麻烦的情况,是 POST 已成功,返回任务编号的响应却丢了。此时自动重发,可能产生第二项调查和第二笔费用。
作者在请求前先占用本地任务位置,下面两行来自启动逻辑:
    await writeFile(statePath, JSON.stringify({ phase: "submitting", brief: BRIEF }, null, 2),
      { flag: "wx", mode: 0o600 });
关键是 flag: "wx":文件已存在就拒绝创建,避免再次提交。收到 deepresearch_id 后,再把 .research/task.json 更新为 submitted;如果停在 submitting,就去平台核对,不能为了重跑命令直接删文件。
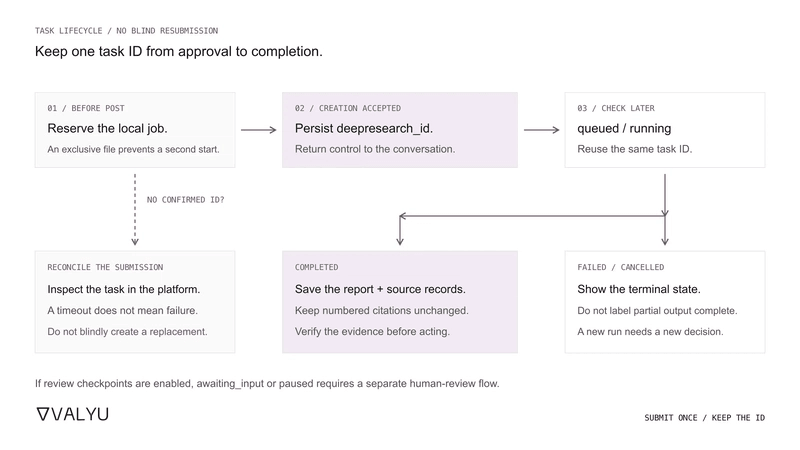
这不是完整的恰好执行一次机制。作者明确指出,即使收到确认未创建任务的 402 拒绝,本地占位也会保留,需要诊断后处理。它优先防止重复花费,代价是增加人工核对。
预算信息也要分清。代码在未授权时返回 mode: "fast"、credits: 25,但提供的原文缺少所引用的完整价格和模式限制表,不能把这个数字当成总费用承诺。作者标注价格核对日期为 2026 年 10 月 23 日;宿主模型、可选研究工具和额外交付文件可能另外收费。
按文中说明,创建任务会预留基础费用,失败任务不收费;取消 running 或 awaiting_input 任务收基础费用,取消 queued 或 paused 任务免费。时间上限也不是完成时间保证。
我的判断
这套方案最有价值的地方,是把付费授权和任务身份放进应用代码。模型可以提出调查建议,但模型生成的 approved: true 不能构成授权。相比让模型自己不断搜索、拼报告,这种方式适合把边界明确的调查交出去;是否更省钱、更准确,作者没有对照数据。
教程的可复现程度需要打个问号。提供的脚本在 check() 内部就中断了,工具定义和 Agent 循环没有完整展示,不能照抄后直接运行。原文还遗漏了部分表格和完成后保存文件的清单,无法确认所有落盘细节。
进入多用户产品后,本地文件也不够。任务、批准过的 brief 和预算要绑定用户或租户,查询报告前检查归属,并用数据库和并发控制替代单个本地位置。后台执行可交给 worker 或完成 webhook;webhook 要验证签名和时间戳,处理重复通知,并通过状态查询补漏。文中还提醒,取消任务不会触发完成 webhook。
报告应和来源记录一起保存。来源可能带引用片段位置,.passthrough() 会保留额外字段,但不保证每条都有。聊天里的摘要只是阅读便利,仍需核对原始证据;外部文本也不能获得执行命令、读取密钥或修改生产设施的权限。
结构化输出同样有接入成本。CSV 可以通过 deliverables 请求;非 instant 模式每任务最多十个文件。XLSX、PPTX、DOCX 需要 tools.code_execution,可能增加费用。文件要检查状态,签名下载地址会过期。若用 JSON Schema 配置 output_formats,不能混用 markdown 或 pdf,还得修改示例只接受字符串的校验逻辑。
能拿来做什么
- 给 Node Agent 增加研究能力时,可以先采用「创建任务、查询状态」两个接口,把批准的配置和任务编号存到服务端,避免把后台研究绑在一次页面请求里。
- 遇到 PostgreSQL 与 Elasticsearch 这类选型,可以直接借用 brief 的约束方式:核对版本、区分内置能力与扩展、列出未知条件,再用代表性工单和查询做评估。
- 前端展示研究结果时,应同时提供报告与来源,并在把 Markdown 渲染为 HTML 前做净化处理,让使用者能够检查具体主张。
- 需要把能力对照交给后续程序处理时,再选 CSV 或 JSON Schema,并同步调整结果校验、文件状态检查和费用授权范围。