AI 分析链路如何放大业务语义错误
文章指出,SQL 和 Python 即使执行成功,也可能因指标定义、表选择、关联扩行或数据粒度错误而产生错误结论。多步分析会继续放大上游偏差,因此需要检查业务语义,不能只验证代码能否运行。
AI 深度解读
SQL 跑通了,Python 没报错,图表也生成了,结论仍然可能是错的。原文讨论的是 AI 分析链路中的「语义错误传播」:第一步选错指标或关联方式,后续计算越复杂,越容易把错误包装成可信的业务解释。
作者的主张很明确:给分析 Agent 增加代码执行、统计和预测能力之前,先验证指标定义、数据粒度与表关系。对正在做数据问答、经营看板或 AI 分析助手的开发者,这比继续打磨总结提示词更值得优先处理。
为什么合法的 JOIN 能把金额算成三倍
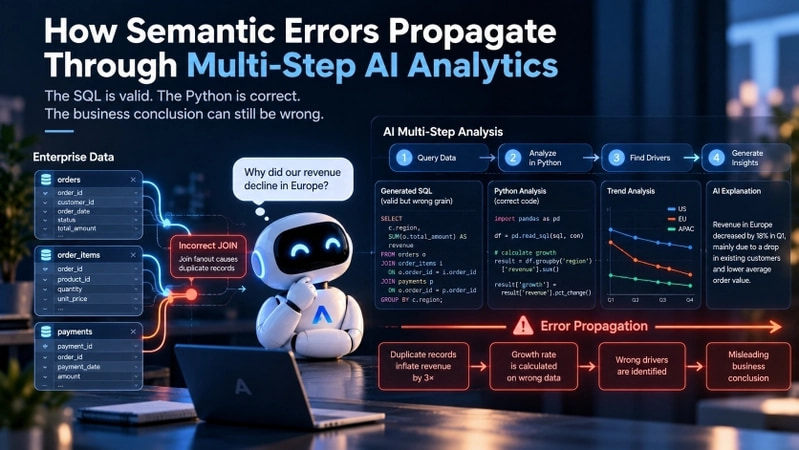
作者以 Databricks 于 2026 年 10 月 9 日宣布 Genie One 代码执行进入 Public Preview 为引子,讨论分析 Agent 从 SQL 查询走向多步骤计算后的风险。他明确说明,这是一种通用架构风险,并非指认 Genie One 存在具体缺陷。
风险可以从一个很小的订单例子看清楚。订单 42 有两条明细,金额分别是 100、50;同时有三条付款记录,金额分别是 60、50、40。订单明细合计与付款合计都是 150。
下面这条查询想汇总订单金额,却把两张明细表直接连在一起:
SELECT SUM(ol.amount) AS revenue
FROM order_lines ol
JOIN payments p ON p.order_id = ol.order_id
WHERE ol.order_id = 42;
要盯住的是 JOIN payments:同一订单的两条明细分别匹配三条付款记录,得到 2 × 3 = 6 行。每条订单明细都出现三次,SUM(ol.amount) 最终返回 450,放大了 3×。
数据库没有算错,它准确执行了一个不适合当前指标的查询。这类行数膨胀叫 fanout。
解决问题要先弄清数据粒度(grain),也就是「一行代表什么」。这里一张表的一行代表订单明细,另一张表的一行代表付款记录,不能直接把关联后的明细金额相加。
如果指标根本不需要付款数据,就不该引入 payments。确实需要同时比较两种金额时,可以先把双方都聚合到订单粒度:
WITH line_totals AS (
  SELECT order_id, SUM(amount) AS line_total
  FROM order_lines
  GROUP BY order_id
),
payment_totals AS (
  SELECT order_id, SUM(paid_amount) AS payment_total
  FROM payments
  GROUP BY order_id
)
SELECT l.order_id, l.line_total, p.payment_total
FROM line_totals l
JOIN payment_totals p ON p.order_id = l.order_id
WHERE l.order_id = 42;
关键是两处 GROUP BY order_id:双方先形成每个订单一行的数据,再组合。不要不分情况地加 DISTINCT,它不能替你判断哪些业务记录应该保留。
但粒度正确还不够。order_line_total 只是订单明细总额,能否叫「收入」,仍要由业务定义决定。
后面的 Python 为什么救不了前面的业务错误
作者把分析流程拆成:问题、指标解析、选表、JOIN、SQL,再到 Python、图表或预测,最后生成业务结论。
只要前面的金额已经膨胀,后面完全正确的程序也可能产出错误的地区收入、国家排名和预测结果。LLM 还可能为这些结果补上一段流畅解释,让一个并未发生的衰退或复苏显得有理有据。
后续计算正确,只能证明它忠实处理了输入,不能证明输入表达了正确的业务事实。
尤其不能认为「只是金额统一乘了一个倍数,增长率还能用」。作者指出,如果不同时期的付款记录数量不同,fanout 的倍数也会变化,增长率同样会失真。
原文用 run_sql(generated_sql)、groupby("country")["revenue"].sum()、pct_change()、forecasting_model.fit(revenue) 和 llm.summarize(...) 串起这条链路。这些是示意代码,不是完整实验。示例没有展开时间索引与排序,不能据此认定对国家分组结果调用 pct_change(),就得到了正确的时间增长率。
因此,分析链路要保留的不只是数据结果,还包括「这些数据到底在回答什么问题」。
每一步都该带着可验证的分析约定
作者提出四道正确性边界。
第一道是指标含义。「收入」可能指已下单金额、开票金额、确认收入,也可能指实际收款。它们各有用途,却不能混用。作者给出的示意定义选择 metric_id: recognized_revenue,归属 owner: finance,聚合方式为 aggregation: SUM,时间字段为 time_dimension: recognition_date,状态为 status: approved。这不是某个厂商的 API,而是一种设计建议。
第二道是业务概念到物理字段的映射。除了字段与类型,还要检查筛选条件和日期口径。「欧洲」可能指客户所在地、销售区域或法人实体;选择不同,答案就可能不同。
第三道是关系与粒度。存在可关联的键,不代表关联适合当前分析。需要检查基数、桥接表、空值行为和 fanout。作者建议在执行前比较关联前后的行数与业务键去重数,出现意外倍增就调查原因。
第四道是后续执行的一致性。指标、维度、过滤条件、时间窗口与数据集身份都要跨步骤保留,预测工具不能悄悄把确认收入换成开票金额。
作者因此建议传递结构化的「分析契约」,而不是只传 SQL。例如,把问题「欧洲上个财季的收入为什么下降」绑定到 recognized_revenue、sales_region、previous_fiscal_quarter 和订单粒度 order,同时记录 customer -> order、order -> revenue_fact 这样的关联路径。
验证状态必须来自实际检查程序,不能由 LLM 自己填写几个 true 就算通过。
这也解释了文中 Semora 与 IntaLink 的分工。按原文描述,Semora 负责业务语义、字段映射、数据源连接和查询管理;IntaLink 根据元数据与数据特征发现候选关系,并通过 API 提供路径。Semora 按数据源 ID 获取关系信息,实际数据访问与执行仍由自己管理。
候选路径只是线索,距离「这个指标可以安全使用这条路径」还差验证。作者也没有声称两者已经具备 Genie 风格的沙箱 Python 执行、自动预测或完整错误传播检测能力。
我的判断
作者最有价值的提醒,是把「运行成功」和「业务正确」分开。SQL 执行成功率适合衡量可用性,却不能证明指标选对了、关联没放大、结论有依据。这个区分适用于任何把自然语言接到数据库的产品。
不过,原文提供的是可推演的小例子和架构建议,没有生产实测、错误率变化或替代方案对照数据。四道边界是否足以覆盖某个团队的问题,需要结合业务验证,不能当成已经证明有效的完整方案。
还有两处前提。首先,团队要有可用的指标定义、负责人和关系元数据,否则「选择获批指标」缺少落点。其次,固定报表和已治理指标可以优先复用经过审核的查询或语义层;允许 Agent 动态选表、自由 JOIN 时,才更需要加强运行前验证。原文没有比较这些做法的成本与收益。
内容完整性也要打个问号:原文出现「上线前会运行的五个测试」这个标题,却没有列出五项,只补充了第六项「反事实一致性」测试。它要求把错误关系换成正确关系后,所有下游图表、统计与解释都重新生成,不能沿用旧缓存。这个建议很具体,但不能据此补出一套作者没写出的测试清单。
能拿来做什么
- 做 Node 数据分析接口时,把指标、时间口径、维度和粒度放进结构化请求,贯穿 SQL、Python 和总结阶段;含义不清的「收入」应触发澄清或受治理的默认规则。
- 给动态 JOIN 增加执行前检查,用真实数据或元数据比较行数、业务键数量与关联基数,优先拦截明细表直接互连造成的金额膨胀。
- 给分析看板保留指标、筛选条件、时间窗口和数据集依据;修正上游关系后,让下游图表、预测和文字结论一起重新生成。
- 评估 AI 分析助手时,同时关注指标解析准确率、JOIN 与基数验证通过率、粒度验证覆盖率、多步骤上下文一致性和端到端答案正确性,别只记录 SQL 是否执行成功。