模型选型应算每次成功任务的总成本
文章建议用真实业务任务、统一输入和验收标准比较模型,并记录版本、令牌消耗、重试和延迟。核心指标是全部尝试的总花费除以合格结果数,失败请求也计入成本。
AI 深度解读
选 AI 模型,只看每 token 价格,很容易把账算偏。作者提出的比较单位是:拿到一个达到交付标准的结果,实际花了多少钱。便宜模型如果频繁重试,最终可能更贵;单次调用贵的模型,也可能一次就完成任务。
原文没有公布模型跑分或省钱比例,而是给出一套小型基准测试方法。对正在给产品接入 AI 的开发者,它的价值在于把成本比较从价目表拉回业务结果。
一次请求便宜,不等于一个任务便宜
模型按请求消耗计费,用户却按任务是否完成来判断功能有没有用。这两个单位并不相同。
比如生成结构化响应,模型返回了内容,也产生了费用,但结果未必达到产品要求。如果还要再次调用,第一次的开销仍然属于这个任务。只比较某次请求的价格,就会漏掉拿到可用结果之前付出的成本。
作者建议采用这样的口径:
每个合格结果的成本=所有尝试的总费用÷合格结果数。
这里的分子必须包含失败尝试。不能只挑成功调用算账,否则越容易失败的模型,越可能被低估成本。
同时还要记录重试率和延迟。它们能帮助解释:一个报价便宜的模型,为什么在实际产品里未必划算。费用相近时,用户需要等待多久,也会影响选择。
怎样做一个能指导选型的小测试
作者建议从自己的产品里挑一个具体任务,例如工单分类、文档摘要或结构化响应生成。通用提示词离业务太远,即使跑出了结果,也未必能指导当前功能选型。
测试前先固定输入和成功标准,并提前定义什么结果可以接受。这个顺序很关键:如果看完输出才决定合不合格,就容易给不同模型采用不同尺度。
每轮测试还应记录模型及版本;能获取时,记录输入、输出 token 数;同时统计重试和失败尝试。原文在记录环节配了这张图:
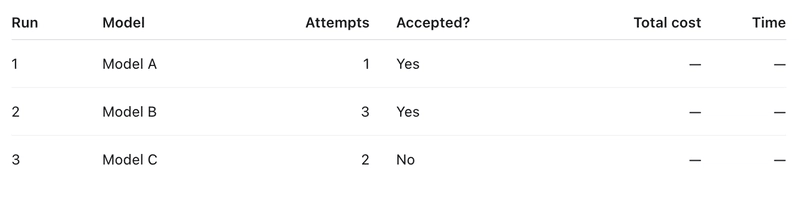
同一个任务要运行多次。模型输出存在波动,单次成功可能只是碰巧,单次失败也不能直接判定模型不可用。
原文没有规定重复次数,也没有提供样本规模、验收阈值或具体评测工具。因此,这是一套测试思路,还不是可以直接照搬的完整评测方案。
我的判断
我认同作者把比较单位改成「合格结果」。对于需要重试才能交付的 AI 功能,这比只看 token 单价更贴近实际支出。
但这个指标能否可信,首先取决于验收标准。结构化响应是否符合约定,相对容易检查;摘要是否保留关键信息,则需要更明确的判断规则。如果不同模型的合格标准不一致,最后算出的费用再精确,也难以比较。
还有一个边界:作者讨论的是模型调用开销,没有给出人工审核、工程维护等成本的计算方式。因此,「每个成功任务多少钱」仍不能直接等同于整个功能的完整成本。若一次都没有合格结果,也不能继续套用除法,应直接报告测试中没有成功交付。
作者没有提供模型间的对照数据。「贵模型可能一次完成,便宜模型可能反复重试」是合理的可能性,不是已经验证的普遍结论。原文也明确披露,作者正在开发面向独立开发者的 AI API gateway,产品为 micropenis.top;这篇内容同时带有了解潜在用户选型方式的目的。
能拿来做什么
- 给现有 AI 功能选模型时,先挑一个真实任务,例如工单分类,并在测试前写清分类正确的判定规则。
- 如果 Node 服务负责调用模型,就把模型版本、可获取的输入输出 token、费用、失败和重试记录在同一次任务下,方便汇总完整调用开销。
- 对结构化响应生成功能,用同一输入和验收标准重复测试,再一起比较合格结果成本、重试率和延迟。
- 遇到没有合格结果的模型,保留它已经产生的费用,并明确记录未成功交付,避免失败样本从选型报告中消失。