用可空字段和校验减少简历抽取幻觉
作者将模型职责限定为把简历提取成结构化资料,允许缺失字段返回空值,避免模型补造信息。输出受模式约束,并在服务端用 Zod 再次校验;失败后仅重试一次,不保存未通过验证的数据。
完整中文译文
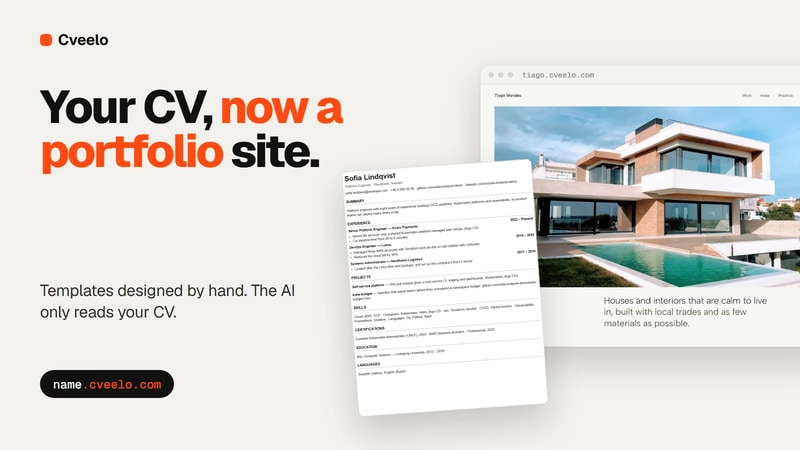
我正在开发 Cveelo,一款能把简历转换成个人作品集网站的工具。一开始,问题就很明显:如果让模型来“帮忙”处理某人的简历,它会很乐意给对方加上一个从未获得过的学位。下面是我如何让信息提取这一步变得平淡、可靠的。
规则:模型只读,绝不写
AI 环节只有一个任务:把简历中已有的信息提取成具有明确类型的个人资料。它不负责设计网站,也绝不改写个人成就。网站设计由人手工完成。
1. 让“我不知道”成为有效答案
schema 将所有可选字段都设为可空,也不提供任何看起来像真实数据的默认值:
const Experience = z.object({
  company: z.string(),
  role: z.string(),
  start: z.string().nullable(),
  end: z.string().nullable(),
  current: z.boolean().nullable(),
  description: z.string().nullable(),
});
(这是简化版,实际的 schema 更大。)如果简历里没有日期,模型就有一种符合 schema 的方式来表达信息缺失,而不必猜测。
2. 结构化输出加校验
我把简历文本发送给模型,并将结构化输出绑定到 schema。拿到结果后,我还会在自己这一侧再用 Zod 解析一次。如果校验失败,就重试一次;如果仍然失败,就把这次上传标记为失败。任何未经校验的数据都不会被保存。
3. 把简历当作数据,而不是指令
简历是用户提供的文本,因此里面可能写着“ignore previous instructions”。我在 prompt 中要求模型把简历中的所有内容都当作数据。我还会用一份包含注入指令的简历来测试,检查输出是否保持不变。
4. 明确告知扫描版 PDF 无法处理
扫描版 PDF 没有文本层。把空文本发送给模型,很容易换回来一段虚构内容,所以我会检测这种情况,并要求用户提供带有文本层的简历。目前没有加入 OCR,这是有意为之。
5. 只发送必要的信息
联系方式和原始简历文本都不会进入决策层,也不会发送到产品分析系统。决策步骤只能看到一份精简摘要。
如果重来,我会怎么做
[在这里补上一两个你确实犯过的错误,坦诚地写出来。相比文章里的其他内容,读者更相信这些。]
如果你想试试,目前可以免费使用:cveelo.com。我很想听听你会用什么办法让它出问题。
如果需要采取进一步措施,你可以考虑屏蔽此人,以及/或者举报滥用行为。