AI 写出应用之后,架构如何跟上增长
作者复盘使用 Cursor 和 Claude 构建占星计算应用,并获得约 50 万次自然搜索点击的过程。文章从 Next.js 和客户端计算的初始方案切入,讨论真实用户增长后需要人工介入的架构与性能决策。
AI 深度解读
一个用 Cursor 和 Claude 写出来的占星计算网站,在最近 12 个月拿到了 48.1 万次自然搜索点击。但作者真正想讲的,不是 AI 能多快生成页面,而是网站有了真实用户之后,性能、成本和计算正确性怎样一步步逼着架构改变。
这段经历值得看,是因为它把 AI 编程最容易省略的后半程摊开了:从免费托管、浏览器计算,到 VPS、缓存和独立 Python API。AI 帮作者快速起步,后续每次关键调整,仍然需要人发现问题、判断原因并验证结果。
页面能生成,不代表服务已经准备好了
项目最初很轻:Next.js 承载网站,浏览器里的 JavaScript 完成占星计算,开源地点 API 提供位置搜索,Supabase 免费套餐保存评论和反馈。用户输入信息,拿到结果就离开,服务端承担的工作很少。
内容也走低成本路线。AI 生成文章,作者发布到 Sanity Studio;Sanity webhook 触发部署,Next.js 在构建时读取内容并做静态生成(SSG)。访问者拿到的是预先生成的页面,因此日常访问不会反复查询 Sanity,免费套餐足够使用。
作者把 Cursor 配置文件、skills 和 commands 整理好后,新增计算器页面常常能一次生成出来。这说明重复页面适合交给 AI 扩展,但不代表计算逻辑已经得到可靠验证。作者自己也承认,他起初完全不懂占星数学。
月用户约 5K 时,Vercel 免费套餐运行正常,先出问题的是地点 API 配额。几乎每种计算都要输入位置,重复搜索不断消耗调用次数。作者在前面加了一层 Upstash Redis,缓存地点查询结果,减少对上游 API 的请求。
这一步解决了当时的瓶颈,也留下了下一层限制:Upstash 免费套餐同样有额度,只是更难碰到。
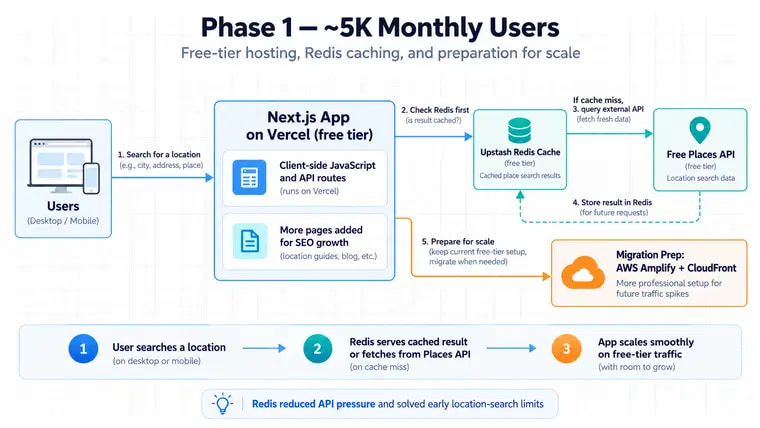
随后,作者为了应对未来流量增长,主动迁到 AWS Amplify,并配合 CloudFront。他明确说,这次迁移在当时并非必需。不要把这条个人路线读成「到了 5K 用户就该上 AWS」。
流量增长后,性能和部署成本开始相互牵制
作者在这一阶段持续分析 bundle 大小,用 knip 检测无用代码,简化组件,移除较重的 UI 组件库,并把星盘库改成懒加载,避免它进入首批加载代码。
更有参考价值的是观测方式。他通过 JavaScript Performance Observer 收集真实用户指标,写入 Supabase,再自行搭建看板,没有采用 Sentry 或 New Relic。真实用户监测(RUM)让他看到:不少用户的设备远慢于开发者手里的电脑。
性能优化要跟着真实用户持续做,不能以开发机上的一次跑分结束。
原文给出的移动端 Search Console 报告中,229 个 URL 被评为良好,没有较差或需要改进的 URL。这是实际观测结果,但文章没有提供优化前后的逐项对照,无法判断每个改动各贡献了多少。
月用户约 10K 时,AWS Amplify 仍运行顺畅,Lambda 和 CloudFront 的费用却开始让作者不满意。项目只有 Google AdSense 这一种变现方式,他不想把收入大量交给托管平台。
另一个限制来自构建产物。作者已经为自然搜索发布了约 200 多个页面,全部做 SSG,产物持续膨胀。他称自己遇到了 AWS Amplify 和 Vercel 的 200 MB bundle 限制。原文没有交代具体部署模式、限制口径或套餐条件,因此这里应理解为他当时遇到的限制,不能直接套成两家平台所有场景的统一上限。
月用户约 30K 时,他迁到 Ubuntu VPS,用 Coolify 管理部署,再由 Cloudflare 承担缓存。这样摆脱了先前托管环境的产物大小限制,按作者的描述,成本也更低。
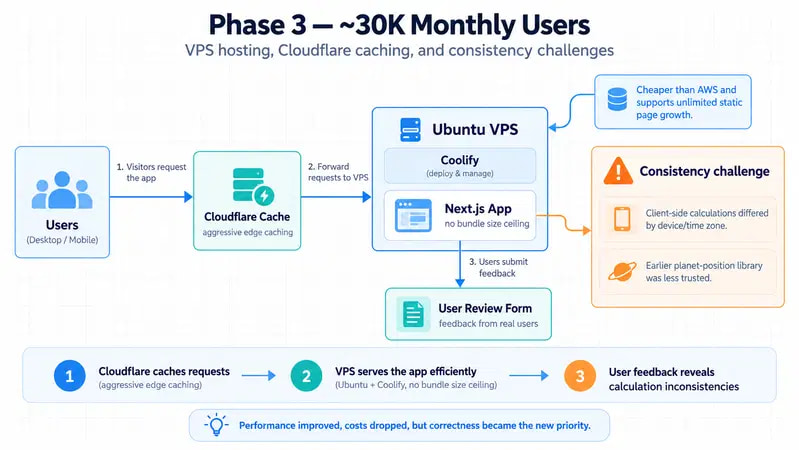
作者对进入 VPS 的请求采用了积极的缓存策略,并在部署或内容变化后调用 Cloudflare 清理缓存。他还报告 Lighthouse 指标有所改善。
原文展示的 Cloudflare 最近 24 小时数据,排除机器人后为 1.54K 次访问、3.92K 次页面浏览,97% 的 LCP 测量结果良好。LCP 衡量主要内容的呈现速度;这些数据能说明当时的访问体验,却不能单独证明迁移带来了多少收益。
计算移到服务端,首先是为了统一结果
比费用更棘手的问题来自用户反馈:计算结果不对。
作者调查后,将问题归到两处。第一,计算在用户浏览器中执行,存在跨设备结果差异和时区处理不一致。第二,最初选择的行星位置库并非专业计算器常用方案,计算方法也未必符合用户预期。
这里要把作者的诊断和可复用结论分开。浏览器计算并不天然错误,JavaScript 也不天然无法统一结果;真正需要核查的是算法、输入、时区和运行环境。文章没有给出最小复现,无法进一步确认各因素的影响。
与此同时,作者准备开发移动应用,希望 Web 和移动端返回相同结果。继续在各客户端维护计算逻辑,会增加一致性维护的难度,于是他部署了独立 Python API,并限制只有自己的 Node.js 服务能够查询它。
最终链路是:Web 和移动应用请求 Node.js,再由 Node.js 调用 Python 计算服务。核心规则集中在一处,各端展示结果。
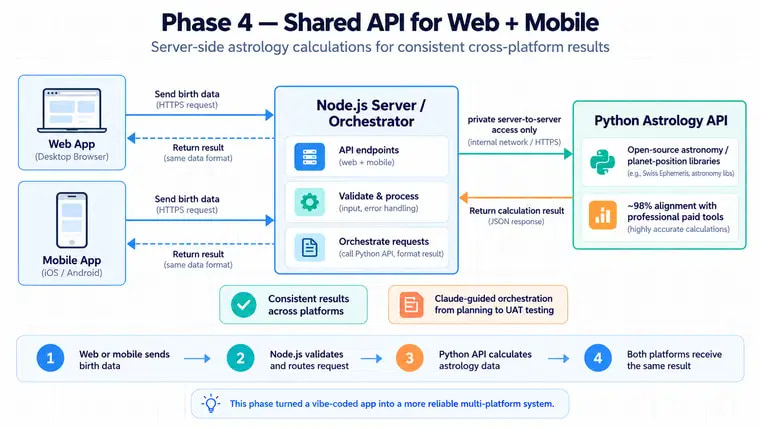
作者称,对照专业付费库后,计算正确率达到 98%。不过原文没有说明样本量、误差容忍范围、测试案例或具体依赖,这个数字只能作为作者报告的结果,不能理解成已经完成独立验证。
他还表示,借助 Claude 的严格编排,建立了从规划到用户验收测试(UAT)的流程;计算移出浏览器后,Next.js 的 INP 明显改善。INP 衡量交互响应速度,减少主线程计算确实有合理的改善路径,但原文没有给出前后数值。
我的判断
这篇最有价值的部分,是作者愿意根据真实问题修改最初的 AI 产物。页面生成很快,并没有让他跳过反馈、性能监测和计算校验。
项目启动至写文约 15 个月。最近 12 个月的 Search Console 数据是 481K 点击、4.23M 展示、11.4% 平均点击率,平均排名 7.6。标题里的约 50 万,指的是搜索点击,不是独立用户,也不是月活。
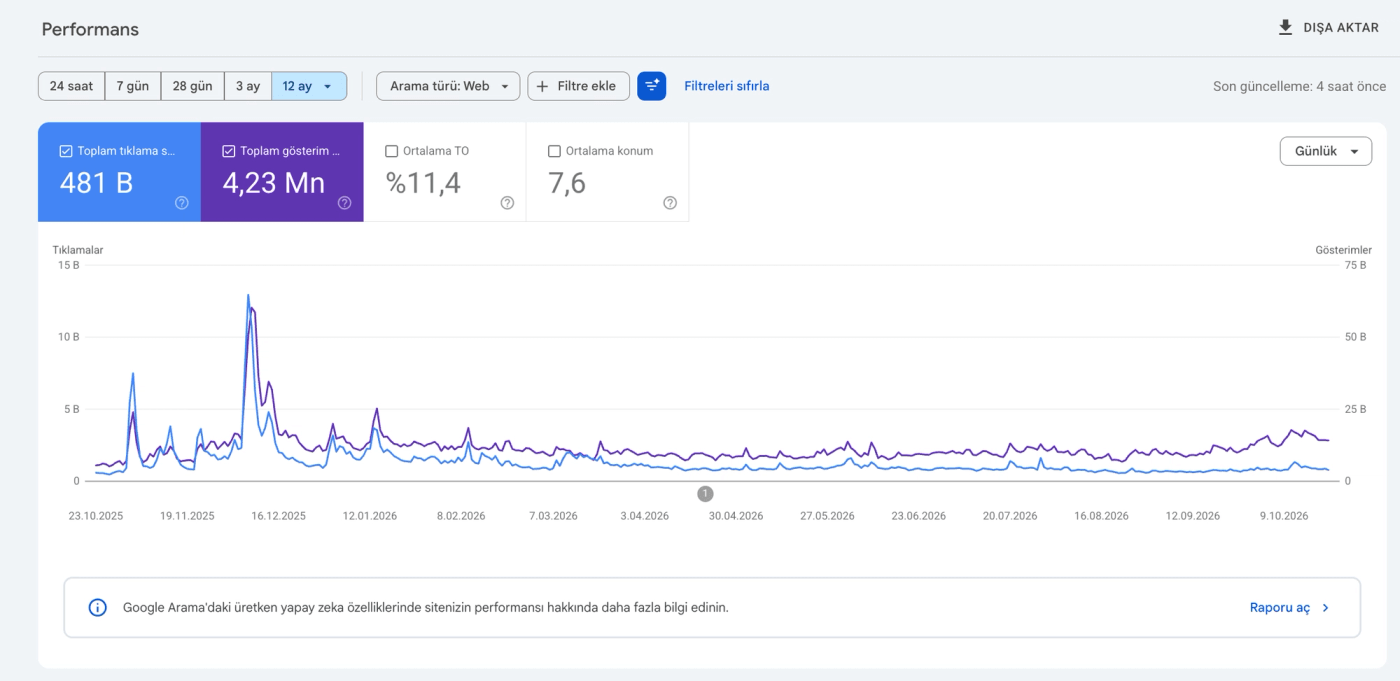
但这些结果不能全部归功于 AI 或架构迁移。作者持续扩展了 200 多个页面,内容覆盖、搜索需求和运营时间都可能影响流量,文章没有提供对照数据。claude-seo skill 被作者认为有用,也属于使用感受,没有量化它带来的增量。
VPS 更便宜、自建 RUM 更合适,同样有前提。作者熟悉性能,也愿意自己承担部署、监控和缓存维护。一般团队需要把这些时间成本算进去,托管平台和成熟监控服务依然是合理替代方案。原文没有账单明细,不能据此判断哪种方案普遍更省。
AI 能加速实现,但业务正确性仍需要独立的验收依据。
尤其当作者不熟悉领域知识时,「代码跑通」与「答案可信」之间还有很长一段距离。将算法集中到 API 能方便统一修复,却不会自动让算法变正确。原文提到 Python 开源社区提供相关实现,但没有给出库名、许可证或与专业数据源的具体关系,这部分仍需另行核实。
能拿来做什么
- 做 Next.js 内容站时,可以参考 Sanity webhook 触发构建、SSG 页面承接访问的方式,同时记录构建耗时和产物大小,避免只看页面数量,不看部署限制。
- 给地点搜索这类重复率高、上游有配额的请求加缓存前,先确认调用是否集中在重复查询,并同时跟踪缓存服务和上游 API 的额度。
- 优化前端交互时,先收集真实用户指标,再决定是否懒加载重库、缩减组件依赖或迁移计算逻辑;开发机跑分快,不能代替用户设备上的体验。
- 用 AI 开发领域计算功能时,先准备可对照的验收案例,覆盖时区和跨端输入;需要 Web 与移动端共享规则时,再考虑通过 Node.js 接入统一计算服务,并要求 AI 产出接受同一套校验。