把 AI 编程会话变成可检验的学习记录
作者通过自动化钩子和技能,将 AI 编程会话连接到 Obsidian,记录心智模型、技术取舍和架构决策演变,并区分已验证事实与假设。系统提供不同记录模式,并通过概念关联和阶段测验检查理解程度。
AI 深度解读
AI 把任务做完了,你却未必能解释代码为什么这样写。作者担心的正是这种「能力错觉」:构建通过、架构推进,看起来进展很快,实际积累的可能只是调度 AI 的熟练度。
他的办法是把 Obsidian 接进 AI 编程流程,让 agent 顺手记录理解、串联概念,并在阶段结束时出题检查。值得借鉴的是这套学习闭环,但文章没有给出配置代码或对照实验,效果仍属于作者的个人反馈。
笔记库该存什么,才能避免变成另一份文档
作者把 Obsidian 知识库放在 Engineering/,通过自动化 hooks 和 skills 连接 AI agent 会话。文章没有说明这些机制的具体实现,因此它提供的是工作流设计,不能直接照着安装运行。
知识库的第一条规则很严格:不重复仓库文档,也不收集通用模板。它只记录心智模型、架构类比、真实取舍、放弃的方案,以及架构决策记录(ADR)和变更历史。
这一区分很实用。仓库文档回答「系统怎么用」,学习笔记则应回答「为什么这里这样设计,当时排除了什么」。
作者还用 [V] 标记已验证事实,用 [A] 标记假设。它能提醒读者区分证据和推测,不过原文没有交代谁来验证、验证到什么程度。标签本身不能保证正确,AI 写出的解释也需要核对。
笔记的价值,在于留下决策理由和理解依据。
三层流程怎样把学习接进编码
作者把系统分成三层:项目模式、后台概念提炼、里程碑考试。
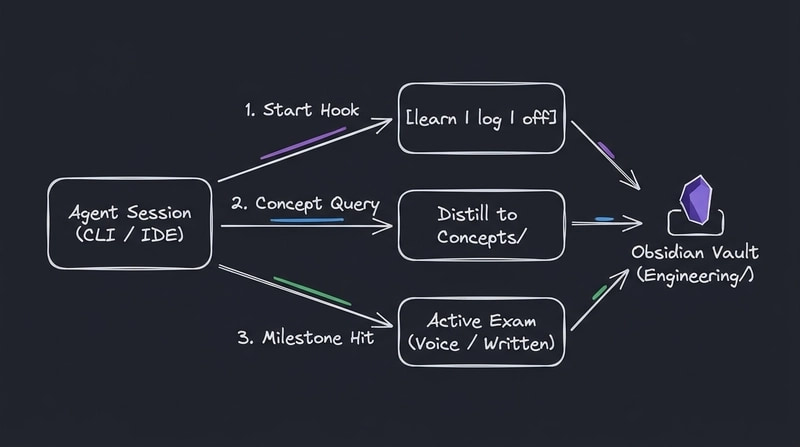
第一层决定投入多少精力。agent 在仓库中启动会话时检查配置:
learn提供完整学习流程,生成架构笔记、关联概念,并触发里程碑考试。log只记录 ADR 和概念链接,减少学习流程的负担。off不向知识库写入笔记,作者将它描述为零额外开销。
这个分档很关键。探索陌生架构适合深入追问,常规维护则未必需要每次都生成一套学习材料。
第二层发生在提问之后。作者在会话里问「什么是 backpressure」或「为什么这里选这种并发模式」,agent 先回答,再把概念存入 Concepts。
新条目先写成 3–5 行的 Term,包含定义、简短例子和问题出现的上下文。同一模式在不同项目里反复出现后,再在原条目中扩展为更深入的 Concept,相关链接嵌入正文。
这比一开始就让 AI 写长篇百科更贴近实际学习:先保留当前问题的解释,再用后续经历补充它的适用范围。
第三层负责检查是否真的理解。learn 项目达到里程碑后,agent 会提出一次考试,包含 10–12 道开放题,不用选择题。作者的理由是,选择题更容易检查识别能力,而开放题要求主动回忆。
题目必须来自实际仓库代码、已经做出的决策和真实遇到的 bug,涵盖代码阅读、故障场景和修改影响。例如,明天替换依赖 X,哪些地方可能出问题,为什么?系统也支持通过语音和转写进行口头作答与评估。
作者给「学会」设定的标准是:能解释并捍卫架构选择。仅仅把笔记存下来,还不够。
我的判断
这套方案最合理的地方,是把记录和检查绑在真实开发过程上。读代码、解释故障、推演依赖替换,比泛泛回答一道概念题更容易暴露理解缺口。
和单纯让 AI 总结会话相比,它多了一次主动回忆;和单独维护知识库相比,它保留了概念出现的工程上下文。代价则是需要维护自动化连接、整理条目,并花时间完成考试。原文没有给出这些成本。
作者反馈,隔了两周再回到代码库时,代码不再陌生;在 Rust 或 Go 中排查 bug 时学到的概念,也能关联到数月后的 TypeScript API 决策。但这些都是个人体验,没有对照数据,不能据此确认长期记忆提升了多少。
还有一个前提需要补齐:同一个 agent 既生成解释,又出题和评价,可能反复强化同一处误解。文章没有说明评估标准,也没交代如何用代码证据校验答案。因此,我更倾向于把考试当作发现盲点的入口,答得流畅不等于答得正确。
能拿来做什么
- 在 AI 编程会话结束时,只留下本次关键决策、放弃的方案和待验证假设,并用
[V]、[A]区分状态,避免复制整段聊天记录。 - 遇到 backpressure、并发控制等概念时,先写 3–5 行,带上当前代码中的例子;下次在别的项目遇到,再补充差异和边界。
- 完成一次 TypeScript API 改动或 bug 修复后,让 agent 根据真实 diff 和故障过程出开放题,重点检查「为什么这样改」和「改动会影响哪里」。
- 按任务选择
learn、log、off,把完整考试留给需要掌握的模块,并回到仓库核对答题中不确定的结论。