如何验证编程代理指令真的有效
文章指出,修改AGENTS.md或技能后单次成功,不能证明指令带来了提升。评估应复现原始失败、在可比条件下对照候选指令,并检查回归与任务完成证据,避免只追求更少工具调用。
AI 深度解读
给 AGENTS.md 加一条规则,编码代理下一次就把任务做对了,这能证明规则有效吗?作者的答案是:还不能。任务难度、执行路径和运行条件,都可能让一次成功看起来像指令改进的功劳。
作者正在开发开源项目 Agent Harness Lab,尝试把指令优化变成可复现、可比较、可检查的实验。它值得关注的地方是评估流程;至于能否普遍提升编码表现,作者明确没有给出这样的结论。
下一次成功,为什么还不能证明规则有效
设想一个编码代理反复犯错,你补了一条指令,要求它编辑代码前先检查某件事。下一次它成功了,很容易让人觉得问题已经解决。
但这里至少有三个疑点:这次任务是否更简单?代理是否碰巧换了一条执行路径?之前的失败是否真的能够稳定复现?
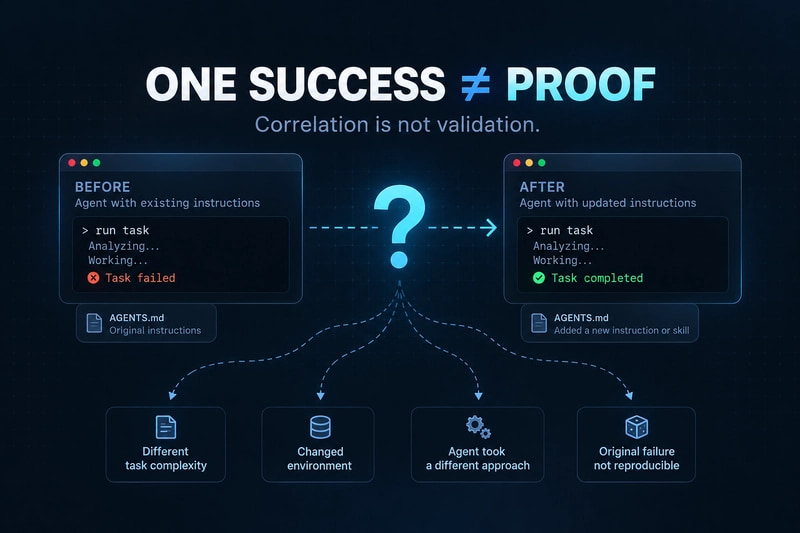
一次成功可以成为继续验证的理由,却不能单独证明指令有效。
作者希望评估回答五个问题:原来的错误能否复现,新指令能否解决它,原本正常的行为是否仍然正常,修改前后是否在可比较的条件下运行,以及保留修改前能否检查证据。
其中第三个问题很容易被忽略。给代理加上严格检查,可能修好某个任务,却让另一个任务变慢或失败。工具调用次数减少也不能单独算进步,前提是要求的工作仍然完成了。
Agent Harness Lab 把哪些步骤串起来了
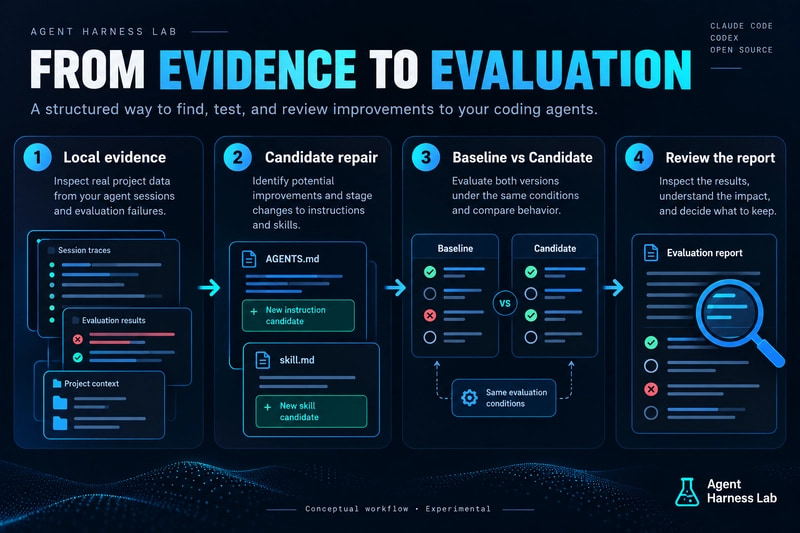
Agent Harness Lab 支持 Claude Code 和 Codex。按照作者的描述,它可以检查本地项目证据,寻找值得尝试的改进候选,不要求使用者先手动写清楚故障经过。
实验流程包括暂存候选修改、创建评估任务、比较基线与候选版本的行为,最后报告结果。这里的「基线」,就是修改指令前用来对照的版本。
如果只想先看项目分析,可以使用这个入口:
ahl analyze /path/to/project
需要看清的是 analyze:作者明确说,它生成本地分析报告,不运行代理,也不修改项目指令。
更完整的改进流程使用另一个命令:
ahl improve /path/to/project
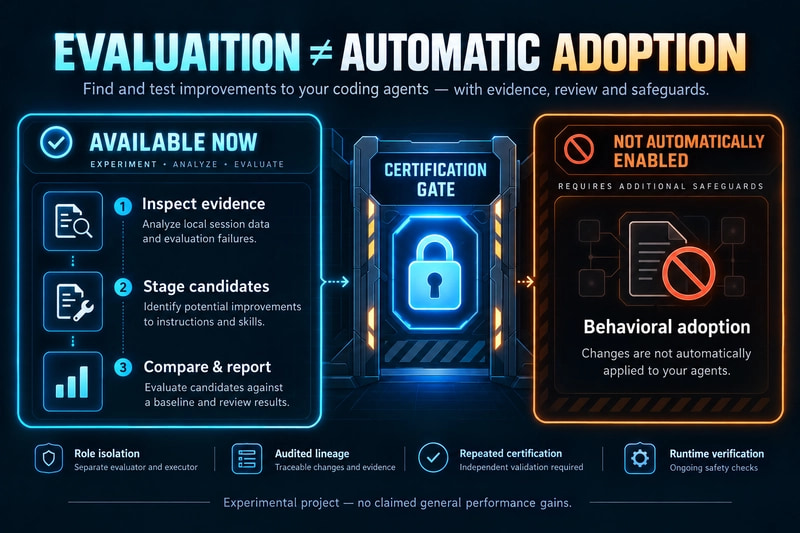
需要留意的是 improve 的边界:它对应更广的实验流程,并不代表候选行为修改已经可以自动采纳。当前独立认证要求尚未满足,自动采纳仍被阻止。
项目采用 MIT 许可证,仓库包含安装说明、评估契约、验证文档,以及启用行为修改采纳前仍需补齐的保障措施。原文没有展示具体评估任务、评分细则或量化实验结果。
我的判断
我认同作者把「修好一个例子」和「可靠地改进指令」分开看。相比不断往 AGENTS.md 追加规则,这套思路多问了一步:新增规则会不会破坏已经能做好的事情?
不过,流程可以检查,不等于评估结论已经可信。
让代理评估代理,仍可能奖励错误行为,也可能只对开发时用过的几个例子有效。运行条件变化,还可能被误认为指令收益。作者主动承认这些问题,是合理的边界说明,不能当成问题已经解决的证据。
和人工挑几个任务重跑相比,这个项目尝试把候选修改、对照过程和结果组织起来。但它是否更准确、更省时间,原文没有对照数据。一般团队能否采用,也取决于是否留有可复现的故障证据,以及是否能维持可比较的运行条件。
能拿来做什么
- 修改前端或 Node 项目的 AGENTS.md 前,先保存触发错误的任务和判定标准,让下一次运行能够重现同一个问题。
- 为新规则准备两类任务:一类验证原来的错误是否修好,另一类检查此前正常的工作是否仍能完成。
- 比较修改前后的结果时,记录模型、工具权限和运行环境,把任务是否完成放在工具调用次数之前判断。
- 如果想试用 Agent Harness Lab,可以先运行
ahl analyze /path/to/project查看本地报告,再根据证据决定是否进入更完整的实验流程。