ApplyOS 用版本快照绑定 AI 分析结果
ApplyOS 在 Next.js、TypeScript 和 Supabase PostgreSQL 实现中,分别存储原始简历文档、已保存的版本快照和分析结果。每次岗位匹配分析关联具体的求职申请和简历版本,编辑简历后仍能追溯旧反馈对应的输入。
AI 深度解读
在 ApplyOS 里,同一份上传简历可以改出多个保存版本。用其中一版跑完 Job Fit,再切到另一版,页面应该显示哪份反馈?作者 Najib Oladosu 用 Next.js、TypeScript 和 Supabase PostgreSQL,把结果绑定到「求职申请 + 简历保存版本」,并让这组标识贯穿请求、落库和页面展示。
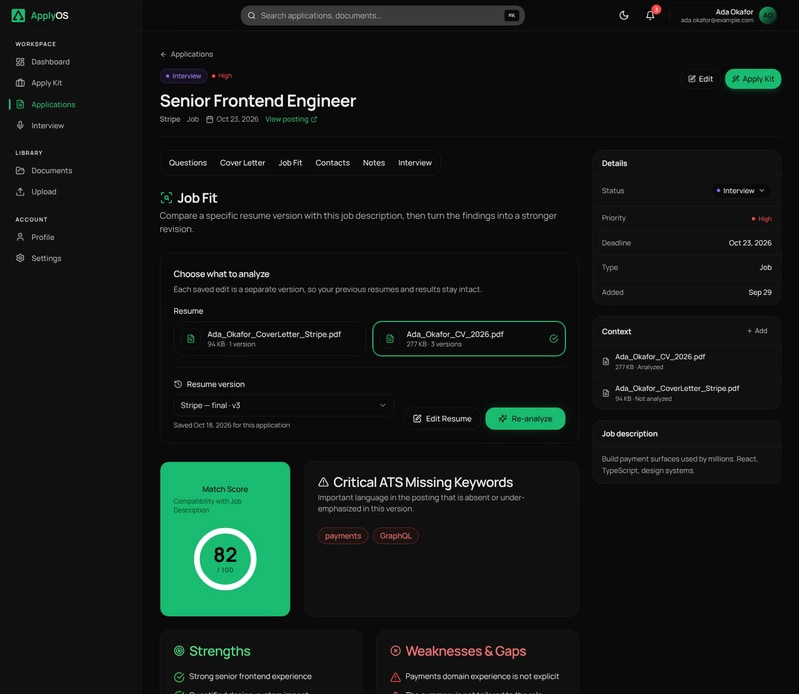
做过 AI 文档功能的前端和全栈开发者,可以从中拿走一套处理版本归属的办法。它解决的是反馈究竟对应哪份内容,截图里的演示分数仅用于展示交互。
为什么上传文件和保存版本要分开
ApplyOS 把数据拆成三种记录。文档保存上传的源文件以及解析或提取出的内容。简历版本保存某次编辑的快照。分析记录把一条求职申请和实际参与评估的简历版本关联起来。同一个文件可以改出两份内容不同的简历,同一条申请也可以分别用这两份简历做评估,因此只用文档 ID 或申请 ID 都无法定位对应的反馈。
上传时生成原始版本,后续保存编辑稿就在 resume_versions 里插入新行。数据库触发器拒绝修改已保存的编辑器内容、来源文档和版本号。星标这类元数据仍可以修改,删除文档也有自己的生命周期。这里固定的是一份版本所代表的内容。
同一文档还可能被同时保存。PostgreSQL 的插入触发器先获取该文档的事务级咨询锁(advisory lock),再计算下一个版本号。这样,同一文档的版本号会依次分配,数据库再用「文档 ID + 版本号」唯一约束兜底。把规则放在数据库里,多个上传和保存入口就可以共用同一套规则。
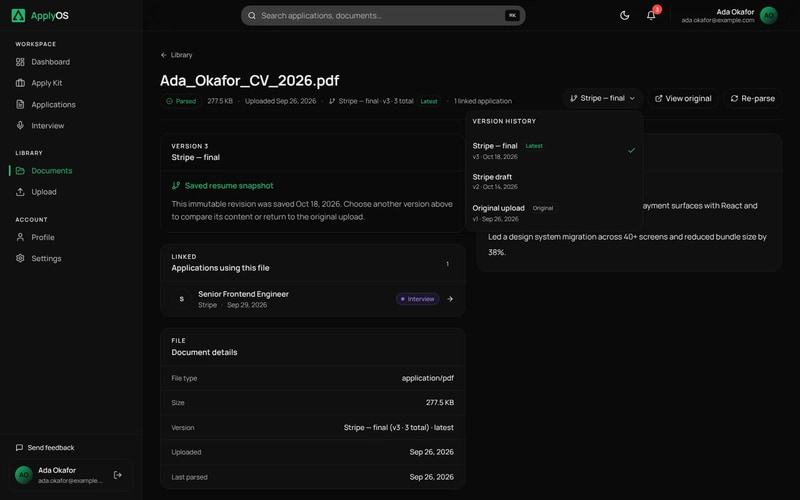
用户选了哪一版,服务端就从哪一版取正文
Job Fit 组件把申请、文档和用户当前选中的简历版本一起传给服务端。
body: JSON.stringify({
    applicationId: application.id,
    documentId: selectedDocumentId,
    resumeVersionId: selectedVersionId,
})
resumeVersionId 这一行传的是用户选中的 selectedVersionId。服务端先验证登录状态,再确认申请和文档属于当前用户,最后在指定文档下查找该版本,并校验版本的所有者。这样,即使调用方传了一个真实存在的版本 ID,版本和文档对不上,服务端也会拒绝。
给模型的文本来自该版本保存的编辑器内容。遇到旧版块结构,路由会先把内容块转换成纯文本。只有原始版本可以回退到上传文档解析或提取出的文本。编辑版如果读不出内容,接口直接报错,否则用户明明选了编辑稿,模型评估的却可能是上传稿。旧调用方省略版本 ID 时,路由明确使用原始上传版本。
结果怎么落库,切换版本时又怎么显示
分析表对 (application_id, resume_version_id) 设置唯一约束。写入待处理状态、记录模型调用失败、保存成功结果,都用这组标识。下面这段代码是原文截取的成功写入逻辑,展示同一组申请和版本再次运行时如何更新结果。
.upsert(
    {
        ...analysisIdentity,
        analysis_result: analysis,
        analysis_status: 'success',
        summary_generated_at: completedAt,
        updated_at: completedAt,
    },
    { onConflict: 'application_id,resume_version_id' },
)
决定覆盖哪一条记录的是 onConflict 那一行,所以每组申请和版本只保留一份当前结果。analysisIdentity 还包含文档 ID,数据库访问策略会检查申请和版本的归属,以及版本是否属于这个文档。模型返回成功后如果写库失败,API 会返回保存错误。
前端在单个申请的 Job Fit 页面里按版本 ID 缓存成功结果。切回旧版可以看到该版的反馈,新保存的版本也不会继承上一版的缓存。想知道改过的内容和岗位描述是否匹配,就对新版本再跑一次。
我的判断
这套做法最扎实的地方,是创建版本、读取正文、写入结果和切换界面时,都能沿着同一条数据关系追溯。只按文档 ID 缓存,代码会简单一些,但用户只要需要回看旧版反馈,同一文档下的多份结果就会共用一个缓存位置。每次分析都新增一条记录则适合需要查看历次输出的产品,ApplyOS 当前的 upsert 更适合只展示每版最新反馈的界面。
可追溯的范围目前止于简历这一侧。申请 ID 没有包含岗位描述的快照,岗位描述改了,旧反馈仍可能挂在同一个申请和简历版本下。作者提到,记录岗位描述修订,以及所用的模型和提示词,可以补齐输入出处。请求还在跑时切换版本,响应回来后界面会怎么处理,原文也把它列为待测问题。
仓库已有的单元测试覆盖文本转换,包括内容块边界、非法输入和旧版块结构。跨文档选版本、访问其他用户资源、模型调用或保存失败时保持正确归属,以及两版之间来回切换,都是作者列出的回归场景。原文没有给出这些场景的端到端结果,也没有给出模型建议的准确率或对照数据。这里可借鉴的是版本设计和工程经验。
能拿来做什么
- 给支持多稿的文档摘要或评估功能接入版本 ID。让前端提交用户选中的保存版本,由 Node 服务端校验版本归属,再从该版本读取正文。对旧调用方明确约定省略版本 ID 时读取哪份内容。
- 让结果表和页面缓存使用一致的归属关系。页面已经限定在某条申请内时,可以按版本 ID 缓存。加一条回归用例,在 A 版请求返回前切到 B 版,验证 A 版的反馈只进入 A 版的缓存。
- 把模型返回和数据库保存当成两个可分别失败的步骤。给写库失败加一条回归用例,验证模型已经返回时,接口仍能明确报告保存失败。