用 Claude 把分支对话做成单页应用
作者用 Claude 生成对话树、运行引擎、3D 场景和测试,将销售演练打包为一个静态 HTML 文件。玩家的选择会改变对话走向和买方耐心值,整个过程无需后端或实时模型调用。
AI 深度解读
《The Hard Buyer》把一通销售电话做成了一个能离线打开的 HTML 文件。Claude 写了对话树、引擎、3D 场景和测试。玩家每轮从三句回复里选一句,客户怎么答、耐心怎么变、最后能不能约到会,都由事先写好的规则决定。游玩时没有后端,也没有模型调用。
对前端和全栈开发者来说,这个案例最值得看的是发布前的检查。作者把 42 个节点、117 条回复放进同一份 JSON,再遍历实际可达的游戏状态,检查每个结局能不能走到,以及最短几轮能约到会。
销售问对了,为什么还可能一盏灯都不亮?
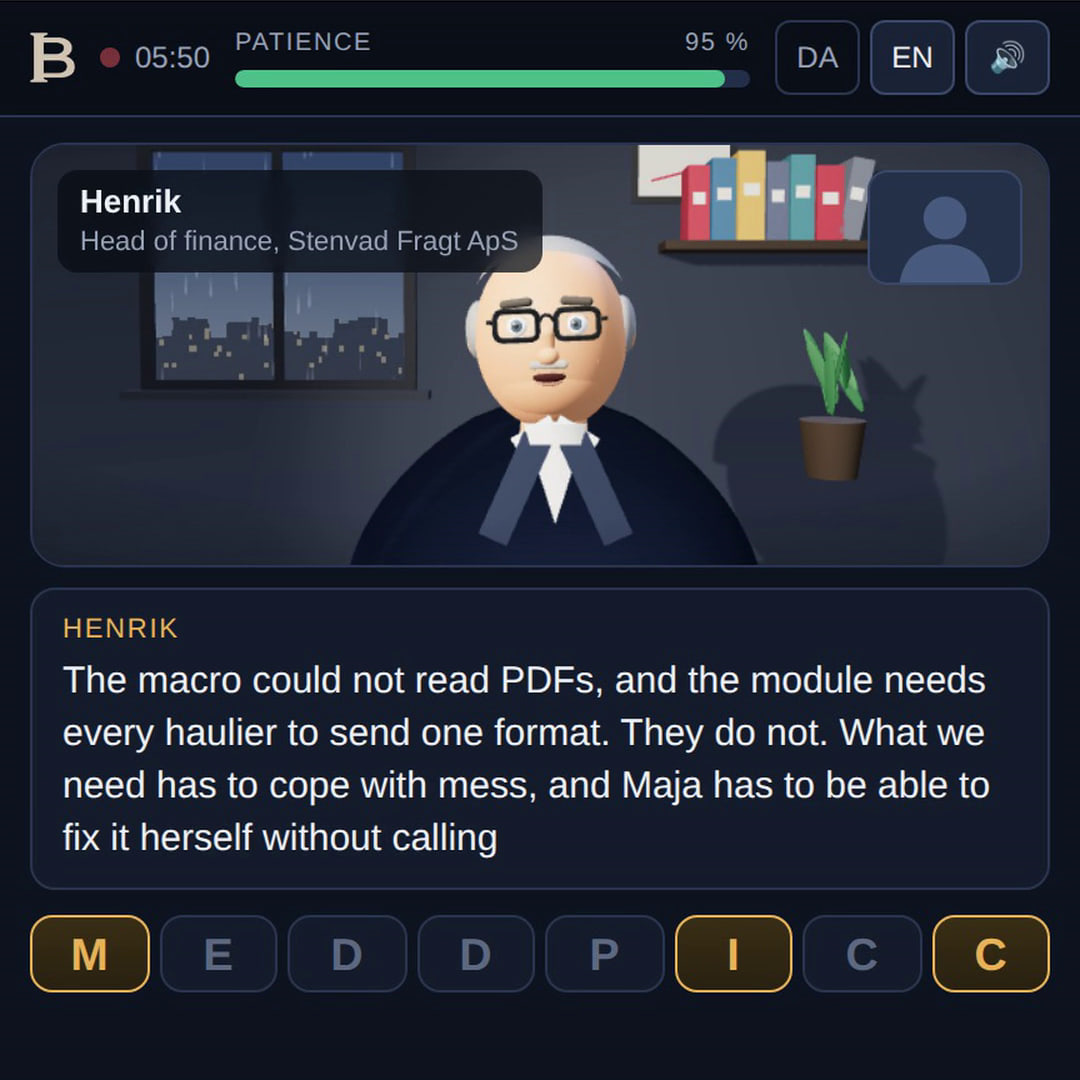
玩家约到了十分钟,谈话对象是 Henrik,一家有 45 名员工的虚构货运公司 Stenvad Fragt ApS 的财务负责人。每轮有三个选项,Henrik 的耐心会随选择变化。电话有三个结局。他可能约上合适的人继续开会,也可能让你发材料,或者直接挂断。
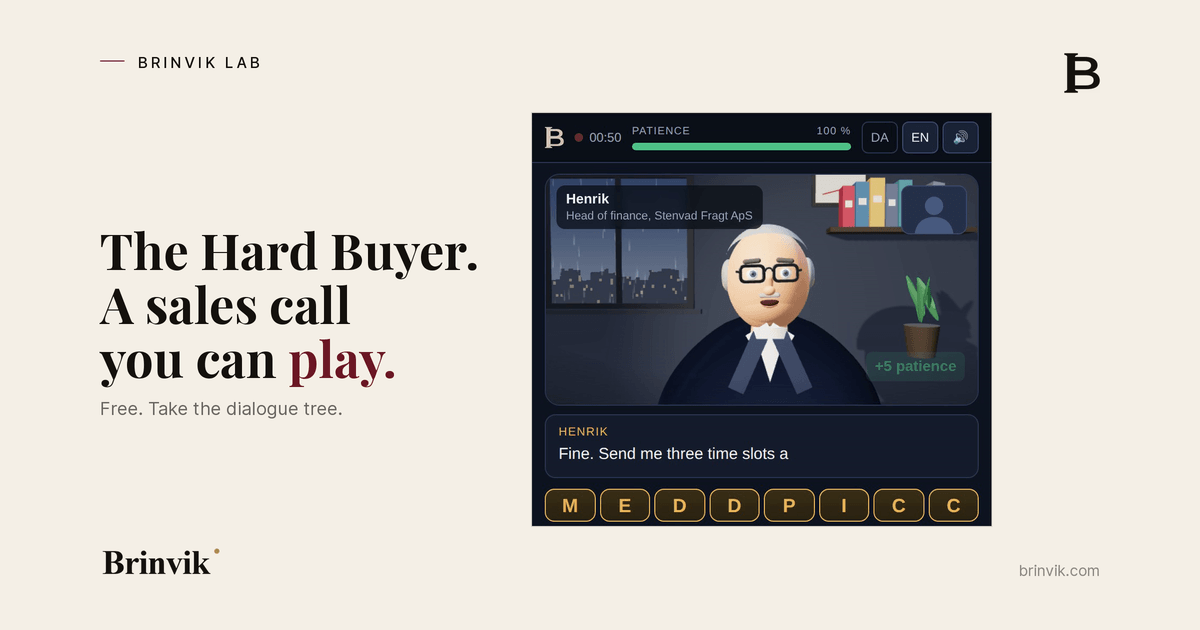
界面上的八盏灯对应销售资格评估框架 MEDDPICC,分别代表量化指标(Metrics)、经济决策人(Economic buyer)、决策标准(Decision criteria)、决策流程(Decision process)、文书流程(Paper process)、识别痛点(Identify pain)、内部支持者(Champion)和竞争(Competition)。
只有客户实际透露了信息,对应的灯才会亮。 JSON 把 reveals 放在 Henrik 的回复节点上。销售问到了预算决策人,如果 Henrik 绕开问题,E 就不会点亮。这个字段的位置直接决定了计分的含义,练习看的是玩家问出了什么。
状态也和显示分开。Dc 和 Dp 在界面上都显示成 D,Ch 和 Co 都显示成 C,所以引擎用独立的 key 记录得分。coaching 为每项信息保存一条复盘提示,coachingOrder 按 ["I", "M", "E", "Dp", "Dc", "Ch", "P", "Co"] 排列这些提示。
同一句收尾,怎么走向不同结局?
JSON 顶层用 meta 保存规则,start 指向 n01,节点表保存双语台词和选项。startPatience 是 100,maxTurns 是 12,hangupAt 是 0。选项上的 patience 表示本轮变化量。生成提示词给出的尺度是,好问题约 +5,中性回复 0,推销扣 10 到 30,无视明确拒绝扣 40。引擎把结果限制在 0 到 100,耐心归零就结束通话。
多数选项的 next 直接填节点 ID。接近收尾时,同一个选项需要根据玩家此前问出的信息和剩余耐心选择去向,这段规则就处理了这种分流。
"next": [
  { "if": { "has": ["E", "I"], "patience": 30 }, "to": "end_booked" },
  { "if": { "missing": ["E"] }, "to": "n10_who" },
  { "to": "end_material" }
]
看最后一行规则。它没有 if,前两条都没命中时就走 end_material。引擎从上往下取第一条匹配的规则,所以列表顺序也会改变结果。拿到 E 和 I 且耐心满足 30 的门槛,就能进入预约结局。还缺 E,便转到 n10_who。
每轮先显示 Henrik 的台词,并把 reveals 里的字母加到已点亮集合。玩家点击后,引擎更新耐心、解析 next,再检查耐心是否归零、是否抵达结局节点、是否达到回合上限。整个过程没有随机性。同样的选择会得到同样的通话,两个学员回看分歧时,可以直接对照各自在哪一步选了什么。
42 个节点,为什么能走出 7,799 种状态?
发布测试要求四件事都成立。每条 next 指向存在的节点,每个节点都能从 start 抵达,三个结局都能触发,并且存在十轮以内约到会的路径。只检查 ID 或在浏览器里随手点几遍,很容易漏掉一种问题。节点存在,条件却永远凑不齐。
作者用广度优先搜索遍历可能的状态。走到同一个节点时,玩家手里的信息和剩余耐心可能不同,后面能走的路也会变。搜索因此用当前节点、耐心值、已点亮字母集合区分状态。按原文的统计口径,共有 7,799 个可达状态。
最短预约路径是十轮,开场偏偏选了作者认为最糟的一句,声称能用 AI 自动化帮客户节省 40% 的时间。Henrik 回了一句「大家都这么说」,耐心扣 25,后续选择仍然能把局面拉回来。点亮八个字母需要十一轮,每次都选第一条则会在四轮内结束。这些是作者跑出来的路径结果,反映的是这份对话树的规则。
一份 HTML 怎么换成另一位买家?
作者把 JSON 内联到 HTML 的 treescript 数据元素里,页面加载时解析。游玩期间没有网络请求、数据存储或模型调用,Henrik 的台词都来自对话树。作者提供了可离线打开的 ZIP、独立的对话 JSON,以及交给 Claude 生成新买家的提示词。
提示词要求输入买家、产品,以及 MEDDPICC 每项对应的一条事实,生成至少 40 个节点,每个节点提供三个回复,约十轮能约到会,并沿用耐心计分和 reveals 规则。Claude 交付前也要做同样的四项自检。拿到新树后,替换 treescript 的内容,按原文提醒处理 <\/ 转义,就可以直接打开文件,无需构建。原文关于内联转义的段落有缺损,具体处理代码没有完整给出。对话树也可以打印出来,和同事照着做角色扮演。
我的判断
我认同作者把模型写内容和程序验证规则分成两步。生成时可以让 Claude 一次写出几十个节点,交付时用遍历检查路径。模型自检「能抓住大多数坏引用」是作者的经验之谈,原文没有给对照数据。相比手动试玩,遍历适合回答「有没有一条路能走到这里」。试玩更适合回答「这句像不像客户会说的话」。原文报告了前一种检查的结果,没有给出培训效果的对照。
回合数也值得单独看。文章列出的去重字段是节点、耐心和字母集合,回合数没有列在其中。对这四项发布检查,如果每走一步消耗一轮,广度优先搜索会先到达同一状态的最短路径。若以后加上「只在第八轮解锁」之类的规则,回合数就会改变分支,需要作为状态的一部分参与验证。
固定对话树适合练提问内容和顺序,也方便学员重走同一条路径。开放式模型陪练允许学员自己组织措辞,但比较两次练习时,还要考虑模型回复的变化。作者也明确说了,这个版本无法训练语气、沉默和时机。十轮约到会是一条可复现的游戏路径,原文没有报告学员在真实销售电话里的表现。
能拿来做什么
- 给前端分支练习定义数据结构时,把用户选项、状态变化和系统实际反馈分别建模。需要按反馈计分时,把得分条件跟着反馈存,避免玩家只凭选中某句话就拿到分。
- 用 Node 在发布前遍历对话树,检查目标节点、可达节点和结局,并输出到达目标结局的最短路径。改过台词跳转或计分门槛后,可以直接重放这条路径。
- 让 AI 生成分支内容时,把允许的节点结构、选项数、计分尺度和通过条件写进提示词,再用项目里的验证程序检查交付结果。修改关卡规则时,把示例和验证条件一起更新。