医疗 Agent 如何让回答有据可查
团队用药品官方说明书检索与药物相互作用知识图谱构建医疗 Agent,让回答能够追溯到指定来源。文章还讨论构建中的失败点,并明确三天原型不能证明系统已具备充分可靠性。
AI 深度解读
医生问两种药是否相互作用,真正需要的还有一句:依据在哪。CorLab 的 CTO Mihai Dascal 用三天搭了一个医疗 AI Agent,把回答限制在官方药品说明书和药物相互作用图谱之内。它展示了一条可行的工程路线,但没有证明系统已经能用于临床。
这篇案例值得程序员看的,是模型与数据之间的边界怎么设计:什么问题查文档,什么问题查关系,查不到时怎么回答,以及三天跑通的 Demo 离可靠产品还差哪些验证。
为什么药品说明书和相互作用要分开存
作者第一天先处理数据模型,选用 LangChain 和 LangGraph 编排 Agent,Qdrant 存向量,Neo4j 存知识图谱,两套数据库都部署在 Azure 虚拟机上。
这套拆分对应两种不同的知识形态。
药品说明书里的副作用、用药注意事项,通常藏在段落中。医生的提问用词又未必和原文一致,适合用检索增强生成(RAG):先按语义检索相关文本,再让模型根据文本组织答案。作者从国家药品监管机构网站抓取官方说明书,解析后生成嵌入向量,存入 Qdrant。
药物相互作用则是一种关系。作者把早期医学研究中积累的 Excel 数据导入 Neo4j,让两种药之间的相互作用成为图中的关系。查询时,系统查的是这条关系是否存在,以及对应记录是什么。
这比把所有材料切块后塞进同一个向量库更贴合问题结构。向量检索负责找到相关段落,图查询负责找到明确关系,答案来自哪里也更容易追踪。
但有一道边界必须讲清楚:图谱没有相互作用记录,只能说明当前数据没有记录,不能据此认定两种药没有相互作用。
说明书检索也一样。没有找到相关段落,可能是资料没有覆盖,也可能是解析或检索失败。允许系统返回空结果,是可靠回答的起点;如何解释这个空结果,同样需要设计。
路由错了,正确资料也会回答错问题
作者只向 Agent 暴露了两个 LangChain 工具:process_medication_query 检索说明书,process_interaction_query 查询相互作用图谱。两个工具都接收完整问题,让医生可以沿用自然语言表达。
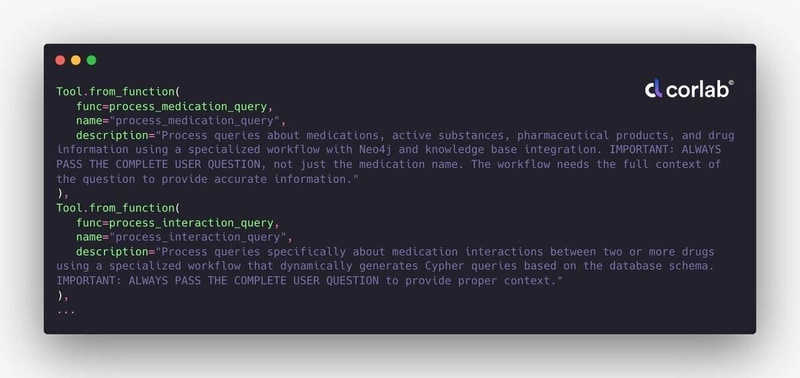
工具描述在这里承担了路由规则的作用。涉及两种或更多药物的相互作用问题,应进入图谱;副作用之类的问题,应进入说明书检索。定义中还特别强调传入完整问题,避免 Agent 只抽出药名,把真正的询问意图丢掉。
不过,「出现两个药名」只能算线索,不能成为充分条件。例如,分别询问两种药的副作用,未必是在问相互作用。原文没有展示这类混合问题的测试结果。
作者在接入医疗数据前,先用 Bitcoin 价格等金融问题测试工具切换,通过 Swagger API 验证调用逻辑。当时连界面都还没有。这种顺序很实用:先确认请求能到达正确工具,再排查检索和回答。
第二天,说明书的向量检索进展顺利,图查询却卡住了。最初让模型自由生成 Cypher,数据库结构或命名稍有变化,查询就容易出错。调试两小时后,作者改用 GraphCypherQAChain,让查询生成依照图数据库的实际结构进行。
原文补充了 2026 年的使用细节:该组件位于 langchain-neo4j 包中,需要设置 allow_dangerous_requests 才能运行。这个开关并不提供安全保证。模型生成的查询可能有破坏性,因此数据库账号应只授予必要权限,这个医疗图谱场景应使用只读账号。
工具描述决定模型往哪里走,数据库权限决定它最多能做什么。
前者需要测试,后者需要系统强制执行,不能只靠提示词约束。
三天跑通了链路,还没有验证医疗可靠性
第三天,作者采用一个 MIT 许可的开源 Next.js 和 React 项目作为界面。项目已经支持 WebSockets,他再生成 Python 后端连接 Agent,并手动调试认证和消息广播。
Supabase 负责认证、聊天记录、反馈收集和管理功能。代码提交到 GitHub,部署到 Azure VM,前面配置 NGINX,通过 Certbot 提供 SSL。
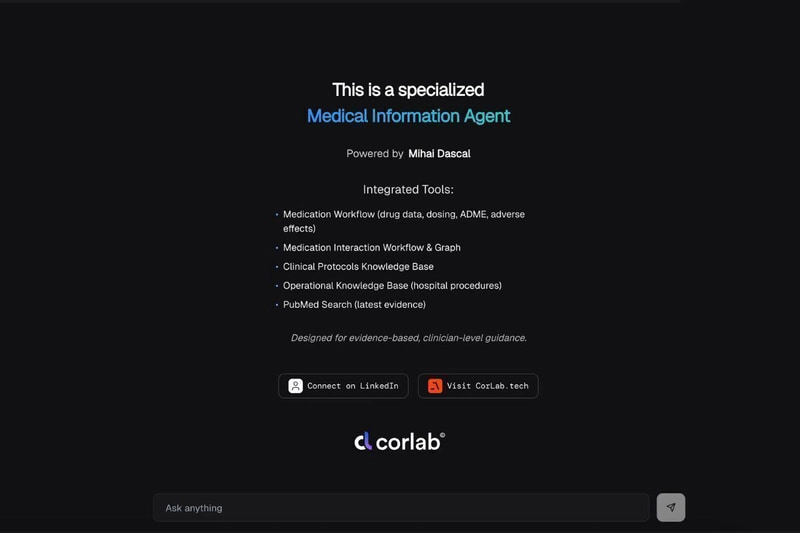
作者还加入了临床指南和操作规程,系统能解析并立即回答相关问题。这里证明的是新增文档可以进入处理链路,原文没有提供这些回答的准确率。界面上虽然还列出了 PubMed 等工具,也不能据此认定每个入口都已完成同等验证。
原文引用的研究数据,需要分开理解。2025 年《Journal of the American Medical Informatics Association》一项纳入 20 项研究的元分析发现,RAG 在生物医学任务上的合并优势比为 1.35。优势比不是准确率,不能直接读成准确率提高了 35%,更不能套用到这个原型上。
同一综述还引用了一项初步研究:GPT-4 Turbo 提取表格数据的准确率只有 16%。药品说明书包含剂量表,这提醒开发者,回答附带来源,也不代表来源已经被正确解析和使用。
目前,原型只经过作者本人检查,没有由临床医生用标准答案集评测。原文建议先由医生编写真实问题,加入资料无法回答的问题,再分别评价答案准确性、引用是否正确,以及该拒答时有没有拒答。数据或模型更新后,都要重跑评测。
数据维护也未完成:说明书只抓取过一次,相互作用来自研究用表格。生产环境还需要明确授权、版本记录和更新机制。单台虚拟机适合原型,正式运行则需要冗余、数据库与应用分开部署、预发布环境,以及数据库或模型 API 故障告警。
我的判断
我赞同这个案例把工程重点放在数据、工具和权限上。把相互作用建成关系,再用说明书补充文本证据,比要求模型凭训练记忆回答,更容易检查错误发生在哪一层。
不过,原文把 Agent 描述成「只根据工具返回内容回答」,这应当理解为系统设计目标。仅仅接上工具,并不能证明模型不会补充未经检索支持的内容。引用能否支持具体结论,仍然要单独检查。
相比全部使用向量检索,图谱让明确关系的查询更直接;代价是要维护药物命名、关系结构和数据版本。相比固定规则路由,模型更容易接收自然语言,但也引入了误判。原文没有给出这些方案的对照结果,因此路线优劣仍有经验判断的成分。
医疗上线门槛也不能从界面完成度推断。原文提到,若系统替受 HIPAA 约束的实体处理受保护健康信息,就涉及相应要求;FDA 于 2026 年 1 月 29 日重新发布的 Clinical Decision Support Software 指南,也包含让临床医生能够独立审查建议依据的条件。这些内容不能直接当作国内部署的合规结论。
对前端更直接的启发,是把依据放在答案旁边,并标出缺少依据的回答。WHO 提醒的自动化偏差,指人们可能因为答案来自软件,就漏掉原本能够发现的错误。出处只有方便查看、确实支撑结论,才有实际价值。
能拿来做什么
- 开发文档问答或内部知识助手时,先按问题类型确定数据来源。段落信息可以语义检索,明确关系可以结构化查询,同时定义「没有查到」时允许给出的结论。
- 为 AI 编程中的工具调用保存一组路由用例,覆盖单一意图、混合意图和资料缺失。记录问题实际调用了哪个工具,便于区分路由错误与检索错误。
- 在 Next.js 或 React 聊天界面里,让答案与对应依据一起呈现。可以明确区分找到记录、未找到记录和工具调用失败,避免都显示成一句笼统的回答。
- 把数据更新和模型替换纳入回归评测。工具接口可以降低更换模型的成本,但新模型是否仍会正确选工具、引用和拒答,需要重新验证。