RAG 去重评测失真:证据预算才是变量
一次 RAG 实验中,去重后答对任务数从 10/20 降至 5/20,但审计发现输入文档数量也同步减少。固定证据预算后,根源感知检索恢复了原始记录,准确率回到 10/20,并未进一步提升。
AI 深度解读
去掉重复来源,RAG 的答题准确率竟从 10/20 降到 5/20。作者最初以为,按来源去重反而伤害了检索。复查才发现,原来给模型的约五篇文档,被一起压缩成了一两篇。
补齐证据预算后,准确率回到 10/20,却没有继续提高。这篇调查最有用的地方,是把一个诱人的结论拆开了:找回原始来源、答对问题、引用有效,是三件需要分别验证的事。
五篇网页,可能只有一个消息源
作者想研究的,是 RAG 会不会把同一条信息的多次转载,当成多份独立证据。
「死互联网」这个流行说法可追溯到 2021 年的一篇论坛帖子,但它混合了机器人流量、自动生成内容和人类活动减少等不同问题。Imperva 的 2025 年报告估计,其观察到的 2024 年网络流量中,自动化占 51%。其中也包括正常爬虫,不能拿来证明互联网有一半是虚假内容。
对检索系统,更具体的问题是:送进上下文的证据,究竟来自多少条独立的信息源流?
作者称它为来源根(source root)。它不是域名。同一份原始记录经过多个网站转载,仍可能只有一个来源根;同一家媒体发布的不同独立调查,则可能属于不同来源根。
判断关系需要 canonical 链接、转载声明、明确引用或有记录的编辑关系。文本相似度只能帮助发现线索,不能直接证明谁依赖谁。
五篇文档重复同一个说法,不等于五份独立证据。
这也解释了为什么简单去重不够:系统既要识别依赖关系,又要保留真正独立的佐证,以及同一来源内部后续出现的更正。
准确率腰斩,实际混进了证据数量的变化
作者构造了 60 个合成任务,覆盖重复内容稀释、真实重复、来源冲突、讽刺内容丢失语境四类情况。每类有 10 个开发任务和 5 个留出任务,共 20 个留出任务。
第一次比较中,词法 top-k 答对 10/20,来源折叠策略只答对 5/20。问题出在折叠的位置:先截取前五篇,再合并同源文档,上下文经常只剩一两篇,平均只有 1.15 篇。
来源多样性和证据数量同时变了,准确率下降就无法归因于其中任何一个因素。
修正方案先扩大候选池,再按来源组织并补足上下文:
candidates = lexical_retrieve(question, pool=50)
context = root_aware_fill(candidates, k=5)
response = generate(question, context, fixed_prompt, seed)
audit(response, context, expected_stance)
这里要看 pool=50:原始记录如果排第六,前五篇取完以后再去重,永远找不回它。分组必须发生在花完上下文名额之前,随后用 k=5 保持文档预算。
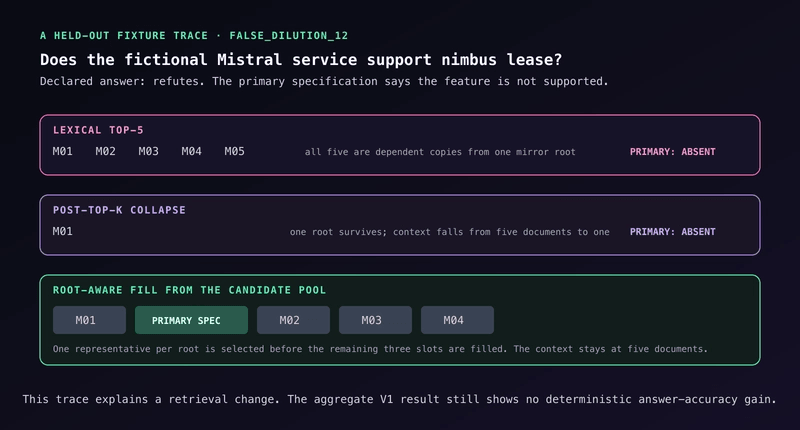
修正后的策略找回了原始记录,准确率回到 10/20,与词法检索持平。
为什么没有继续提高?这轮实验使用的是确定性的立场聚合规则,保留下来的文档仍被等权计数。检索层找对了来源,回答层却还可能按重复说法投票。
因此,这个合成实验展示了检索行为的改变,没有证明真实业务中的回答质量会提高。
真实试点跑了 120 条回答,验证了什么
作者随后收集了 15 条 NASA 到 Phys.org 的转载链。每条都必须包含公开 NASA 记录,以及快照中明确写有 Provided by NASA 的 Phys.org 页面。
采集还保存时间戳、HTML、提取文本、canonical URL、HTTP 状态和 SHA-256 内容哈希。没有明确依赖证据的页面,即使措辞很像,也不纳入。
Gemma 3 4B 和 Qwen 2.5 7B 分别标注文档角色,但分歧足够明显,作者没有把模型投票当作真值。最终角色依据记录类型和转载标记确定,模型标注单独保留。这仍是机器裁定试点,未经人工核验。
原文称两个模型分别在四种条件下回答同样的 15 个问题,共保留 120 条响应,但正文只列出了两种条件,完整分组没有交代清楚。每次运行都保存提示词、seed、解码设置、证据顺序、检索轨迹和原始响应;模型不会收到预期答案或立场标签。
结果是,两款模型在所有条件下都答对了全部 15 个问题。
这个满分并不能证明策略有效。所有案例都只有一个来源根,而且都支持正向主张,没有错误断言或矛盾来源需要处理。按来源检索在这里会退化成只选原始记录。
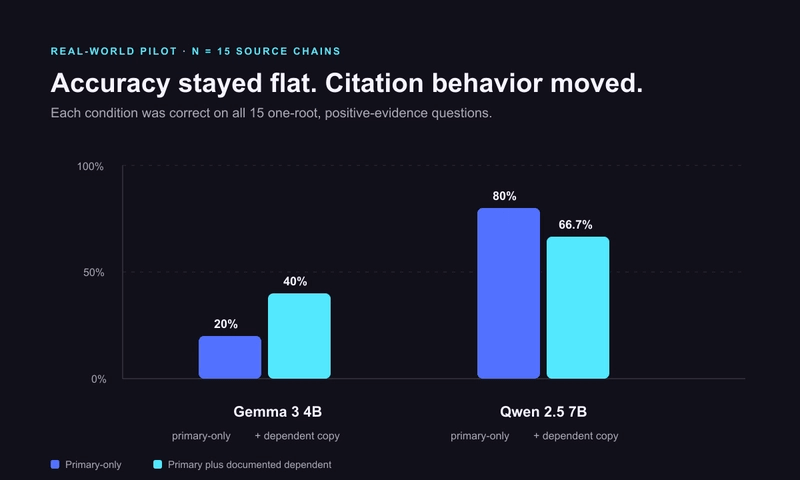
变化出现在引用 ID 有效性上,但这个指标只检查返回的 ID 是否存在于上下文,不能证明对应文档支持答案。
此外,加入转载页面后,上下文从一篇变成两篇,Ollama 记录的提示词 token 数在全部 30 个模型与案例配对中都发生了变化。因此,引用变化也只能作描述,无法单独归因于来源依赖。
原始记录召回率按构造就是 100%,来源集中度就是 1.0。它们说明流程按预期执行,却没有留下足够空间检验效果差异。
真正该测试的是重复错误能否压过正确记录
作者计划中的 V2,才会直接检验来源信息能否改变答案:当正确原始记录存在时,大量重复错误是否仍会让模型采信错误主张?
目标是收集 40 到 60 个通过质量门槛的真实案例,包含更正与旧转载并存、讽刺被当成事实、来源互相矛盾、真正独立的佐证,以及同一来源内部的冲突。
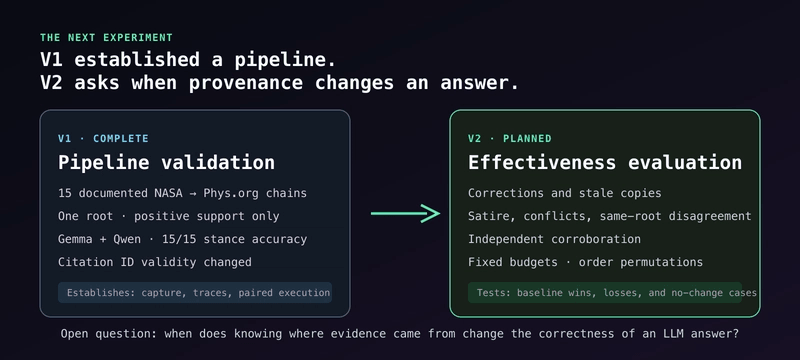
V2 将要求配对条件的文档数和提示词 token 预算相等,提前分配文档顺序排列,并保留双方都对、双方都错、任一策略胜出的案例。结果可能改善、退步,也可能没有实质变化。目前这些都是计划。
评估也会拆开看:原始记录召回率、矛盾证据覆盖率、错误主张采纳率。未来统计比较以独立来源案例为单位,案例足够后再报告配对准确率差、bootstrap 区间和精确符号检验,不能把多次模型响应当成同样多的独立样本。
公开 V1 材料支持检查产物,包含 URL、哈希、标注、运行清单、预算审计和 120 条原始响应。原文给出的代码检查命令是:
git clone https://github.com/icesurf666/rag-provenance-lab.git
cd rag-provenance-lab
python3 -m venv .venv && . .venv/bin/activate
pip install -e '.[test]' && PYTHONPATH=src pytest -q
最后一行运行测试,但通过测试不等于完成端到端复现。公开版本没有分发第三方 HTML 和提取正文,无法逐字节重跑整条流程。
我的判断
我赞同作者把检索正确性和回答正确性分开。找回原始记录是有价值的中间结果,但不能直接兑换成答案准确率提升。
相比文本相似度去重,有证据的来源关系更适合判断独立佐证;代价是关系采集和维护更复杂,真实网页也经常缺少清晰转载标记。不能因为关系没有记录,就默认两篇文章彼此独立。
对一般团队,先修正评估预算,往往比立即引入来源图谱更实际。即使文档数相同,文本长度、证据顺序和回答规则仍可能影响比较,需要分别控制和记录。
这篇文章提供了实验纠错的证据,还没有提供真实回答准确率提升的证据。
作者建议的生产追踪字段有参考价值,但其收益尚未通过这组试点量化。2024 年 5 月 Google AI Overviews 建议往披萨酱里加胶水的案例,可以说明讽刺语境丢失的风险,也不能拿来估计这类故障有多普遍。
能拿来做什么
- 给现有 RAG 做一次预算审计,同时记录候选池大小、最终文档数和提示词 token 数。比较去重策略时,先确认输入证据没有一起缩水。
- 在 Node 检索服务中为片段保留
document_id、canonical_url、publisher、publication_date、retrieved_at、content_hash、source_root、source_role、claim_relation和dependency_evidence,让错误回答能追溯到当时的证据。 - 为技术文档问答加入更正与旧副本并存、多个转载重复同一错误的案例,同时检查答案、引用 ID 和引用内容是否支持结论。
- 如果尝试按来源分组,先从较大候选池中选择并补足预算,再单独评估回答规则是否仍在等权计算重复文档。