让编程 Agent 同时用好关键词与语义检索
文章解释了自然语言需求与代码命名不一致时,关键词检索可能导致 Agent 多轮尝试。建议提供代码中的实际术语,或结合嵌入索引补充语义搜索,同时警惕语义相近却不相关的结果。
AI 深度解读
Coding Agent 找不到代码,有时不是模型能力不够,而是你说「退款」,仓库里却叫 reverse_charge。原文用 400 条 Django 真实提交做回放,发现请求是否点出代码名称,会明显影响 grep 定位文件的成功率。
作者给出的办法很务实:先在请求里提供准确名称,再给仓库补一份术语映射,最后按实际搜索成本决定是否引入语义索引。值得读的地方是它提供了可测量的改进路径;需要打问号的地方,则是实验离真实 Agent 工作流还有多远。
找不到文件,可能只是业务叫法没对上
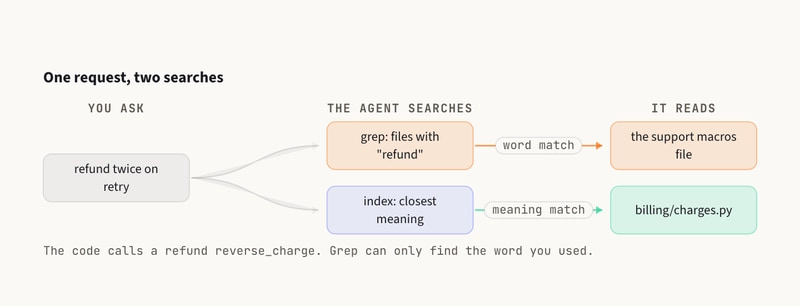
grep 擅长回答「哪些文件包含这个字符串」,无法直接回答「哪些文件在处理这件事」。开发者说「客户重试时退款两次」,模型就得猜仓库用了 refund、payment,还是 reverse_charge。
每猜一次,都要搜索并读取结果。作者把这个过程称为一轮搜索(search round)。更麻烦的情况是,Agent 找到一个看起来相关的文件就开始修改,定位错误被带进后续实现。
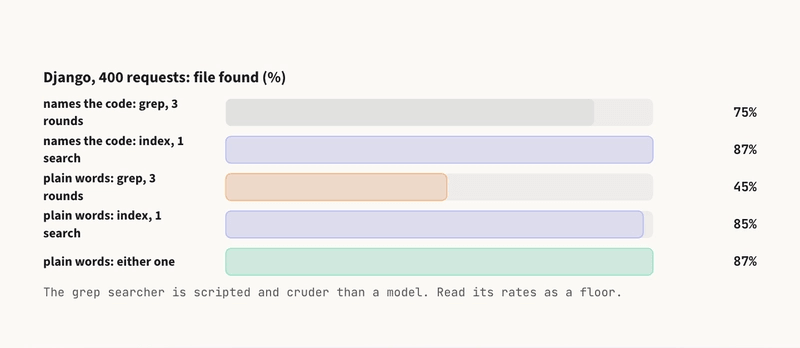
作者将 400 条 Django 真实提交回放给一个脚本化 grep 搜索器。在三轮以内,请求点出代码名称时,找到目标文件的比例为 75%;使用普通自然语言描述时,只有 45%。
例如,select_for_update() 能直接缩小搜索范围,而「时区目录缺失时修复时区验证」中的 validation、directory 会命中许多文件。对于后一类请求,搜索成功时平均需要 2.4 轮;即使允许六轮,仍有 45% 没找到。
仓库规模也会放大歧义。移除 Django 四分之三的文件后,普通语言请求的三轮命中率达到 59%;保留全部 873 个文件时,降到 45%。文件越多,常见词对应的候选就越多。
准确的函数名、错误文本和业务术语映射,都是能直接降低搜索难度的上下文。
语义索引补上了什么,又漏掉了什么
嵌入(embedding)可以理解为文本的数值表示,内容含义相近,表示也更接近。代码嵌入索引会将文件切成片段,保存每段的向量,再检索与请求含义接近的片段。因此,请求与代码不必使用同一个词。
作者在相同的 400 条请求上,使用通用小模型 all-MiniLM-L6-v2,取前 10 个文件。对于点名代码和普通语言两类请求,命中率分别为 87% 和 85%;结合 grep 后,分别达到 94% 和 87%。
结果支持两种搜索互补,但提升并不均匀:普通语言请求从语义索引单独使用的 85% 提升到 87%,增幅小于点名代码那组。原文还引用 Cursor 自有测试,称语义搜索让 Agent 正确回答的问题增加 12.5%,但没有在正文交代完整评估条件,不能直接与上述文件命中率比较。
如果自己合并结果,作者建议使用排名融合(rank fusion):按文件在各列表中的位置计分。向量距离和关键词出现次数不是同一种量,直接比较容易失真。
下面这段代码将两份结果合成 Agent 最终打开的文件列表:
from collections import defaultdict

def merge_results(grep_files, index_files, k=60):
    points = defaultdict(float)
    for files in (grep_files, index_files):
        for position, path in enumerate(files, start=1):
            points[path] += 1 / (k + position)
    return sorted(points, key=points.get, reverse=True)[:10]   # Agent 将打开的文件
关键是 1 / (k + position):默认 k=60 用于减弱榜首位置的支配作用,最后的 [:10] 则控制阅读量。不过,grep 文件列表怎样排序,原文没有说明;这个前提会影响融合效果。
先记录搜索成本,再决定是否装工具
作者建议先统计「首次编辑前的搜索调用数」。Claude Code 的会话保存在 ~/.claude/projects/<project>/ 下的 JSON-lines 文件中,工具调用位于 assistant 消息的 tool_use 块。
原文提供的 searches_before_first_edit 会累计 Grep、Glob,以及以 grep、rg 、find 、git grep 开头的 shell 命令,遇到 Edit、Write、MultiEdit 就停止。作者建议检查一周会话,并优先回看搜索超过五次的任务。
接着补术语表。按原文所述,Claude Code 在会话开始读取 CLAUDE.md,Codex 和 Cursor 读取 AGENTS.md。示例包括:将 refund 映射到 billing/charges.py 的 reverse_charge,将 seat、license 映射到 accounts/entitlements.py 的 Entitlement,将「夜间任务」映射到 jobs/reconcile.py 的 reconcile_ledger。
只记录实际搜漏的叫法。启动上下文有阅读成本,已经能直接命中的名称没必要重复堆进去。
搜索成本仍高,再考虑语义工具。原文称 Cursor 已内置索引;Claude Code 可以通过 Zilliz 开源的 claude-context 获得结合关键词与向量检索的 search_code 工具,安装命令如下:
claude mcp add claude-context \
  -e OPENAI_API_KEY=sk-... -e MILVUS_TOKEN=... \
  -- npx @zilliz/claude-context-mcp@latest
注意 OPENAI_API_KEY 和 MILVUS_TOKEN 对应的外部服务。按原文描述,这套方案会把代码片段发送给 OpenAI 生成嵌入,并在 Zilliz Cloud 保存向量;Cursor 也在服务器端计算嵌入。能否采用,取决于团队允许的代码处理方式。
索引还需要跟上文件变化。原文称 Cursor 使用哈希树同步变更,自建工具则要自行安排重新索引。对于函数名、堆栈和错误字符串明确的请求,直接搜索当前代码仍然合适。
我的判断
我认同作者的实施顺序:先改善命名上下文,再增加检索基础设施。术语表容易维护,也容易通过慢会话反查效果,适合业务叫法与历史代码名称长期不一致的团队。
但这些数据证明的是特定实验中的文件定位表现。脚本化 grep 搜索器不等于 Claude Code、Codex 或 Gemini CLI 的完整策略,找到文件也不等于修复正确。原文未充分说明请求构造、目标文件判定及搜索器策略,不能据此断言语义索引会让真实任务成功率提升同样幅度。
「四轮搜索就是四倍阅读成本」也应谨慎理解。原文没有计费实测,不同工具的上下文管理和缓存会影响实际开销。搜索轮次值得观察,但不能直接当作账单倍数。
同样,50 个文件几乎不必折腾、少于几百个文件收益有限、超过五次搜索就是漏搜,这些更适合作为作者的经验起点。复杂任务可能需要合理探索;过早编辑也可能源于定位草率。
评价检索改进时,应同时看搜索成本和最终修改是否正确。
能拿来做什么
- 提交 AI 编程任务时,附上已知函数名、报错原文或相关路径。例如已确认退款逻辑叫
reverse_charge,就把它写进请求,同时说明触发条件。 - 从近期定位缓慢的任务中整理少量术语映射,放进 Agent 实际读取的说明文件,覆盖历史名称、缩写和业务别称。
- 比较加入术语表前后,首次编辑前搜索次数的中位数,并检查修改是否落在正确位置。原文还建议用
code_example.py,将REPO设为本地仓库,回放历史提交;输入没有提供该文件,不能把它视为现成可运行的完整实验。 - 对持续存在定位困难的大仓库,再评估混合搜索,同时确认代码外发规则与索引更新方式。请求已经给出明确符号时,继续使用 grep 即可。