19项任务对测:模型失败未必报错
在同端点、同参数的19项任务单次测试中,GLM-5通过19项,Gemini 3.8 Flash通过17项,后者两次失败均返回HTTP 200且未触发错误。测试还记录了耗时、Token和成本,但样本不足以代表模型整体能力。
AI 深度解读
GLM-5 和 Gemini 3.8 Flash 做同样的 19 道任务,成绩是 19/19 和 17/19。但更有用的发现藏在失败记录里:Gemini 的两次失败都返回了 HTTP 200,一次没有最终答案,一次答案正确却违反输出格式。只盯接口报错率,这两次都会漏掉。
这组测试适合拿来检查自己的 AI 调用链:什么时候算完成、输出能不能交给程序、成本应该怎么算。至于谁的编程能力更强,19 道题、每题只跑一次,还撑不起这个结论。
HTTP 200 为什么不能算任务成功
作者把任务分成六类:修复代码、从零实现、调用工具、回答仓库问题、遵守输出格式,以及从长文件中查找数值。两个模型使用相同端点和请求参数,每个模型每题运行一次,共记录 38 次调用。
两次失败都出现在需要读取数百行文件的任务里,但失败原因不同。
第一题要求从 402 行日志中找到一个 Deploy 密钥,最多允许六个 Turn,也就是模型推进任务的交互轮次。GLM-5 在第四轮找到答案并正常结束;Gemini 3.8 Flash 用完六轮时还在调用工具,记录中的 stop_reason 是 tool_calls,最终文本为空。
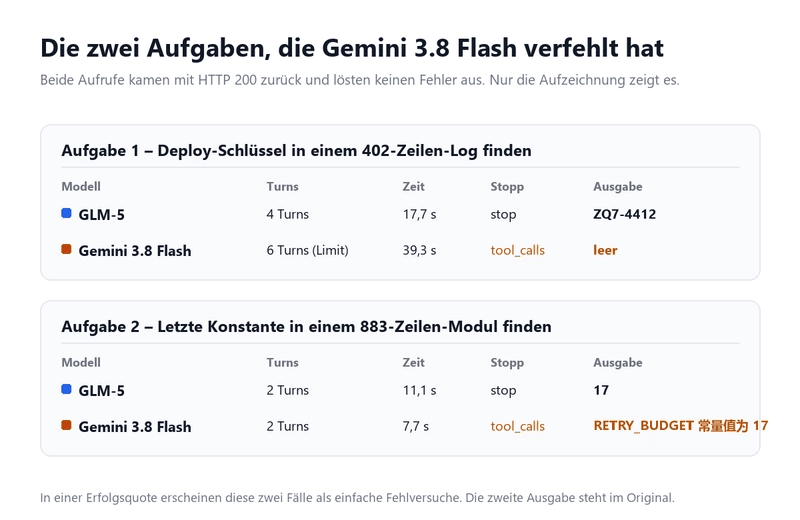
这条记录证明的是「预算耗尽时任务尚未完成」,不能直接证明模型找不到密钥。继续执行有没有机会成功,原文没有补测。
HTTP 200 只能说明请求在接口层成功,不能替业务宣布任务完成。
对调用端来说,空文本也不该被直接当作正常答案返回。需要结合停止原因和工具执行状态,判断应该继续运行、重试,还是向上层报告未完成。原文强调 stop_reason 的价值,但具体状态如何解释,仍要服从接入接口的定义。
数字答对了,为什么仍然要判失败
第二题要求从一个 883 行的模块里找到常量值,而且只能输出数字。
两个模型都用了两轮。GLM-5 返回 17,Gemini 3.8 Flash 返回 RETRY_BUDGET 常量值为 17。
人能看懂,程序未必能接受。如果下游要求严格的整数文本,后者就违反了约定。这里也要区分解析方式:有的解析器会直接拒绝,有的宽松处理可能放过异常输入。生产代码应该主动规定允许什么,而不是依赖解析器碰巧如何处理。
输出格式一旦参与程序执行,就是接口契约的一部分。
作者建议先验证形式,再判断内容。比如任务要求纯数字,就先检查整个返回值是否符合约束,再验证数值是否正确。否则人工验收很容易因为「意思对了」而放行,自动流程却会在下一步出问题。
不过,这道题使用中文指令,模型也用中文补充了解释。原文没有测试同一任务换成英文或德文后是否仍然失败。对国内团队最直接的启发是:用实际生产中的中文提示词测试,别拿另一种语言的成绩代替。
此外,失败恰好集中在两道长文件题,只能提示后续该重点检查哪里,无法据此认定长文件读取导致了格式违规。
便宜 23.1%,为什么归一化后只差 0.4%
按这次实际使用量计算,Gemini 3.8 Flash 的总费用低了 23.1%。但两个模型消耗的输入量不同,把使用量归一化后,费用变成 $0.0694 和 $0.0697,原文给出的差距仅为 0.4%。
前者回答「这批任务实际花了多少」,后者回答「同样使用量按不同单价怎么计费」。选型时两种口径都要看,因为模型推进任务的方式也会改变账单。
以下是原文列出的价格,时间口径为 2026 年 10 月 22 日,单位均为每百万 Token:
| 计费项目 | GLM-5 | Gemini 3.8 Flash |
|---|---|---|
| 输入 | $1.00 | $0.75 |
| 输出 | $3.20 | $3.75 |
| 缓存输入 | $0.20 | $0.075 |
| Batch 输入 | 无 Batch 档位 | $0.375 |
| Batch 输出 | 无 Batch 档位 | $1.88 |
Gemini 的缓存输入约便宜 2.7 倍。如果请求反复携带长前缀,而且这些内容确实能命中缓存,成本结构就可能明显改变。Batch 价格则适用于可以等待的异步任务,不能直接套到要求即时响应的交互里。
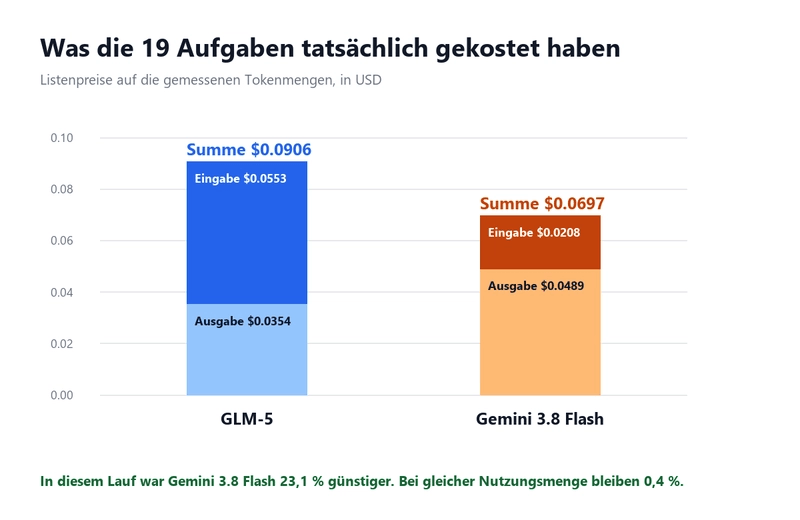
原文的实测账单没有计入缓存或 Batch 折扣。它提供了价格比较的入口,没有证明这些优惠在这批任务上能兑现多少。
轮次也不能直接代替 Token 成本。GLM-5 共用了 55 轮,Gemini 用了 63 轮;前者输入总量却接近后者两倍,每轮约为 1,005 和 440 Token。少跑几轮,不一定少花钱。
推理 Token(Reasoning Token)按输出价格计费,这次分别记录了 6,444 和 9,105 Token,相差 41%。Gemini 的输出单价更高,这部分会影响账单,但一次测试不能证明它长期都会多消耗这么多推理 Token。
我的判断
我认同作者把失败拆开检查的思路。对于接入 AI 的前端和 Node 服务,「请求成功」「模型完成」「输出合规」「内容正确」应该分别记录。一个总成功率很难告诉你该改提示词、加执行预算,还是换模型。
但原文把「错误答案」对应到换模型,也有些过快。检索范围、工具返回内容、指令歧义都可能影响答案;同样,增加轮次也未必能解决未完成问题,模型可能继续低效搜索。两类失败应该走不同的排查路径,不能各自只剩一种处方。
原文关于轮次上限的解释也需要保留疑问:它把每轮携带的输入量与第一题被截断联系起来,但汇总数据不足以建立这个因果关系。直接证据只有 Gemini 在第六轮仍未完成。
19 道题中,一题就能让成功率变化超过五个百分点。没有重复运行,也没有更多任务或替代策略的对照,这是一组有诊断价值的经验记录。
上下文能力同样没有测到边界。最长文档约 14,000 Token,原文列出的两个模型窗口上限分别是 200,000 和 1,000,000 Token。远未填满窗口的查找题,不能替代长上下文极限测试;而且这次只测了文本输入。
能拿来做什么
- 在 Node 调用层同时记录 HTTP 状态、
stop_reason、最终文本和工具执行状态,把「未完成」单独计数,避免空答案一路传到前端。 - 给机器消费的输出增加明确校验。要求纯整数就验证完整文本,格式不合格直接记为失败,再进入修复或重试流程。
- 比较模型时,用自己的中文任务重复运行,重点覆盖日志查找、仓库常量读取和严格格式输出,并分别记录失败原因。
- 用实际输入、输出、推理 Token 和轮次计算任务成本;存在重复长前缀或异步任务时,再单独评估缓存与 Batch 能节省多少。