把Twist讨论接入代理记忆,检索团队决策
作者为开源代理记忆层cognee开发Twist连接器,将频道和讨论串导入后支持自然语言问答。文章介绍使用方法、内部实现及审查发现的问题,并探索与Basecamp、Mailchimp信息汇合。
AI 深度解读
团队在 Twist 里讨论了三天,拍板藏在第五条评论里。几周后再问「结账页到底选了哪个方案」,搜索能找到讨论串,却还得靠人重新读一遍。作者给 AI 记忆层 cognee 做了一个 Twist connector,想让这些讨论成为可以直接提问的团队记忆。
这篇最有用的部分,是作者如何处理同步中的麻烦:评论改了怎么发现,权限丢了会不会误删,源头删除后知识图谱是否还留着旧内容。问答只是入口,可靠地更新和遗忘才是工程重点。
一条团队决策,为什么要连着整串讨论保存
作者在 Mergetober 期间,为 Twist、Basecamp 和 Mailchimp 分别编写了 connector,模拟产品发布时讨论、任务、公告分散在三个应用中的情况。目标是把它们同步到同一个 cognee 实例,再统一提问。本文实际展开的是 Twist 部分,对应 cognee-community 的 PR #364 和 issue #4736。
作者的测试工作区里,#launch 频道有一个「Checkout redesign」讨论串,开场明确写着先发布 option B,日期为 15 March,后续评论确认了决定。
最初的设想是每条评论生成一份文档,但作者放弃了这个方案。第五条评论可能只有一句「确认」,离开提案和前面的争论,无法知道确认了什么。
因此,一个讨论串对应一份文档,依次包含标题、频道、首帖,以及带作者和日期的全部评论。每个频道另有一份简短文档,并用 twist:<workspace_id>:<channel_id> 这样的节点集合标记限定检索范围。
下面是原文的调用方式,用于同步指定频道并查询其中的决策:
import json, os
import cognee
from cognee_community_connector_twist import twist_source

token = json.load(open(os.path.expanduser("~/.twist_tokens.json")))["access_token"]

await cognee.remember(
    twist_source("254427", access_token=token, channel_ids=[852087]),
    dataset_name="twist",
    write_disposition="merge",
)
print(await cognee.recall("What did the team decide about the checkout redesign?", datasets=["twist"]))
要盯住的是 write_disposition="merge"。作者指出,remember() 默认使用 "replace",会破坏这套增量同步和删除机制。connector 通过 dlt 向 cognee 提交数据,以 thread:<id> 作为稳定键。
作者这次实测没有配置 LLM key,而是使用 cognee 的 keyless mode,所以 recall 返回最佳匹配片段,没有生成自然语言答案。原文展示了真实输入和同步情况,但不足以证明复杂问题也能得到准确回答。
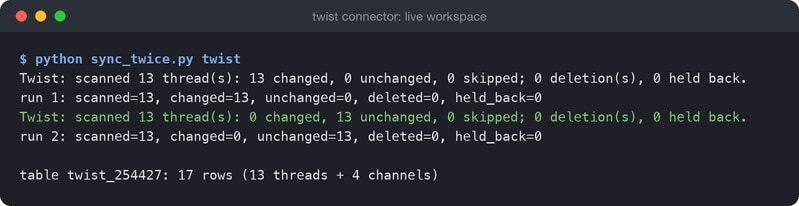
增量同步最难的地方,是判断什么真的变了
Twist 文档提供了 last_updated_ts 和 comment_count。看上去,只要时间或评论数变化,再读取详情即可。
实测却发现,last_updated_ts 会漏掉不少编辑。API 响应还有一个未写入线程对象文档的 version 字段,能捕捉更多变化。作者最终比较四个值:version、last_updated_ts、comment_count 和 channel_id。
但 version 也会因收藏操作变化,正文可能一个字都没改。因此,connector 对渲染后的每行数据计算 SHA-256,哈希与上次相同就跳过,避免重复提交。
变化信号用来决定是否读取,内容哈希用来决定是否写入。
还有一个补不上的洞:编辑较早的评论,线程级字段可能全都不变。作者采用定期重扫,首次运行读取所有评论,之后每第 10 次运行重扫一次,由 full_sync_every 控制,也可以传入 full_sync=True 强制扫描。旧评论修改会延迟进入记忆,README 对此做了说明。
真实 API 还有几处容易踩坑:
- 已删除评论仍会出现在
comments/get,带有deleted: true,内容是"-",需要过滤。 - 重命名、移动、关闭讨论串会产生系统评论,也需要跳过。
is_archived表示个人 Inbox 的「已处理」状态,不能据此删除线程。comments/get不指定范围时返回最后 N 条评论,因此要用from_obj_index、to_obj_index显式按 500 条窗口读取。- token 被拒绝时,返回的是 HTTP 403 加错误码 200,而非 401。
这些细节决定了同步结果是否完整,也解释了为什么只对照接口文档写代码还不够。
讨论串消失了,为什么不能马上删除记忆
源头删除线程后,connector 会产生类似 {"id": "thread:123", "_deleted": True} 的删除标记。dlt 删除对应行,cognee 再通过孤儿清理移除文档及其关联图数据。
困难在于,「列表里没有」有多种原因:真的删除了、频道 ID 配错了、token 丢失权限了,或者 API 响应出了问题。
作者为此加了三层约束。单次 404 不构成删除依据,因为不可访问也可能返回 404;任何 API 错误都会在写入删除标记前终止运行,dlt 只在加载成功后保存状态;如果本轮新消失的数据至少有 10 项,且超过之前同步数据的一半,就暂缓删除,记录为 held_back,下次运行再确认。
下面这段代码解决的是批量删除需要复核,以及复核期间又有新删除时如何继续推进:
gone = sorted(set(previous) - set(present))
pending = set(state.get("pending_delete") or [])
confirmed = [key for key in gone if key in pending]
fresh = [key for key in gone if key not in pending]
large = len(fresh) >= MASS_DELETE_MIN_ITEMS and len(fresh) > max_delete_ratio * len(previous)
if large and not allow_mass_delete:
    present.update({key: previous[key] for key in fresh})
    state["pending_delete"] = fresh
    stats["held_back"] = len(fresh)
    gone = confirmed
关键是 confirmed 和 fresh 的拆分。作者早期要求两次缺失集合完全相同才确认删除,结果只要不断新增删除项,整批数据就可能永远留着。
评审 goran-radonic 在三轮 review 中还发现了归档频道状态丢失、重试参数异常、统计计数沿用上轮结果等问题。其中一个真实 dlt 加 SQLite 的回归场景,修复前误删 13 行,修复后为 0。
限流处理也有明确边界:因为数据源执行期间 cognee 持有 staging lock,超过 60 秒的等待会直接终止运行。Retry-After 为 0、负数或 nan 时回退到指数退避,inf 则触发 TwistRateLimitError。
最后一轮,作者逐个撤销 9 项修复,确认每次至少有一个测试失败。另有测试通过 cognee 的 add + cognify,mock LLM 后检查删除线程确实离开知识图谱,其他线程保留原有 ID;关闭删除标记或 dlt 的 hard_delete hint,测试都会失败。
我的判断
这套实现最值得借鉴的是删除链路。团队知识会被修改和撤回,记忆系统如果只会添加,迟早会把过时决定继续当作依据。作者把删除验证推进到知识图谱层,比只检查数据库少了一行更有说服力。
但它仍有明确前提。每轮都要列出选定频道的全部线程,每 500 个线程一次请求,另有每个变化线程的一次请求。它减少的是后续读取和处理,不能省掉全量枚举。较早评论的修改还要等下一次重扫,也不是实时同步。
免费套餐的限制更直接:Twist API 隐藏超过一个月的评论,旧线程重新渲染后,这些评论也会从记忆中掉出去。此外,图片被丢弃,附件只保留名称和链接,不下载;私信则明确不读取。
和关键词搜索相比,它尝试保留讨论上下文并支持自然语言提问;和更简单的片段检索相比,图结构是否带来更好效果,作者没有提供对照数据。跨应用问答也没有在本文展示完整验证。因此,问答收益目前更多是作者的使用经验,可靠同步则有更具体的实测支撑。
能拿来做什么
- 如果团队已经用 Twist 讨论前端方案,可以先选一个频道试用,围绕「结账页选了哪个方案」「发布时间是否确认」核对返回片段。README 使用的只读权限是
workspaces:read、channels:read、threads:read、comments:read,完整示例在examples/example.py。 - 给 Node 或 AI 编程助手接入团队讨论时,可以借鉴「整串保存、稳定 ID 合并、内容哈希去重」的设计,同时明确旧评论修改的同步延迟,避免助手把旧决策当成最新结论。
- 为自己的同步器补一个贯穿存储和检索的删除测试:删除源记录后,既检查原始行,也检查检索结果和知识图谱。再单独撤销修复,确认测试确实能发现故障。