给智能体独立知识库,隔离私人笔记
文章主张为智能体建立独立Wiki,避免直接开放混有日记、薪酬和未发布计划的个人笔记库。它还指出自动写回与多个智能体共享写入可能带来信息泄露和内容冲突。
AI 深度解读
让 Agent 记住更多东西,不一定能让它更可靠。作者的主张是:给 AI 单独建一个可检索、可引用的 wiki,把个人笔记库留给人。真正要先解决的是知识访问边界,而不是接入哪个记忆仓库。
这篇文章值得读的地方,在于把「共享大脑」拆成了具体的工程问题:哪些页面能读、谁能写、多个 Agent 如何避免互相覆盖,以及怎样验证隐私内容确实查不到。对同时使用 Claude Code、Codex 的团队,这比继续堆记忆文件更有参考价值。
为什么把整个笔记库交给 Agent 会出问题
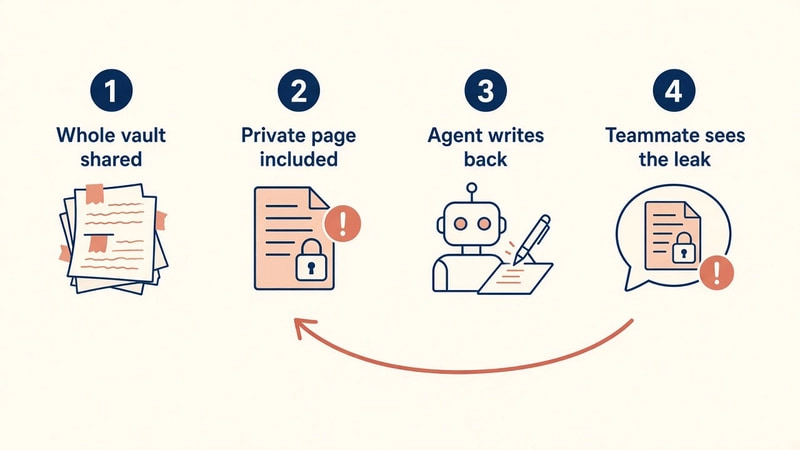
个人 Obsidian vault 是工作台,里面可能混着日记、薪酬记录、未公开计划、情绪草稿和过期判断。人知道哪些只是随手一写,Agent 未必分得清。
把整个库开放给它,会同时引入两类风险。
第一类是读得太多。私人页面里的某句话,可能被带进站会摘要、pull request,甚至另一个同事的会话。内容能被检索到,并不代表它适合成为回答依据。
第二类是写入冲突。自动整理来源、补链接、维护 wiki 看起来很省事,但多个 Agent 修改同一份资料时,也可能覆盖彼此的结果。
作者援引了一项流传中的 Anthropic Agent 记忆实验:多个 Agent 同时向共享表格写入合同条款,发生覆盖,最终依据 wiki 生成的简报只保留了 57 个评分事实中的 41 个。给出的修复办法是每份合同单独一页、每页只允许一个写入者,并保留条款原文引用。
这个案例指向的是信息组织和写入协调问题。模型再聪明,也无法从已经被覆盖的页面里找回事实。不过,原文没有提供完整实验条件和修复后的对照成绩,不能据此推算一般团队的错误率。
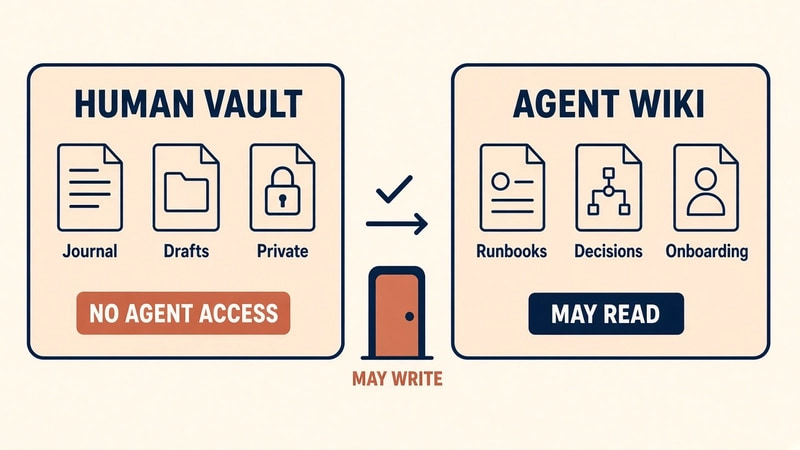
两个知识库,怎样变成真正的权限边界
作者提到,11 月 11 日,Obsidian 的开发者 Steph Ango(kepano)分享的一个变化,是给 Agent 单独准备 LLM wiki vault。作者认为,这种拆分比个人笔记库又增加了什么功能更关键。
具体可以分成两个空间:
- Vault A 是人的工作区,存放日常记录、白板和草稿,默认不给 Agent 访问凭证。
- Vault B 是 Agent 使用的 wiki,收录经过筛选的操作手册、架构说明、当前决策和入职资料,允许模型检索与引用。
原始来源保持不可变;模型生成的综合页面放进 Vault B。这样既方便追溯,也能避免自动整理结果混进私人日记。
先划定可读范围,再考虑开放写入。
这里有个原文缺口:小节标题写的是「两个库、三种权限」,正文却只明确列出了「可写权限最后开放,而且应当很少开放」,另外两项没有完整展开。可以确定的原则是先从只读开始,但不宜替作者补出一套完整权限模型。
作者建议在 AGENTS.md、CLAUDE.md 等规则文件里明确:只依据 Agent wiki 回答并注明页面;不搜索人的笔记库;只有标记为已批准导入的任务才能写入;wiki 没有的事实就承认缺失。
这些规则需要访问凭证配合。只写一句「不要搜索私人笔记」,同时又把整个库挂给工具,边界依然脆弱。
Claude Code 和 Codex 之间的 Markdown 交接也遵循同一逻辑:两个工具都指向同一个受限 wiki,才有共同的知识依据。各自积累一套互不可见的私有记忆,不能自然形成共享上下文。
作者进一步把知识工作区、模型服务和聊天界面看成独立层。调整工作区凭证不需要重新训练模型,更换模型也不必扩大资料访问范围。
文中推荐了作者参与开发的 AFFiNE:开源、local-first,支持文档、白板和数据库,提供可选的 BYOK AI,以及默认只读的工作区 MCP server。作者也明确承认,如果只需要静态手册,或者需要 Agent 在当时的 stable release 中写入工作区,它并不合适。原文没有给出具体版本号。
我的判断
我认同先隔离资料、再接模型的顺序。它把一个容易被包装成「AI 记忆能力」的问题,落到了访问控制、来源引用和并发写入上。这些都是团队可以检查和约束的东西。
但两个库只是起点。谁来筛选页面、旧决策怎样标记失效、生成内容由谁审核,原文没有展开。没有维护责任,Agent wiki 也可能变成另一个过期资料堆。
作者关于「周末拼出来的文件夹 hook 撑不起团队」的判断偏强,也带有产品推荐背景。小团队使用 Git 管理 Markdown,配合目录隔离、只读凭证和 PR 审核,同样可以实践文中的原则。是否需要完整知识库软件,要看权限粒度和协作需求;原文没有给出两者的对照数据,这部分应当视为经验之谈。
自托管也不能单独证明推理留在内部。工作区部署在哪里、模型请求发往哪里,是两项需要分别确认的配置。
能拿来做什么
- 给日常 AI 编程建一个经过筛选的 wiki,先收录项目架构、操作手册和当前决策,并要求回答注明来源页面。
- 按作者的一小时检查流程,回看最近一周 Agent 引用过的 10 个页面,再列出 5 个禁止读取的页面,验证现有凭证确实无法访问;能访问就撤销并换成范围更小的凭证。
- 关闭日常写权限,只保留经过人工审核的单一导入路径;多个 Agent 整理同类资料时,采用每个对象单独一页、每页一个写入者的安排。
- 让 Claude Code、Codex 指向同一个受限 wiki,再问一个答案只存在于私人笔记库的问题。合格结果是明确表示没有资料;若回答出了私密内容,就继续排查访问范围。