LLM 接口压测该测哪些指标
文章围绕延迟、吞吐量、输出质量与稳定性构建 LLM API 评测框架,并提供代码示例。重点是用业务提示词和并发负载评估服务表现,补充学术能力榜单无法反映的运行指标。
AI 深度解读
LLM 能答对问题,不代表接进应用后就能稳定服务用户。作者在 2025 年 3 月遇到聊天机器人高峰期超时,此后搭了一套评测流程:先测单次请求,再加并发,最后观察输出质量和跨时段波动。
它最有用的地方,是把「模型强不强」改成「这套服务能不能满足业务要求」。不过,原文自称经过生产验证的代码仍有缺口,尤其是质量检测与统计口径,直接照搬容易得到漂亮却失真的结果。
能力榜单回答不了接口会不会超时
MMLU、HumanEval 主要衡量模型能力,却不能告诉你:流量突然上涨时,你的请求能否在 2 秒内完成。作者举了一个取舍:MMLU 高出 5%,但延迟增加 800ms,对面向用户的产品未必划算。这里是解释问题的假设,并非具体模型的对照实验。
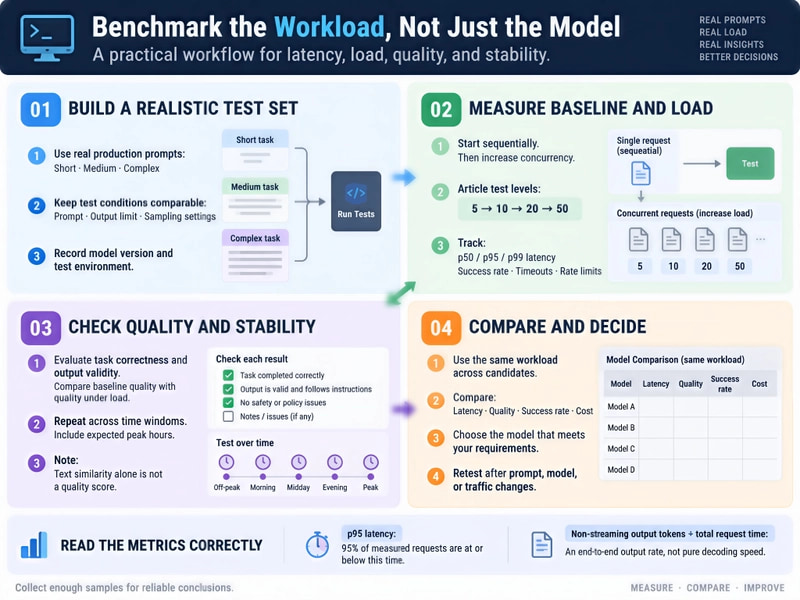
他的起点是生产流量里的三类提示词:短查询为 10-20 tokens,中等任务为 100-150 tokens,复杂指令为 300+ tokens。这样至少能让测试接近实际输入,而不是只拿一句「你好」判断服务快慢。
基础实现通过 httpx.AsyncClient(timeout=30.0) 请求 /chat/completions,传入 model、messages 和 max_tokens: 500。请求前后用 time.perf_counter() 计时,再从 usage.completion_tokens 取输出量,计算每秒 token 数。
顺序测试默认执行 10 次,每次间隔 0.1 秒,汇总成功率、p50、p95、p99 延迟与平均吞吐。
这些指标需要拆开理解。p95 表示约 95% 的请求延迟不超过这个值,适合观察慢请求;它不是原文所说的「大多数用户的体验」,典型请求通常更接近 p50。代码中的 tokens/s 则是输出 token 数除以完整请求耗时,包含等待和网络开销,也不是流式生成阶段的纯输出速度。
先明确测量口径,再比较数字,否则同名指标也可能回答不同问题。
并发测试要找到服务开始变慢的位置
作者观察到,有的供应商能撑住 20 个并发请求,之后延迟急剧上升;另一些在 10 个并发后就积极限流。原文没有公开供应商名称、套餐和完整数据,因此这些只能算作者的使用观察。
下面这段代码解决的是限制同时在途请求数量的问题:
async def run_concurrent(self, prompt: str, model: str, concurrency: int = 10, total: int = 100):
    """Test performance under concurrent load."""
    semaphore = asyncio.Semaphore(concurrency)

    async def bounded_request():
        async with semaphore:
            return await self.single_request(prompt, model)

    tasks = [bounded_request() for _ in range(total)]
    results = await asyncio.gather(*tasks)

    return self._calculate_stats(results)
重点看 async with semaphore:它控制同时执行的请求数,默认是 10,总请求数默认是 100。但 single_request 在获得信号量后才开始计时,因此等待并发名额的时间没有进入请求延迟。应用如果也有排队,用户实际等待可能更久。
作者按 5、10、20、50 个并发逐档测试。他们团队的要求是:20 个并发下,p95 仍低于 2 秒;不到 10 个并发就明显退化,会被视为风险。这个门槛属于他们的业务,不能直接当作所有项目的及格线。
文末又建议按预期峰值的 2x、5x、10x 压测。这里需要补上单位:并发数描述同时有多少请求在处理,并不等于每秒进入多少请求。先估计业务峰值对应的在途请求量,倍数才有意义。
此外,基础代码每次调用都创建一个 AsyncClient。测到的耗时会包含客户端初始化、连接建立等因素。若生产服务复用连接,测试也应该采用相同方式,否则测量对象已经发生变化。
输出稳定和服务稳定,得分开验证
质量检测部分,作者让同一提示词在负载下执行 50 次,默认并发为 10,再用 SequenceMatcher 比较相邻回答的文本相似度,最多比较 10 对。他对事实问答的预期是高于 0.8,对创作任务则认为 0.4-0.6 正常。
但原文代码存在一个会直接影响结论的问题:single_request 没有返回 response_text,质量检测却使用 result.get("response_text", "") 读取文本。成功请求会被当成空字符串,两段空字符串的相似度为 1,结果可能显示高度一致,却根本没比较模型回答。
即使补齐文本,相似度也不等于正确率。事实回答可以措辞不同但同样正确,也可以每次都重复相同错误。作者想发现「把错误信息包装成正常回答」和 token 限制执行不一致,这个方向合理,但还需要检查回答内容、结束原因和任务是否完成。
服务稳定性则是另一个维度。作者记录,2025 年 10 月 15 日,某供应商的 p95 在 30 分钟内从 1.2 秒涨到 4.8 秒,随后恢复。这是一次具体现象,不能据此推断波动的原因。
他的稳定性测试默认 duration_minutes=30,每轮顺序请求 n=5 次,轮间等待 interval=60 秒,再计算各轮 p95 的均值、标准差、最小值和最大值。作者偏好的门槛是:标准差不超过均值的 30%,最差 p95 不超过最好 p95 的 2x。
这里也有两个统计限制。每轮只有 5 次请求,按代码的索引算法,p95 实际就是这一轮最大值;默认 10 次顺序测试中的 p95、p99 也都落在最大值上。另一个是运行时间:请求本身要耗时,再加轮间等待,所谓「30 分钟窗口」通常会超过 30 分钟。
我的判断
我认可这套流程的顺序:真实提示词建立基线,并发测试寻找退化点,跨时段测试检查波动。它比只看能力榜单,更接近应用选型要解决的问题。
它适合作为评测骨架,不能直接当成可靠的选型报告。
除质量检测缺失外,统计函数只拿成功请求计算延迟。大量请求超时时,剩下的成功请求依然可能很好看,所以 p95 必须和成功率、错误类型一起读。作者也承认还要补重试、错误分类与成本追踪,但没有给出实现。
跨供应商比较时,他保持提示词和参数一致,用 compare_models 分别执行 20 次顺序请求,以及并发 10、20、各总计 50 次的测试,模型之间等待 2 秒。结果保存为 JSON,并记录每 1000 次请求的估算成本,计算思路是 tokens × 每 token 单价。
这有助于固定实验条件,却还缺少采样规模、重复轮次及完整结果。作者关于准确率与延迟波动、时段影响的结论,目前仍是经验之谈。
原文还介绍了他们团队的 RollTok:统一端点可切换超过 60 个模型。这带有产品推广性质。统一 API 确实能减少适配代码,但测试结果也包含中间服务的影响;直接调用供应商 API 则需要维护更多差异。应当测试应用最终采用的调用路径,而不是默认某种接入方式一定更优。
能拿来做什么
-
给聊天助手或 Node AI 接口建立一组真实请求样本,覆盖原文的三档输入长度,同时固定输出要求。比较完整请求延迟时,也把实际输出 token 数一起记录,避免把回答更短误判为服务更快。
-
在切换模型前跑顺序基线,再按 5、10、20、50 个并发寻找退化点。若前端采用流式输出,另测首个可见内容出现的时间,因为原文的非流式总耗时无法回答用户多久能看到第一段内容。
-
修复
response_text缺失后,再为实际任务定义质量检查。事实问答核对答案,要求 JSON 的任务检查能否解析及字段是否完整,把文本相似度保留为辅助信号。 -
在实际业务高峰执行稳定性测试,记录日期、模型、并发、p95、成功率和每 1000 次请求成本。重试前后的请求与耗时分开记录,才能判断服务波动是否被重试掩盖。