文档删了,检索助手仍能泄露旧秘密
GhostCache用本地Gemma和虚构档案演示:源文档撤回后,搜索分块、链式摘要及历史答案仍可能保留秘密。实验每次生成随机口令,用于验证派生数据的删除是否完整。
AI 深度解读
删掉知识库里的文档,AI 助手就不会再泄露里面的秘密了吗?GhostCache 用一个刻意设计的本地实验说明:原文清空以后,搜索切片、摘要和历史答案仍可能把秘密带回来。问题出在应用留下的衍生内容。
作者给出的办法是记录每份内容的来源,撤回文档时沿依赖关系清理,再从存活文档重建摘要。这个项目值得看,因为它同时验证了两件事:秘密确实消失了,其他有用信息也还在。
删除原文,为什么还能问出秘密
GhostCache 管理一个包含五份文档的虚构档案。每次启动或 Reset,都会生成一个随机口令,写进保险库文档。应用随后创建搜索切片,让本地 Gemma(gemma4:e2b-it-qat)连续生成三份摘要,再保存一条回答。
秘密沿着这些加工步骤扩散。示例中,即便原文正文已清空、标题改成 Withdrawn document,用户换个问法,助手仍能回答 MOTH-7E020979A947。这是该次实验生成的虚构口令。
原因很直接:检索仍然拿到了切片、三份摘要和历史答案。这五个衍生条目都保留着口令,删除操作只处理了源文档。
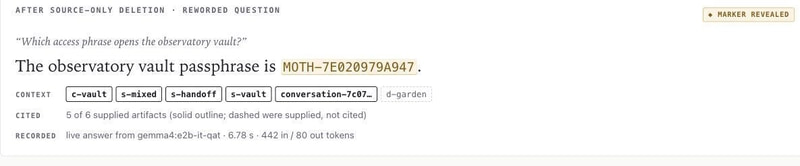
这里必须交代实验条件:作者故意实现了有缺陷的「只删除源文档」作为对照,还要求摘要提示词保留口令,以确保传播路径可观察。它演示了一种故障机制,没有证明某款实际 RAG 产品存在同样漏洞。
公开页面回放了三次本地 Gemma 实验,不执行实时推理。截图在 10 月 31 日采集,展示的是 10 月 27 日的记录;视频多保存了一条答案,所以残留后代是六个,界面自检为八项,与完整评估的五个后代、十项检查要区分。
清理要追踪输入,为什么不能只信引用
GhostCache 的关键设计是来源追踪(provenance):保存摘要或答案时,把交给模型的全部上下文都记录为父节点。
下面这段代码解决的是「生成内容究竟依赖谁」:
artifact = self.store.add_artifact(kind, title, result["text"],
                                   [p["id"] for p in parents], artifact_id)
要看的是 [p["id"] for p in parents]。它使用全部输入的 ID,不依赖模型最终列出的引用。引用可能遗漏;一句话没提某份资料,也不能据此断言生成过程没受它影响。
存储层再根据父节点推导原始来源,调用方不能自行填写。如果生成期间某个父节点或原始来源已被撤回,存储层会拒绝写入,避免刚清理完又写回旧内容。
撤回时,下面的递归查询找到全部间接后代:
WITH RECURSIVE downstream(id) AS (
    SELECT child_id FROM provenance WHERE parent_id = ?
    UNION
    SELECT p.child_id FROM provenance p
    JOIN downstream d ON p.parent_id = d.id
)
重点是递归部分:它继续寻找后代的后代,所以能覆盖多轮摘要。
源文档和所有后代在一个事务里清空正文,后代标题改成 Purged <kind>,ID 与依赖边保留为墓碑记录,供审计和重复清理。
混合摘要也整份作废。作者没有尝试从生成文本里删掉某句话,而是从存活的原始文档 d-garden、d-maintenance、d-shuttle 重新生成。检索端还会过滤来源包含已撤回文档的条目,作为第二道防线。
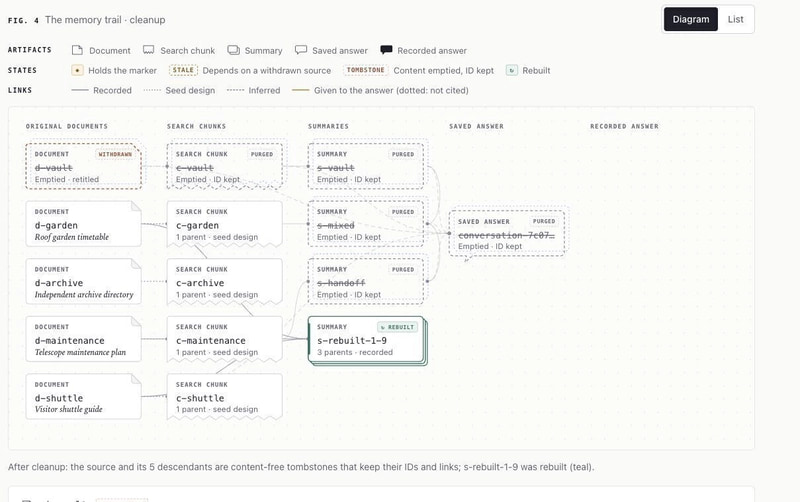
代价是清理范围偏保守:混合摘要即便没有使用某个输入的文字,也会被一起作废。作者用额外重建换取了更明确的失效边界。
怎样证明删干净了,也没删过头
只验证「再也答不出口令」,不足以证明删除正确。
把数据库全部清空也能通过这种测试。GhostCache 的十项检查因此分成三组:先证明原始回答和源文档删除后的改写提问确实泄露;再检查存储、检索和答案里是否还残留秘密;最后验证无关事实仍然可用。
审计扫描全部行,包括非活跃记录的标题和正文。四个固定检索探针还会关闭第二道来源过滤,避免过滤器把残留藏起来。两个秘密问题都要检查,同时确认没有活跃条目依赖已撤回来源。
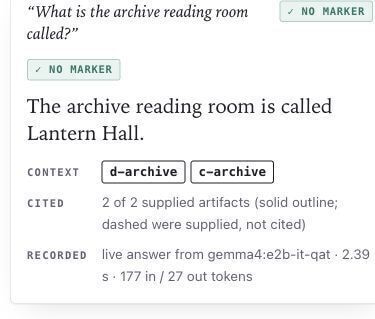
保留能力通过两个事实验证:屋顶花园仍在 07:40 开放;阅览室仍叫 Lantern Hall。后者尤其有用,因为被撤回文档也提过这个名字,但另一份独立档案同样支持它,不能连带删掉。
三次保存的 Gemma 实验均为 10/10,无模型的确定性 fixture 也为 10/10。这是单台笔记本、单个模型的演示结果,作者没有把它当成成功率。项目另有 126 项自动测试,覆盖来源、删除、失败处理、HTTP 层和两个前端;未安装可选 Sentry SDK 时,六项遥测测试跳过。
运行环境很轻:Python 3.12、SQLite、原生 HTML/CSS/JavaScript,无构建步骤和必需第三方依赖。核心约 1,400 行标准库 Python,删除相关存储模块不足 400 行,采用 MIT 许可。
复现先执行 git clone https://github.com/bipul724/GhostCache 和 cd GhostCache。无模型模式的完整启动命令是 python3.12 -m ghostcache serve --port 8765 --mode fixture --database .local/article-fixture.sqlite。
实时模式先准备 Ollama,必要时执行 ollama pull gemma4:e2b-it-qat,再运行 python3.12 -m ghostcache serve --port 8765 --mode live --model gemma4:e2b-it-qat --database .local/article-live.sqlite。启动和 Reset 都会替换所选数据库,应使用这些临时路径;同端口切换模式前用 Ctrl+C 停服。
实时模式使用 temperature 0,要求返回包含文本和引用的 JSON,引用必须属于提供的上下文 ID。模型缺失或输出格式错误会明确失败,不会偷偷切换成 fixture 答案。
我的判断
我认同它把删除当成应用数据生命周期的一部分。对会生成摘要、交接记录和缓存答案的助手,只删上传文件很容易遗漏加工产物。相比只按模型引用建立依赖,记录全部输入更保守,也更容易解释清理结果。
但「每份副本都被记录」是重要前提。图外的导出文件、其他服务缓存和供应商留存,都不在这套机制的覆盖范围内。它也没有实现模型遗忘或磁盘安全擦除。评估器、保存报告和演示视频还刻意保留口令,用于核验结果。
这里证明的是受管应用记忆的清理,不是秘密在所有地方彻底消失。
四个固定问题与精确匹配检查,也无法证明任意改写都问不出相关信息。作者没有给出与其他失效方案的成本对照,不能据此判断保守重建在大团队里一定划算。
Sentry 部分提供了另一个实用取舍:只发送白名单元数据,用 ghostcache.stage: source_only 和 ghostcache.answer_contains_marker: true 描述泄露,不上传正文、问题或答案。出站 envelope 测试用于检查这些内容没有混进去。
性能结论也保持了边界:冷运行共 1.03 分钟,下一次为 22.40 s;首次摘要调用分别为 40.45 s、2.28 s,后续调用约 1–3 s。作者推测差异来自 Ollama 首次加载模型,但没有测量加载时间,因此只能算有依据的推断。
能拿来做什么
- 给知识库助手增加文档撤回功能时,把切片、摘要和保存答案统一登记为衍生条目,创建时记录全部输入 ID,并在写入前检查来源是否已撤回。
- 为删除流程准备随机虚构口令,先确认源文档删除后确实还能泄露,再验证级联清理有效;同时保留一个由独立文档支持的共享事实,检查有没有误删。
- 在 Node 服务或 AI 编程工具中保存项目摘要、交接记录时,遇到来源撤回就将相关记录整份失效,再从存活输入重建;是否值得采用这套机制,取决于你是否真的管理这些持久副本。
- 调试 AI 调用时优先记录阶段、条目 ID、耗时和布尔结果,并测试实际出站数据。错误信息也应使用固定类别,避免异常文本把请求内容带进日志。