把 AI 接入 Ghidra:从反编译到函数命名
开源 GhidraMCP 将反编译、交叉引用、重命名和注释等能力暴露给 MCP 客户端。文章以 Apple Silicon Mac 上的实际操作,演示分析去符号二进制并识别校验和、gzip 函数,也记录了遇到的问题。
AI 深度解读
GhidraMCP 把 AI 接进了真正的逆向工程工作台:模型可以读取反编译结果、追踪调用关系,再把函数名和注释写回 Ghidra 项目。作者用一个去掉符号的 minigzip 验证了这条流程,Claude Code 在约 40 秒内找出解压函数,并正确命名了它调用的几个 zlib 函数。
这篇值得看的地方,是它把安装障碍、分析证据和失败案例都摆了出来。对程序员来说,最有用的问题也在这里:AI 接上工具之后,哪些工作能交出去,哪些结果仍要自己核验。
AI 能读反编译代码,还要能把结果写回去
逆向分析经常从 FUN_100000db8 这样的匿名函数开始。读代码、猜用途、改名字、补注释,然后继续追踪下一个调用。单独把代码贴进聊天窗口,模型能解释一段,却很难持续掌握整个项目。
LaurieWired 开发的 GhidraMCP 用两层组件连接这些工作。Ghidra 内的 GhidraMCPPlugin 提供 HTTP 服务,默认地址是 http://127.0.0.1:8080/;Python 服务 ghidra-mcp 对接 MCP 客户端,把模型的工具调用转成发给插件的请求。
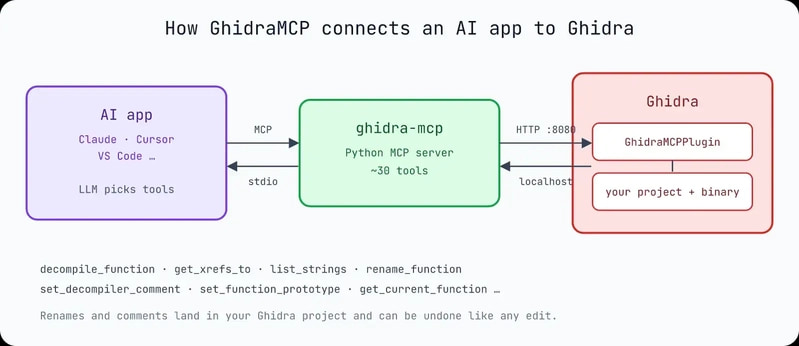
GUI 模式直接操作 CodeBrowser 中打开的程序,改名和注释会立即显示,也能撤销。Headless 模式通过 PyGhidra 导入、分析文件,使用随机回环端口,适合终端脚本或隔离环境。两种模式的核心工具相同,作者的 headless 会话列出了 28 个工具,Claude Code 中显示为 mcp__ghidra__*。
真正有积累价值的产物,是保存了分析结果的 Ghidra 项目。
函数改名后,所有调用它的位置都会变得易读。--project DIR 用来保留项目;省略这个参数,临时项目会被丢弃。GUI 还提供 get_current_function、get_current_address,允许用户点中函数后直接提问。
跑通这套环境,版本和平台比配置更容易卡人
作者使用 Ghidra 12.1.4、GhidraMCP 2.0 和 Java 21,JDK 目录是 jdk-21.0.12.1+1。扩展版本必须与 Ghidra 精确匹配;其他版本需要针对自己的 GHIDRA_INSTALL_DIR 从源码构建扩展。
Apple Silicon 上还有一步:原文所用发行包缺少 macOS 原生组件,需要先安装 Xcode 命令行工具,再执行 cd support/gradle && ./gradlew buildNatives。作者机器上约耗时 10 秒。必须从 support/gradle 运行,直接在 Ghidra 根目录执行会报没有 Gradle 构建。
安装包也有一层包装。GhidraMCP-release-2-0.zip 解压后,里面的 ghidra_12.1.4_PUBLIC_20261010_GhidraMCP.zip 才是扩展,另有 ghidra_mcp-2.0.0-py3-none-any.whl 和源码包。
下面是作者使用的 headless 客户端配置,它把 Python、Java、二进制文件和持久项目放在一起指定:
{
  "mcpServers": {
    "ghidra": {
      "command": "uvx",
      "args": [
        "--python", "3.13",
        "--from", "ghidra-mcp[headless] @ git+https://github.com/LaurieWired/GhidraMCP",
        "ghidra-mcp", "--headless",
        "--binary", "/Users/you/tools/ghidra-demo/minigzip",
        "--project", "/Users/you/tools/ghidra-demo/proj"
      ],
      "env": {
        "JAVA_HOME": "/Users/you/tools/jdk-21.0.12.1+1/Contents/Home",
        "GHIDRA_INSTALL_DIR": "/Users/you/tools/ghidra_12.1.4_PUBLIC"
      }
    }
  }
}
重点看 --project 和两个环境变量;路径需要替换。Headless 还要求 Python 3.13 与 [headless] 依赖。VS Code 的 .vscode/mcp.json 使用 servers 键,并声明 "type": "stdio"。
GUI 模式遇到端口占用,可用 lsof -nP -iTCP:8080 -sTCP:LISTEN 检查,再通过 --ghidra-server http://127.0.0.1:<port>/ 指向新端口。Python 服务连接不到插件时只记录警告,不会启动失败,所以「工具出现在列表里」不代表能调用成功。
识别函数靠证据,改名只是最后一步
实验对象是 zlib 1.3.2 的 test/minigzip。作者通过 ./configure --static && make libz.a minigzip 构建,再用 strip 去掉符号。得到的 arm64 文件约 102 KB,Ghidra 识别出 170 个函数,除 entry 外都没有可读名称。首次导入分析约耗时 6 秒。
作者先用脚本验证工具链,再让 Claude Code 自己选择工具。这是两次不同的实验。
脚本从算法指纹入手:Adler-32 使用模数 65521,也就是 0xfff1;CRC-32 的反射多项式为 0xEDB88320;gzip 文件头是 1f 8b。由于没有直接搜索常量的工具,脚本逐个反编译再匹配:
consts = {"0xfff1": "65521 (Adler-32 modulus)",
          "0xedb88320": "CRC-32 polynomial",
          "0x8b1f": "gzip magic 1f 8b"}
for f in (await call(session, "list_functions", limit=500))["items"]:
    code = (await call(session, "decompile_function_by_address",
                       address=f["address"])).get("code") or ""
    hits = [v for k, v in consts.items() if k in code]
    if hits:
        print(f'{f["address"]}  {f["name"]:<16} {", ".join(hits)}')
要留意 if k in code:它匹配的是反编译文本,常量换一种表示就可能漏掉。截图记录扫描耗时 46.7 秒,正文概括为约 40 秒,共筛出 10 个候选。
随后才是语义确认。FUN_100000db8 把校验值拆成两个 16 位和,空缓冲区返回 1,每处理 0x15b0 = 5552 字节再取模。5552 对应 zlib 的 NMAX,用于避免 32 位累加器溢出。这些证据共同支持将它识别为 adler32_z。
Claude Code 的独立实验则从字符串开始:版本标识暴露了 zlib,failed fwrite 引向错误分支,get_xrefs_to 帮它追到主函数和每次读取 16 KB 的解压循环。命名前,它继续反编译被调用函数,例如用 state->mode == 0x1c4f,即 GZ_READ (7247),支持 gzread 的判断。
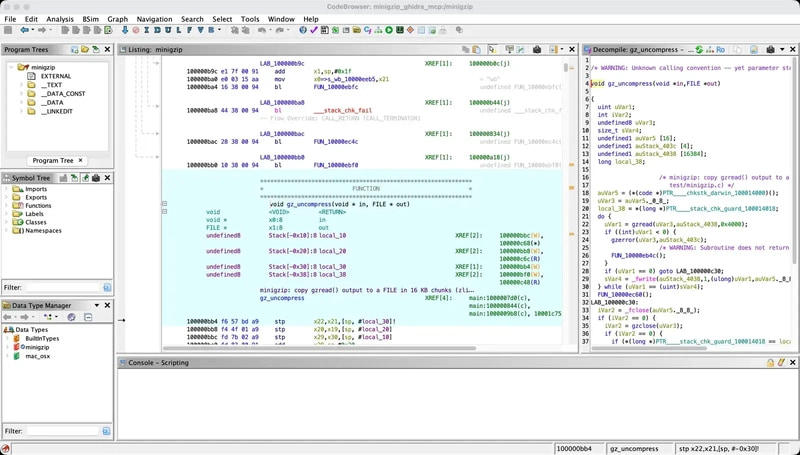
最终它命名了 gz_uncompress、gzread、gzerror、gzclose,并添加注释。作者事后对照源码,确认四个名称都正确。这次运行共 17 轮,耗时 40.6 秒,Claude Code 报告费用为 $0.28;--tools "" 禁用了内置工具,--output-format stream-json 将调用过程记录进 run.jsonl。
我的判断
这次实验支持一个具体结论:面对有字符串、算法常量和调用关系可循的小型二进制,AI 能完成一段有证据的定位与标注工作。作者还重新打开同一项目,通过 search_functions_by_name("gz") 找回六个 gz* 名称,验证了结果确实保存下来。
但它没有人工耗时或其他方案的对照,也没交代模型版本。40 秒、$0.28 和四个正确名称,不能直接外推成一般团队的效率收益。这里用的是开源、可事后核对、特征清楚的样本,更复杂的优化代码、混淆程序是否同样有效,原文没有证明。
最有价值的反例是 set_function_prototype:调用成功,反编译结果仍出现 Unknown calling convention。Ghidra 12.1.4 没有很好处理大栈缓冲区触发的 ___chkstk_darwin,参数仍被错误解释。
工具调用成功,只能证明操作被接受,不能证明分析结论正确。
相比复制代码到聊天框,MCP 的优势是上下文连贯、结果可写回;代价是错误名称也会传播到后续分析。原文对本地模型效果较弱的判断没有对照数据,应当视为经验之谈。Ghidra 免费开源,GhidraMCP 使用 Apache-2.0,模型费用另计。
能拿来做什么
- 如果要分析自己有权处理的原生程序,可以先选一个能对照源码的小样本,完成「字符串定位、交叉引用、反编译、标注、核对」的完整练习,再处理陌生文件。
- 在日常 AI 编程中,可以借鉴作者的任务约束:限定工具,要求先解释证据,再改名,并输出地址、旧名、新名和依据,方便逐项复查。
- 保存项目副本并启用
--project;对函数原型、参数和调用约定,必须检查写回后的反编译结果,不能只看成功提示。 - 分析不可信样本时,将代理限制在静态分析工具内。二进制字符串也可能包含提示注入;不要让同一代理同时拥有 shell、邮件或上传能力,敏感代码送往哪个模型也要先确认。