通过移除记忆验证智能体是否改变行为
作者在业务指标归因应用中设计有记忆与无记忆的对照测试,用相同问题观察智能体的工具调用与调查行为。系统预置五种已知根因,并保存确认结论、排除假设和数据源可靠性等信息,但摘录未展示最终测试结果。
AI 深度解读
给 Agent 接上记忆库,究竟改变了什么?WhyDesk 的作者把同一个问题分别在开启、关闭记忆的条件下跑了一遍:答案没变,速度也没变快,但工具调用的顺序和数量变了。
这次实验值得看,是因为作者区分了「记住信息」和「改变工作方式」,也公开了实现里不够漂亮的部分。对正在做 AI 应用的程序员来说,它提供了一种可复用的验证方法:先证明记忆影响了行为,再讨论收益。
同一个问题,记忆改变了哪些工作
WhyDesk 用来调查业务指标下跌。用户可以问:「W13,South 区域的收入为什么下降了 19%?」Agent 随后调用诊断工具,检查节假日、竞品促销、库存、价格和数据管道。
原文说有五个工具,但开头只列出四个:check_holiday_calendar、check_competitor_promos、check_inventory_stockouts、check_pricing_changes。后续代码补出了 check_etl_pipeline。
技术栈是 FastAPI、Groq tool-calling、单页前端和 Hindsight 记忆层,模型回退链从 qwen/qwen3-32b 开始。调查数据是预置的,作者植入了五个已知根因,用来核对答案。
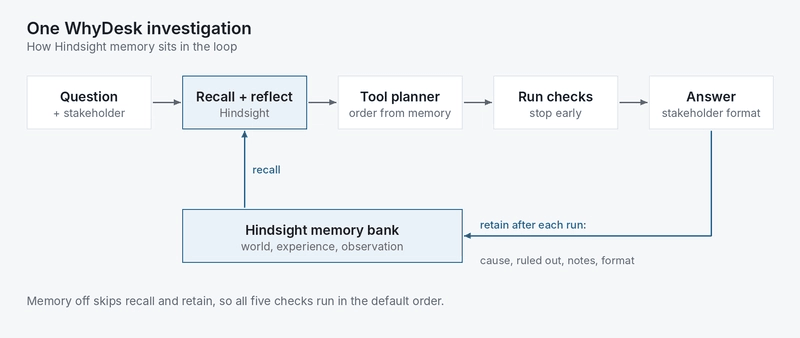
每次调查结束,Agent 都会保存已确认原因、已排除假设、不可靠数据源的说明,以及相关人员偏好的回答格式。
测试时,记忆库已有六条记忆。作者以 Finance Head 为回答对象,对 W13 South 的问题执行两次:一次启用 Hindsight 的 recall 和 reflect,一次关闭记忆。
关闭模式完全无状态,不调用 recall、reflect 或 retain,避免对照运行反过来污染记忆库。
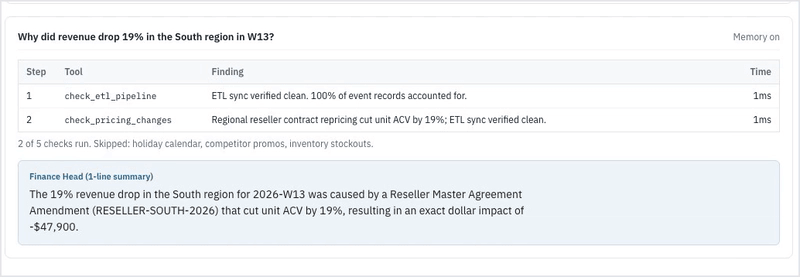
开启记忆后,Agent 根据一条「周一式下跌往往与 ETL 延迟有关」的记录,先查数据管道,再查价格;找到原因后停止,另外三个检查没有执行。ETL 可以理解为把业务数据搬运、加工到分析系统的流程,延迟时可能出现报表暂时少算的情况。
两次运行却给出了相同原因、相同金额,也都采用简短的 Finance Head 摘要。耗时分别是 618 ms 和 600 ms,开启记忆反而略慢。
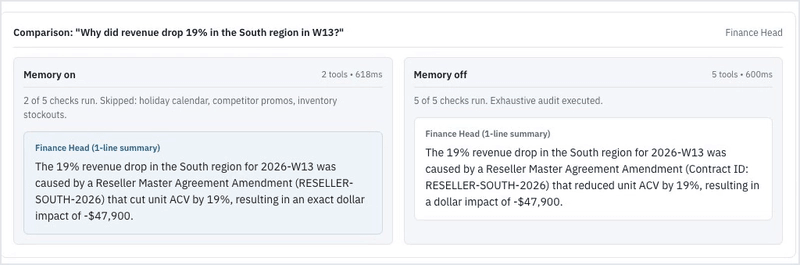
这次实验证明了工作过程发生变化,没有证明答案更准或运行更快。
预置数据都在内存里,检查几乎没有成本,省下的调用抵不过记忆检索和反思的开销。作者预计,真实数仓里的慢查询可能让收益显现,但明确表示没有测过。
工具顺序怎么变,代码比演示更值得看
记忆不会自动变成行动。WhyDesk 在 backend/agent.py 中用下面的函数,把检索到的记忆和反思文本转换为工具优先级:
def derive_tool_order_from_memory(memories: list[dict], reflection: str) -> list[str]:
    combined = " ".join(m.get("text", "") for m in memories) + " " + (reflection or "")
    text = combined.lower()

    if not text.strip():
        return list(DEFAULT_TOOL_ORDER)

    priority_scores = {tool: 0 for tool in DEFAULT_TOOL_ORDER}

    if "etl" in text or "pipeline" in text or "sync" in text or "lag" in text:
        priority_scores["check_etl_pipeline"] += 30
    if "pricing" in text or "discount" in text or "promo code" in text or "repricing" in text:
        priority_scores["check_pricing_changes"] += 20
    if "stockout" in text or "inventory" in text:
        priority_scores["check_inventory_stockouts"] += 15
    if "ruled out" in text and "holiday" in text:
        priority_scores["check_holiday_calendar"] -= 10
    if "ruled out" in text and "competitor" in text:
        priority_scores["check_competitor_promos"] -= 10

    return sorted(
        DEFAULT_TOOL_ORDER,
        key=lambda t: (-priority_scores[t], DEFAULT_TOOL_ORDER.index(t)),
    )
重点看 if "stockout" in text or "inventory" in text::它只判断词是否出现,不理解库存究竟是根因、被排除的假设,还是顺带提到的信息。
规则很明确:管道相关词加 30 分,价格相关词加 20 分,库存相关词加 15 分;同时出现「ruled out」与节假日或竞品词,各减 10 分。同分时沿用默认顺序,空记忆也回到默认顺序。
这段逻辑没有按区域、周次或具体案例写分支,因此行为确实由记忆文本驱动。但它也没有核实历史经验是否适用于当前问题。甚至「ruled out」和「holiday」来自不同记忆,也可能一起触发降权。
作者承认这是薄弱点,计划让模型或小型分类器读取反思、返回工具顺序,再保留当前函数作为回退方案。这个方案尚未验证,也没有证明一定优于现有规则。
还有一个边界:函数只负责排序。找到原因后何时停止、凭什么跳过剩余检查,不能仅靠这段代码判断。
要省掉重复调查,得保存被排除的原因
WhyDesk 保存的内容不只是最后结论。一条典型记录会注明:2026-W11,North 区域确认发生库存缺货,同时排除了节假日和竞品促销。
这样的记录能解释历史上查过什么、为什么没有继续查。只存「收入下降源于缺货」,下一次很难判断哪些检查值得复用,哪些需要重做。
Hindsight 还自动把调查结论归为 observation,把 Finance Head 的格式偏好归为 experience,把周一 ETL 延迟经验归为 world。作者没有手工设计这套分类,并将其视为专用记忆层的价值。
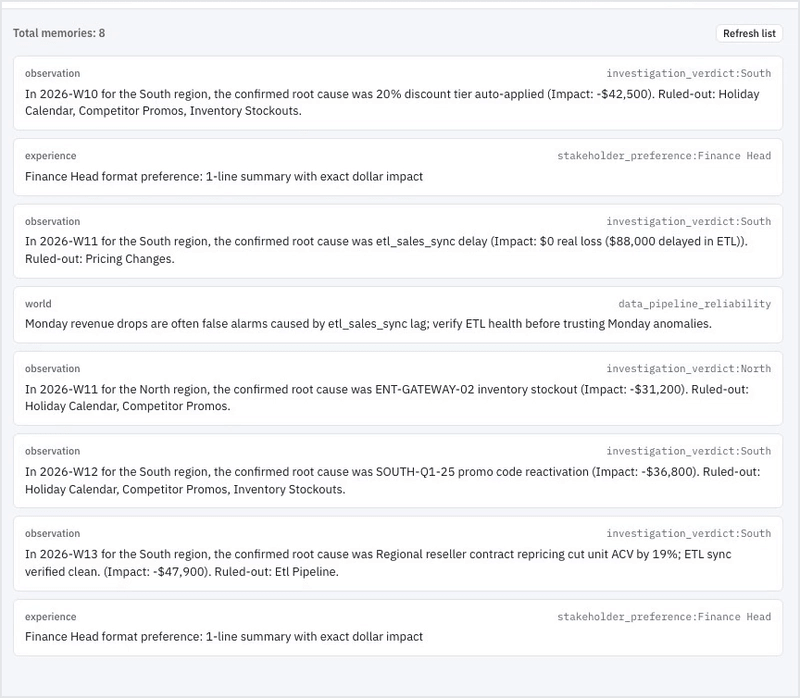
每次运行都同步执行 retain,确保紧接着的问题能看到上一轮经验。异步写入可能还没完成,下一轮就开始了,表现出来便像「忘了」。
但同步保存没有解决重复问题。对照运行后,Finance Head 的格式偏好出现了两份,因为每次重述都会再次保存,仍需要去重。
我的判断
我认同作者的验证方式:同题开关记忆,再观察工具轨迹,比展示一段带历史信息的回答更有说服力。把正确率、耗时和检查数量分别报告,也避免了把过程变化包装成全面提升。
局限同样清楚。这是五个预置根因上的机制验证,不能推导真实业务准确率。历史上排除过某个原因,也不代表换个区域、周次仍可排除;跳过检查需要适用条件。
专用记忆层自动分类确实方便,但作者没有提供与普通向量库的对照数据。它是否更省维护成本、检索是否更可靠,目前仍是经验判断。
规则排序容易检查,模型排序可能更能理解语义,却会引入额外调用和错误。当前最值得保留的,是让排序决策可追溯,并用工具输出核对最终答案里的每个金额。
能拿来做什么
- 给现有 Agent 加一个同题对照入口,记录工具顺序、调用数量、最终结论和耗时,并确保关闭模式不读写记忆。
- 在调查类应用中,把已排除假设与区域、时间等适用条件一起保存,避免把一次调查结论当成通用规律。
- 如果你的 Node 服务连接真实数据库,就用实际查询耗时评估收益,同时计入
recall、reflect和同步retain的成本。 - 给记忆检查界面展示分类、来源和重复记录,并核对回答中的数字是否来自工具输出,让调试有据可查。