DeepSeek 别名更新后的智能体迁移检查
文章指出,DeepSeek V4.1 Flash 1017 更新可能在接口与价格不变的情况下,因默认开启高强度推理而改变成本和延迟。迁移检查聚焦显式设置推理参数、完整回传助手消息,以及排查工具循环第二轮报错。
AI 深度解读
模型接口没变,名称没变,价格也没变,Agent 的行为却可能已经变了。原文围绕 DeepSeek V4.1 Flash 1017 给出了一份迁移检查单:先固定思考参数、修好工具调用消息,再谈升级收益。
对维护 AI 编程流水线的开发者,这篇最有用的提醒是:模型别名稳定,不代表行为稳定。不过,作者自己的测试经过第三方中转,无法确认背后的权重就是 1017,阅读时必须把官方约定、个人实测和转述数据分开。
没改代码,为什么也需要做迁移检查
原文称,DeepSeek 在 2026 年 10 月 17 日将 deepseek-flash 别名指向 V4.1-Flash-1017。已有调用可以继续成功,因此错误日志未必能提醒你发生了变化。
关键在默认参数:思考模式默认开启,reasoning_effort 默认为 high。原来没有显式设置 thinking 的流水线,会直接继承这个行为。
有效的思考档位只有 low、high、max。兼容名称的映射也要记清:
minimal映射到low。medium、high、xhigh都映射到high。max、ultra都映射到max。
所以,把 medium 和 high 当成两组实验,没有比较价值。low 也不等于关闭;关闭需要显式设置 thinking 为 {"type":"disabled"}。
作者通过 Crazyrouter 的 OpenAI-compatible 接口,调用 deepseek-v4.1-flash 做了 18 次不带 thinking 的请求,其中 17 次返回了 reasoning_content。low、high、max 均能正常响应,不存在的档位返回 400。
这支持了「别依赖默认值」的建议,但不能证明 1017 的表现。作者最后明确承认,中转平台没有标注具体权重版本。
工具调用和输出校验,哪里最容易出问题
工具调用最容易踩坑的地方,是下一轮请求漏掉 reasoning_content。
按原文引用的官方约定,请求携带 tools 时,后续请求必须完整回传该字段,否则会返回 400。使用 OpenAI SDK 时,作者建议保留整个 response.choices[0].message 并追加到历史消息,而不是自己拼一个只有 content 和 tool_calls 的对象。
对维护 Node Agent 的团队,这类问题很可能出在消息转换层:为了统一不同供应商的格式,封装代码只保留熟悉的字段,把推理内容过滤掉了。
作者也做了反例测试:在 Crazyrouter 上故意省略第二轮的 reasoning_content,依然拿到了正常回答。它只能说明这个中转在该次测试中允许省略,不能据此推断官方接口也允许。
另一个变化是采样参数。原文称,思考模式下,temperature、presence_penalty、frequency_penalty 会被接受,但不会生效;仍起作用的 top_p 只支持 0.95–1.0。
如果输出必须符合结构要求,保证应放在解析和校验层。
例如让模型提取字段,返回后就解析 JSON、检查 schema,失败再重试。原先依赖 temperature=0 稳定格式的代码,需要重新检查。原文转述过一个写作任务:开启思考后重复 5 次,只有 2 次满足 emoji、标签数量和字数限制;作者没有独立复现,这只能当排查线索。
接入路径也要核对。原文称,官方 Anthropic-compatible 端点会将以 claude-opus 开头的模型名映射到 V4 Pro,并按它计费,除非显式配置模型变量。检查调用代码之外,还得到用量明细确认实际计费模型。
思考开得更高,前端页面能好多少
作者用相同的一句话提示词,分别关闭、开启思考,生成了三组单文件页面:
| 任务 | 关闭思考 | 开启思考 |
|---|---|---|
| 赛车页面 | 7,704 tokens,39.6 秒 | 21,155 tokens,100.2 秒,首 token 48.8 秒 |
| 仪表盘页面 | 6,514 tokens,28.1 秒 | 27,050 tokens,163.8 秒,首 token 127.8 秒 |
| 森林到城市的 3D 场景 | 6,599 tokens,31.2 秒 | 20,554 tokens,137.1 秒,首 token 116.2 秒 |
开启思考后的输出 token 是关闭时的 2.7–4.2 倍,等待时间也明显增加。作者观察到的收益主要是页面结构和交互变化。
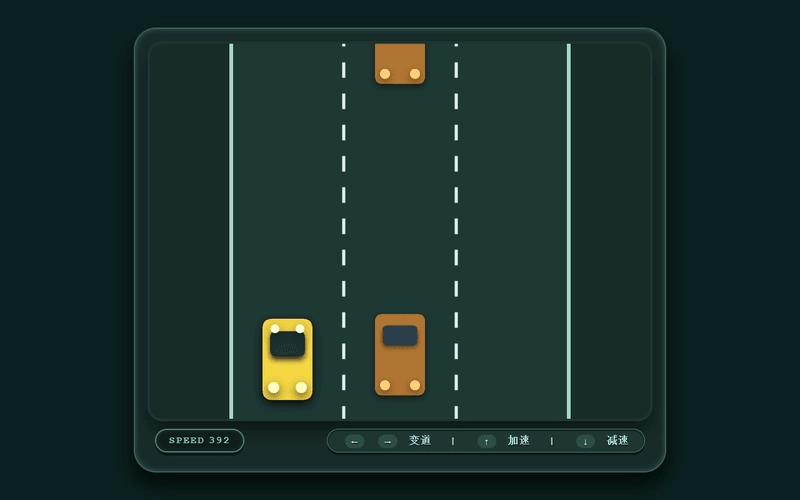
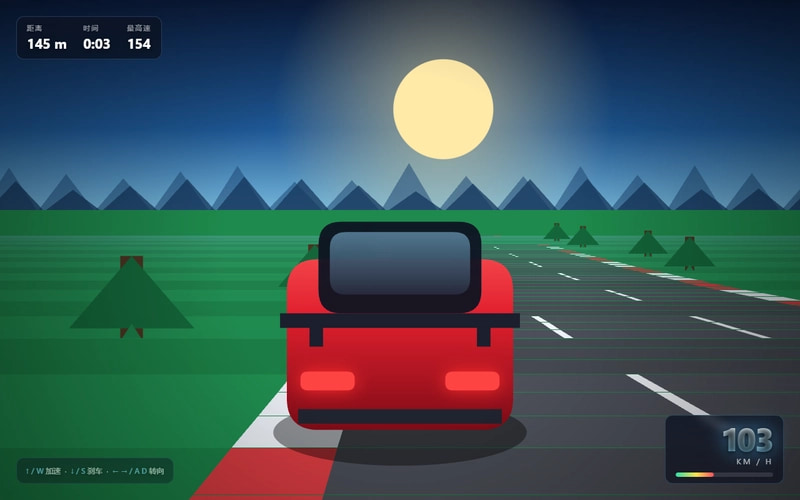
赛车从平面俯视赛道变成带夕阳和速度表的车后视角道路。仪表盘去掉 chart.js、echarts、FontAwesome、Google Fonts 四项外部依赖,改用内联 SVG。3D 场景增加时间轴和播放、暂停控制,约 24 秒从森林演变为亮灯的城市。
六个页面都能打开,控制台没有报错;两个 3D 页面都需要联网加载 three.js,不能把这个差异归到思考模式上。
这些结果说明额外计算可能换来更完整的实现,但还不足以评判代码的可维护性、可访问性或需求完成率。每类任务只有一组开关对照,也没有证明结果能稳定重复。
跑分差异,可能来自模型外面的执行框架
原文引用的 Bug Hunt Bench,在两个真实仓库里植入 105 个 bug,通过 Claude Code 单轮查找、修复,使用隐藏答案评分,每个配置采样 5–7 次。
作者强调,不能只看不同思考档位相差 4.7 个修复数。基准作者最初三次 max 运行分别得到 34、37、45,单一配置内部的波动,已经超过档位之间的差距。提供的原文没有包含完整档位表,无法补出各档成绩和成本。
官方建议是简单任务用 low,日常 Agent 工作用 high,复杂任务用 max。但 9 月发布说明里的代码 Agent 基准采用 max、top_p 0.95、temperature 1.0;1017 更新记录没有重申档位。作者推测,这可能解释日常 high 与宣传成绩的差距,尚不能视为已证实的原因。
执行框架,也就是负责安排工具、循环和子 Agent 的那层程序,同样会改写结果:
| 执行框架 | 修复数 / 105 | 相对 Claude Code 成本 | 耗时 |
|---|---|---|---|
| DeepSeek Harness | 42.7 | 约 1.8× | 62 分钟 |
| Pi | 42.2 | 约 0.8× | 54 分钟 |
| Claude Code | 39.1 | 1× | 58 分钟 |
| OpenCode | 37.6 | 约 0.95× | 56 分钟 |
旧版 V4.1 Flash 在 Claude Code 中为 21.7、约 0.77× 成本、56 分钟。同框架下升到 39.1,是比较有参考价值的升级信号。DeepSeek Harness 分数最高,但会启动子 Agent、产生更多 token,账单也最高。
Terminal-Bench 4.0 同样如此:DeepSeek 使用 Claude Code 得到 42.3,Vals AI 使用只提供 bash 的 mini-swe-agent 得到 31.82。不能把它们直接当成模型能力的横向排名。
我的判断
这份清单最可靠的部分,是把迁移落实到显式参数、完整消息、输出校验和计费核对。它们比「换个模型名试试」更适合已有流水线。
但它并没有完成对 1017 的严格验证。作者实测使用的地址是:
https://api.crazyrouter.com/v1
需要同时核对模型名 deepseek-v4.1-flash,以及平台是否说明具体权重版本;原文这次没有得到后者。个人页面实验只能限定为「这个中转、这个模型名、这一周」的观察。
其他转述也应保留问号:V4 Pro 在同一 Bug Hunt 数据中修复 16 个,1017 为 39.1;新版本可能更保守,遇到有成本的步骤会跳过;另有开发者遇到总输出从 227k 增至 456k,因为模型不断截图和迭代。这些都没有被作者独立复现。
我赞同按任务配置思考预算,但不把开启思考当成默认升级方案。
相比统一开启 high,按任务分流更容易控制延迟和费用;相比只换执行框架,先在现有框架里固定参数重跑,更容易判断收益来自哪里。具体选哪档,仍要靠自己的重复测量。
能拿来做什么
- 给现有流水线的每次调用显式设置
thinking,先将分类、提取、格式转换等短任务关闭思考,再单独评估复杂编程任务的high与max。 - 检查 Node 工具调用封装,确认助手消息中的
reasoning_content没有被过滤,并用一次完整的工具调用往返验证消息链路。 - 给 JSON、字段提取等任务补齐解析、schema 校验和失败重试,不再把
temperature=0当作格式保证。 - 每条流水线挑一个真实任务重复运行,记录完成率、总 token、首 token 时间、总耗时和计费模型;前端生成任务还要检查交互是否完成,不能只看页面能否打开。