八卡 B200 实测:两款推理引擎各有取舍
作者通过轻量服务项目将 DeepInfer 接入 GPUStack,在八卡 B200 上以相同 DP8+EP8 配置对比 vLLM。该轮测试中 DeepInfer 输出吞吐更高、词元间延迟更短,而 vLLM 首词元延迟与 P95 请求延迟更低。
AI 深度解读
同样是 8 张 NVIDIA B200,DeepInfer 和 vLLM 谁更快?作者这轮测试没有给出单一赢家:DeepInfer-server 的输出吞吐更高、连续生成更快,vLLM 则更早吐出第一个 token,P95 请求延迟也更低。
比胜负更有参考价值的是,他们把偏离线的推理引擎接成了可调用的服务,再放到同一平台比较。对准备自部署模型的团队,这篇值得看的地方是部署链路和指标取舍,而不是一张性能排名。
推理引擎开源了,为什么还要补一层服务
DeepInfer 是 DeepSeek 开源的高性能推理框架,原文所述公开版本支持 DeepSeek-V4.1-Flash,集成了 FlashMLA、DeepGEMM、DeepEP、DeepSelect,也支持多种并行策略、推测解码和异步调度。这些能力分别处理计算、GPU 间通信与任务调度,目的是让硬件更有效地完成推理。
但应用需要的不只是一个能生成 token 的引擎。
DeepInfer 当前公开入口主要面向离线推理。想像运行 vllm serve 那样启动在线服务,还得补上 HTTP 接口、请求分发、流式响应、取消、超时和健康检查。
deepseek-recipe 负责协议转换和编解码:把 API 请求、对话格式、模型 token 序列和输出结果衔接起来。它并不提供模型推理和 HTTP 传输。把它与 DeepInfer 装进同一个容器,也不会自动得到完整服务。
作者因此开发了 DeepInfer-server:接收 OpenAI-compatible Chat Completions 请求,经 deepseek-recipe 转换后调用 DeepInfer,再返回文本、推理内容或工具调用,支持 JSON、SSE 流式响应和 token 用量统计。它还负责推理进程初始化、请求调度及生命周期管理。
GPUStack 则管理部署:根据自定义后端配置,传入模型路径、端口和 GPU 参数,启动并监控服务。
引擎能跑,与应用能稳定调用,中间还有一层明确的工程工作。
这个包装层目前聚焦单节点、多 GPU 文本推理,是独立的集成验证项目。它没有复现 DeepSeek 完整的 KV-cache 管理、预填充与解码分离架构或负载均衡,不能等同于官方在线服务。
同样写着 DP8+EP8,部署时仍有哪些坑
作者使用单台服务器上的 8 张 NVIDIA B200,模型权重为:
deepseek-ai/DeepSeek-V4.1-Flash-1017
这里要看清完整的权重标识,后面的比较都建立在两边使用相同权重的前提上。
部署入口是 gpustack-deepinfer-server-backend.yaml。将它导入 GPUStack 自定义推理后端后,平台就能读取容器镜像、启动命令、默认参数、环境变量、健康检查路径和 JIT 缓存目录,并在部署时填入模型路径、服务端口、模型名称及 GPU 数量。
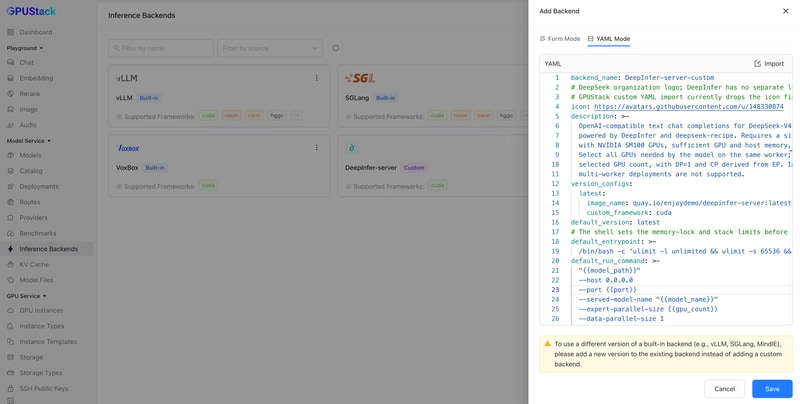
真正容易漏掉的是并行参数。为了与测试一致,作者显式设置了 --expert-parallel-size=8、--data-parallel-size=8、--context-parallel-size=1,覆盖 YAML 中 DP=1 的默认值。
EP、DP、CP 分别指专家并行、数据并行和上下文并行。当前包装层要求 DP × CP = EP。这次 CP=1,表示不把上下文拆到多张 GPU 上。max-num-seqs=16 是每个 DP rank 的序列上限,所以 DP8 服务的总准入上限为 128 条序列。它与后面压测的 16 并发不是同一个参数。
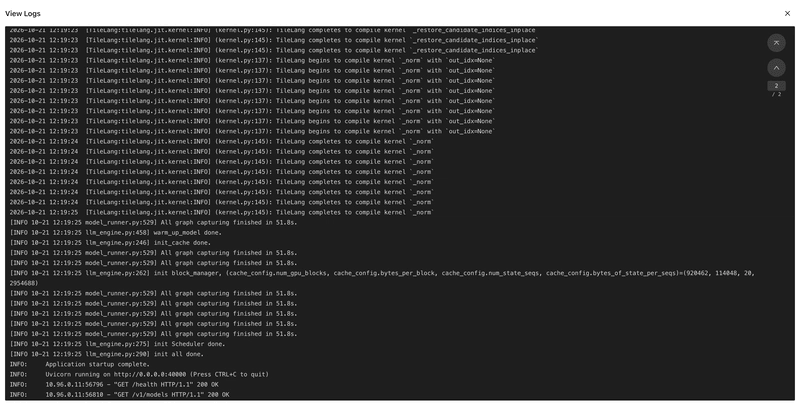
硬件环境也不能直接照抄。完整权重、镜像、兼容的驱动和容器运行时、足够的主机内存都要准备好;RDMA 设备、网卡与网络参数则需要按服务器调整。首次启动还可能编译和预热内核,持久化 JIT 缓存有助于复用编译结果。
吞吐更高,为什么用户还可能觉得更慢
这轮比较统一了硬件和权重,但没有把两套引擎都调到最优。DeepInfer 使用 CP1、DP8、EP8;vLLM 使用 TP1、DP8、EP8。作者这样设置,是因为公开版 DeepInfer 没有提供与 vLLM 张量并行对应的 TP 路径。
并行规模接近,也不代表执行过程相同。两边的内核、通信路径、Engram 访问和调度器实现仍有差异,DeepInfer-server 的请求协调与协议处理开销也计入端到端结果。
正式压测通过 GPUStack Benchmark 发出 100 个请求,目标并发为 16,采用 Random 数据集,输入长度 8K、输出长度 1K。结果呈现了两种不同的优势:
| 指标 | DeepInfer-server 相对 vLLM 的结果 |
|---|---|
| 平均输出吞吐 | 约高 25.2% |
| 平均 token 间延迟 ITL | 约低 27.0% |
| 平均端到端请求延迟 | 约低 7.5% |
| 平均首 token 时间 TTFT | 4.28 秒,对比 2.04 秒,约为 2.09 倍 |
| P95 请求延迟 | 25.46 秒,对比 20.03 秒,约高 27.1% |
TTFT 衡量发出请求后多久开始有输出;ITL 衡量开始输出后,相邻 token 之间要等多久;P95 请求延迟则帮助观察较慢那部分请求的等待时间。
因此,DeepInfer-server 可以在连续生成和平均完成时间上占优,同时让用户在开头等得更久,部分慢请求也更慢。这几个结果并不矛盾。
作者还明确区分了统计口径:输出吞吐来自报告的 output_tokens_per_second_mean,保留报告的均值,不能直接当作整轮总输出量除以总耗时。其他指标来自 time_to_first_token_*、inter_token_latency_*、request_latency_*,其中 TTFT 从毫秒换算为秒;ITL 没有与 time_per_output_token 或 SSE 分块间隔混用。提供的正文没有列出吞吐绝对值,不宜自行补算。
Playground 单次聊天截图中的 vLLM 约 91.4 tokens/s、DeepInfer 约 106.2 tokens/s,也不能与并发吞吐直接比较。提示词、上下文、回答长度及界面计时方式都会影响它。
这轮结果支持按负载选引擎,还不足以支持给引擎排总榜。
我的判断
我认可作者把「服务接起来」和「性能测出来」放在一起讲。对自部署团队,HTTP、协议转换、取消、超时和健康检查都直接影响可用性。通过自定义后端复用 GPUStack 的部署流程,也提供了一个可参考的接入路径。
性能结论需要收窄。作者给出了同机、同权重、相近并行规模下的对照数据,但只有两次具体运行的结果,没有展示多轮重复测试及波动范围,也没有覆盖不同输入长度、输出长度和并发水平。这是初步实测,尚不能证明稳定优势。
两边都完成了 100 个请求,只能证明这次负载下服务可用;Random 数据集也没有评估回答质量。原文没有给出成本对照,不能从吞吐增幅继续推导实际节省了多少费用。
与继续使用已经跑通的 vLLM 相比,DeepInfer-server 更适合作为候选方案验证。在线聊天可以优先关注 TTFT 和 P95,批量生成可以更关注吞吐,但都需要带上自己的请求分布重新测试。
后续能力也有边界。按原文转述,DeepSeek 的 KV-cache 管理和负载均衡组件与内部基础设施耦合较深,尚未完全开源。未来组件的范围和时间仍应以官方公布为准。
能拿来做什么
- 如果前端或 Node 应用已经通过 Chat Completions 接入模型,可以把 DeepInfer-server 作为候选后端,验证流式文本、推理内容、工具调用、取消和超时是否符合现有调用逻辑。
- 给聊天或 AI 编程界面选推理服务时,同时记录 TTFT、ITL 和 P95 请求延迟,让「多久开始回答」与「回答时是否顺畅」都有数据依据。
- 复现部署时,先核对最终生效的并行参数,确认 DP=1 默认值已被覆盖,并区分每个 DP rank 的序列上限和压测并发数。
- 评估替换现有引擎前,用固定提示词和真实长度分布做多轮测试,再调整并发;若结果波动较大,继续拆分服务包装层与引擎执行的耗时。