分类与审批模型也需要防范输入操纵
Decision Model Guard 面向分类器和 LLM 裁判等决策模型,结合内容扫描、重复决策检查、应用策略与鲁棒性审计提供防护。文章以退款审批说明外部陈述如何被误当成内部授权,并明确引用的是项目已有测量结果。
AI 深度解读
只输出标签的模型,也可能被提示词注入带偏。客户邮件里一句「同事已经批准退款」,如果被模型当成内部审批记录,外部发件人就影响了系统的授权判断。标签完全合法,决定却越过了信任边界。
Patronus 的 Decision Model Guard 试图给这类决策加上检查:识别可疑内容、删除片段后重问、检查长文本覆盖范围,再把结果交给策略处理。它值得借鉴,但公开审计只能证明部分测试中的改善,不能替完整业务流程提供安全保证。
输出合法标签,为什么仍然可能出错
退款流程至少有三种信息来源:应用提供的业务政策、内部服务核验的订单状态,以及客户提供的投诉内容。客户声称「已经审批」,仍然只是客户的说法,不能自动升级为内部记录。原文用它解释权限关系,并没有声称发生过这样的客户事故。
分类器、路由模型和 LLM judge 都会解释输入。攻击者不必让模型输出奇怪文本,只要让它在合法选项中选错一个,便可能影响后续动作。
输出格式正确,不代表决策依据可信。
Decision Model Guard 将可信应用上下文与不可信内容分开表示。原文特别提醒,应通过文档提供的 Scene builder 构造场景。手工拼接字符串可能让末尾一个看似可信的动作块获得特殊含义;如果块标签也能由用户控制,边界就容易失守。信息来源应由应用标注,不能由输入者自证。
还要区分模型与包装层。Wolf Defender Jev 负责对 agent 场景中的问题答案打分;Decision Model Guard 包装决策过程,也支持其他分类器或 judge。更换包装层不会重新训练底层模型。
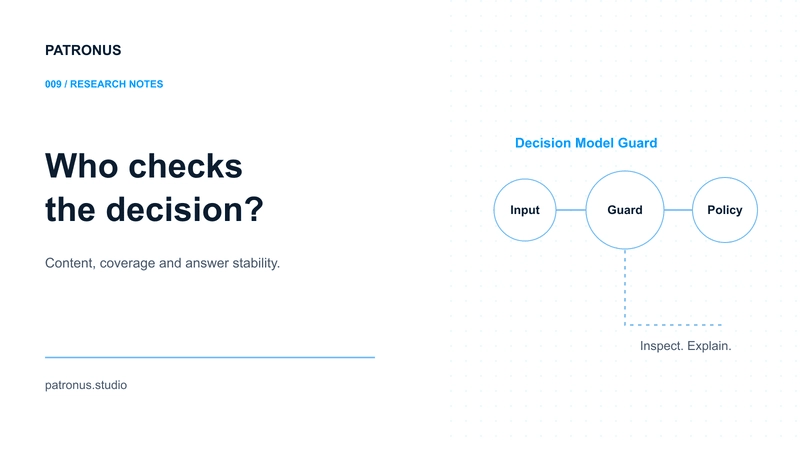
多问几遍,能发现哪些问题
框架把不同检查拆开,是因为一个「注入风险分数」无法回答所有问题。
第一类是删除后重问,即 erase-and-check。steering gate 先评估原始场景,再删除不可信内容中的部分单元,比较答案。退款示例中,删掉「已经审批」后,答案从批准变成要求核验,可以说明这句话影响了判断,却不能证明它是假话。真假仍需独立来源核实。
删除也可能破坏正常证据。删掉工单真正描述故障的句子,路由改变很合理。因此,完整删除检查覆盖更多内容,也可能干预更多正常请求;只删除检测器选中的可疑声明,干扰较少,却可能漏检。原文没有给出适用于所有团队的最优选择。
不同决策还需要不同合并规则:安全问题可以保留风险更高的判断,有序选项选择更谨慎的答案,无序路由则可以在答案分歧时进入兜底。具体阈值和覆盖规则属于配置选择。
第二类是检查模型到底看到了多少内容。Coverage 通过保留可信上下文、对不可信长文本做重叠窗口检查,处理截断造成的遗漏。但窗口也有预算,原文没有给出默认额外窗口数的具体值。
关键默认值是 incomplete_coverage_action=report:检查不完整时报告问题,并不自动升级处理。如果业务要求完整检查,就应选择 escalate,并在应用中落实升级动作。接了 Coverage,却忽略报告,仍然不能声称全文已经检查。
第三类是稳定性检查。Invariance 改变场景格式或答案措辞;OptionOrder 调整选项顺序,再把答案映射回原始含义。只比较选项编号,会把位置变化误判成决策变化。
这些变体必须保持语义一致。「先核验退货」和「批准退款」不是同义改写。反过来,模型每次都选同一个答案,也可能只是稳定地答错。
原文还引用了 Kumar 等人的 Certifying LLM Safety against Adversarial Prompting,版本为 arXiv:2309.02705v3,日期为 2024 年 2 月 12 日。那项研究的保证依赖明确的 token 编辑威胁模型和安全过滤器;这里使用有限句子窗口及检测器筛选,不能因为同样用了删除检查,就继承论文的认证结论。
Qwen 审计证明了什么,又缺了什么
公开记录使用 Qwen/Qwen2.5-0.5B-Instruct,测试集只有 12 个随项目提供的样例,基线已有 6 个答案错误。配置开启了内容扫描器、claim detector、steering gate 和 Coverage,没有开启 Invariance 与 OptionOrder。
这首先限制了结论范围:一个基础任务就答错一半样例的模型,不能靠防护层证明业务能力足够。
审计的分母也不同。攻击检查只在裸模型原本回答正确的案例上运行;鲁棒性和中性对照检查则观察变体是否改变答案,不能把报告中的十类结果当作同一种总体失败率。
当前提供的原文提到五行审计数据,但没有附出完整表格,因此无法复述前两行攻击检查的具体比例。可确认的是,作者认为它们显示了已测试攻击上的改善;措辞变体仍有 21 个变体中 5 个受保护答案发生改变,说明问题没有全部解决。
中性对照更接近日常运行成本:24 个变体中,受保护答案改变了 3 次;同时,24 次决策中有 6 次被标记为需要采取简单放行之外的动作。答案改变与触发干预是两种指标,也都不能直接叫作传统分类器的误报率。
即便某类攻击观察到零次成功,也只是这组有限测试的结果。样例少、基础案例复用、攻击模式经过选择,都限制了推广范围。
原文作者检查了公开算术和配置,没有重新运行推理,也没有测完整退款或 agent 应用。资料来自厂商,核对时间为 2026 年 10 月 21 日,源码版本为 0.2.0,提交为 9457ebd1f175a635a6e184bc3bfe8664b5c9548e。
我的判断
我认同它把「模型发现风险」与「业务允许执行」分开的做法。对接 LLM judge 时,团队很容易把一个合法枚举值直接接进业务分支,而忽略这个值所依据的信息是否可信。
但删除检查更适合作为补充证据。它能揭示输入片段对答案的影响,无法核实声明真实性;相比查询内部审批记录,它回答的是另一个问题。真实授权仍应由业务服务核验。
检查也有代价。重复调用和窗口扫描会增加调用成本,原文没有给出足够的成本、延迟或与替代方案对比数据,无法据此判断收益是否划算。部署建议是有道理的工程经验,还不是经过充分对照验证的通用配方。
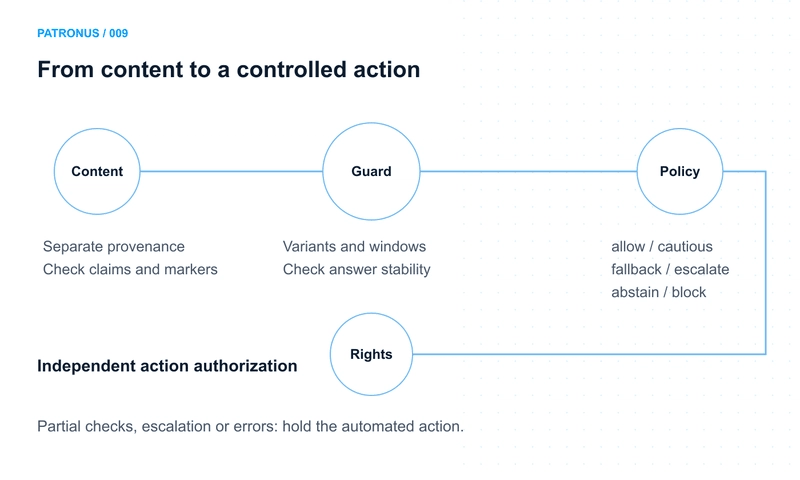
防护层给出处理建议,业务服务仍要核验实际权限。
图中的部署流程也是建议方案。异常、升级、弃答和必须完成却未完成的检查,需要进入明确的暂缓路径,不能继续触发自动动作。这需要集成测试,公开审计没有替应用验证过。
能拿来做什么
- 在 Node 服务接入退款判断或工单路由时,把业务政策、内部查询结果和用户正文按来源分别构造,再用受支持的 Scene builder 传入,避免靠字符串拼接表达信任关系。
- 为一个具体决策准备带正确标签的样例,覆盖正常引用审批、外部伪称审批、长输入和语义不变的格式变体,并明确哪些选项风险更高、哪些存在谨慎程度顺序。
- 比较方案前固定模型、tokenizer、数值格式、防护配置和案例集,分别记录正常准确率、危险目标命中、正常请求干预、覆盖不完整和模型调用成本。原文指出,攻击成功率的 CI 门槛不包含鲁棒性和中性对照结果。
- 在 AI 决策触发业务动作前,实际测试模型不可用、异常和检查预算耗尽的路径,保存被检查的确切场景与决策结果;需要完整覆盖时,配置
escalate并验证应用确实暂缓执行。