Datasette 插件支持接入本地大模型
datasette-llm 0.1a11 新增 OpenAI 兼容接口支持,可连接 LM Studio、Ollama 或 llama.cpp 等模型服务。文章给出通过 uvx 启动 Datasette Agent 并配置本地模型的命令示例。
AI 深度解读
Datasette 接入本地模型,少了一道适配门槛。Simon Willison 发布的 datasette-llm 0.1a11 增加了 OpenAI-compatible endpoints 支持:只要模型服务提供兼容接口,就能配置给其他 Datasette 插件使用。
作者展示的用法是,让本机模型驱动 Datasette Agent,通过对话查询数据库。对想做本地数据问答的程序员,这篇短文提供了一份可直接参考的启动配置,但没有证明不同模型的效果都一样。
新版本打通的是哪一层
datasette-llm 是 Datasette 的中间插件,负责配置模型,供其他插件调用。它与 datasette-agent 分工不同:前者解决「模型接到哪里」,后者在示例里提供对话和数据库查询能力。
0.1a11 新增的能力,是允许配置 OpenAI-compatible endpoints,也就是采用兼容 OpenAI 请求方式的服务地址。模型可以部署在本机,也可以放在其他位置,前提是接口兼容。
作者把这套接口称为 OpenAI「准标准」网络协议。这个措辞很贴切:大家沿用相似的接口约定,降低接入成本,但不能据此认定每家实现的行为完全一致。
原文列出了 LM Studio、Ollama 和 llama.cpp,并提到 llama.cpp 刚到 v1.0.0。不过,实际给出的配置指向 LM Studio;另外两种服务的配置细节没有展开。
怎样让本地模型查数据库
下面这段命令先下载示例数据库,再通过 uvx 启动带有 datasette-agent 的 Datasette,并指定模型配置:
wget https://datasette.io/content.db

uvx --with datasette-agent datasette \
  --root --secret 1 \
  -s plugins.datasette-llm.default_model '{
    "model": "lmstudio-qwen",
    "model_name": "qwen/qwen3.8-27b",
    "api_base": "http://localhost:1234/v1"
  }' content.db
要先看 api_base 这一行:它指向本机 1234 端口的 /v1 接口,因此运行命令前,需要已有可用的模型服务。命令本身没有包含模型下载或服务启动步骤。
配置中的 model 是 lmstudio-qwen,截图里也用它标识当前模型;model_name 则填写 qwen/qwen3.8-27b。换成自己的服务时,需要核对服务地址和模型名称。--root --secret 1 也属于原文示例参数,不宜未经检查就照搬到共享环境。
作者展示的查询是:数据库里有多少个仓库、多少条发布记录。界面先出现 list_databases_and_tables 工具调用,再通过 sql_query 执行计数查询,返回 repo_count 为 200、release_count 为 1889。
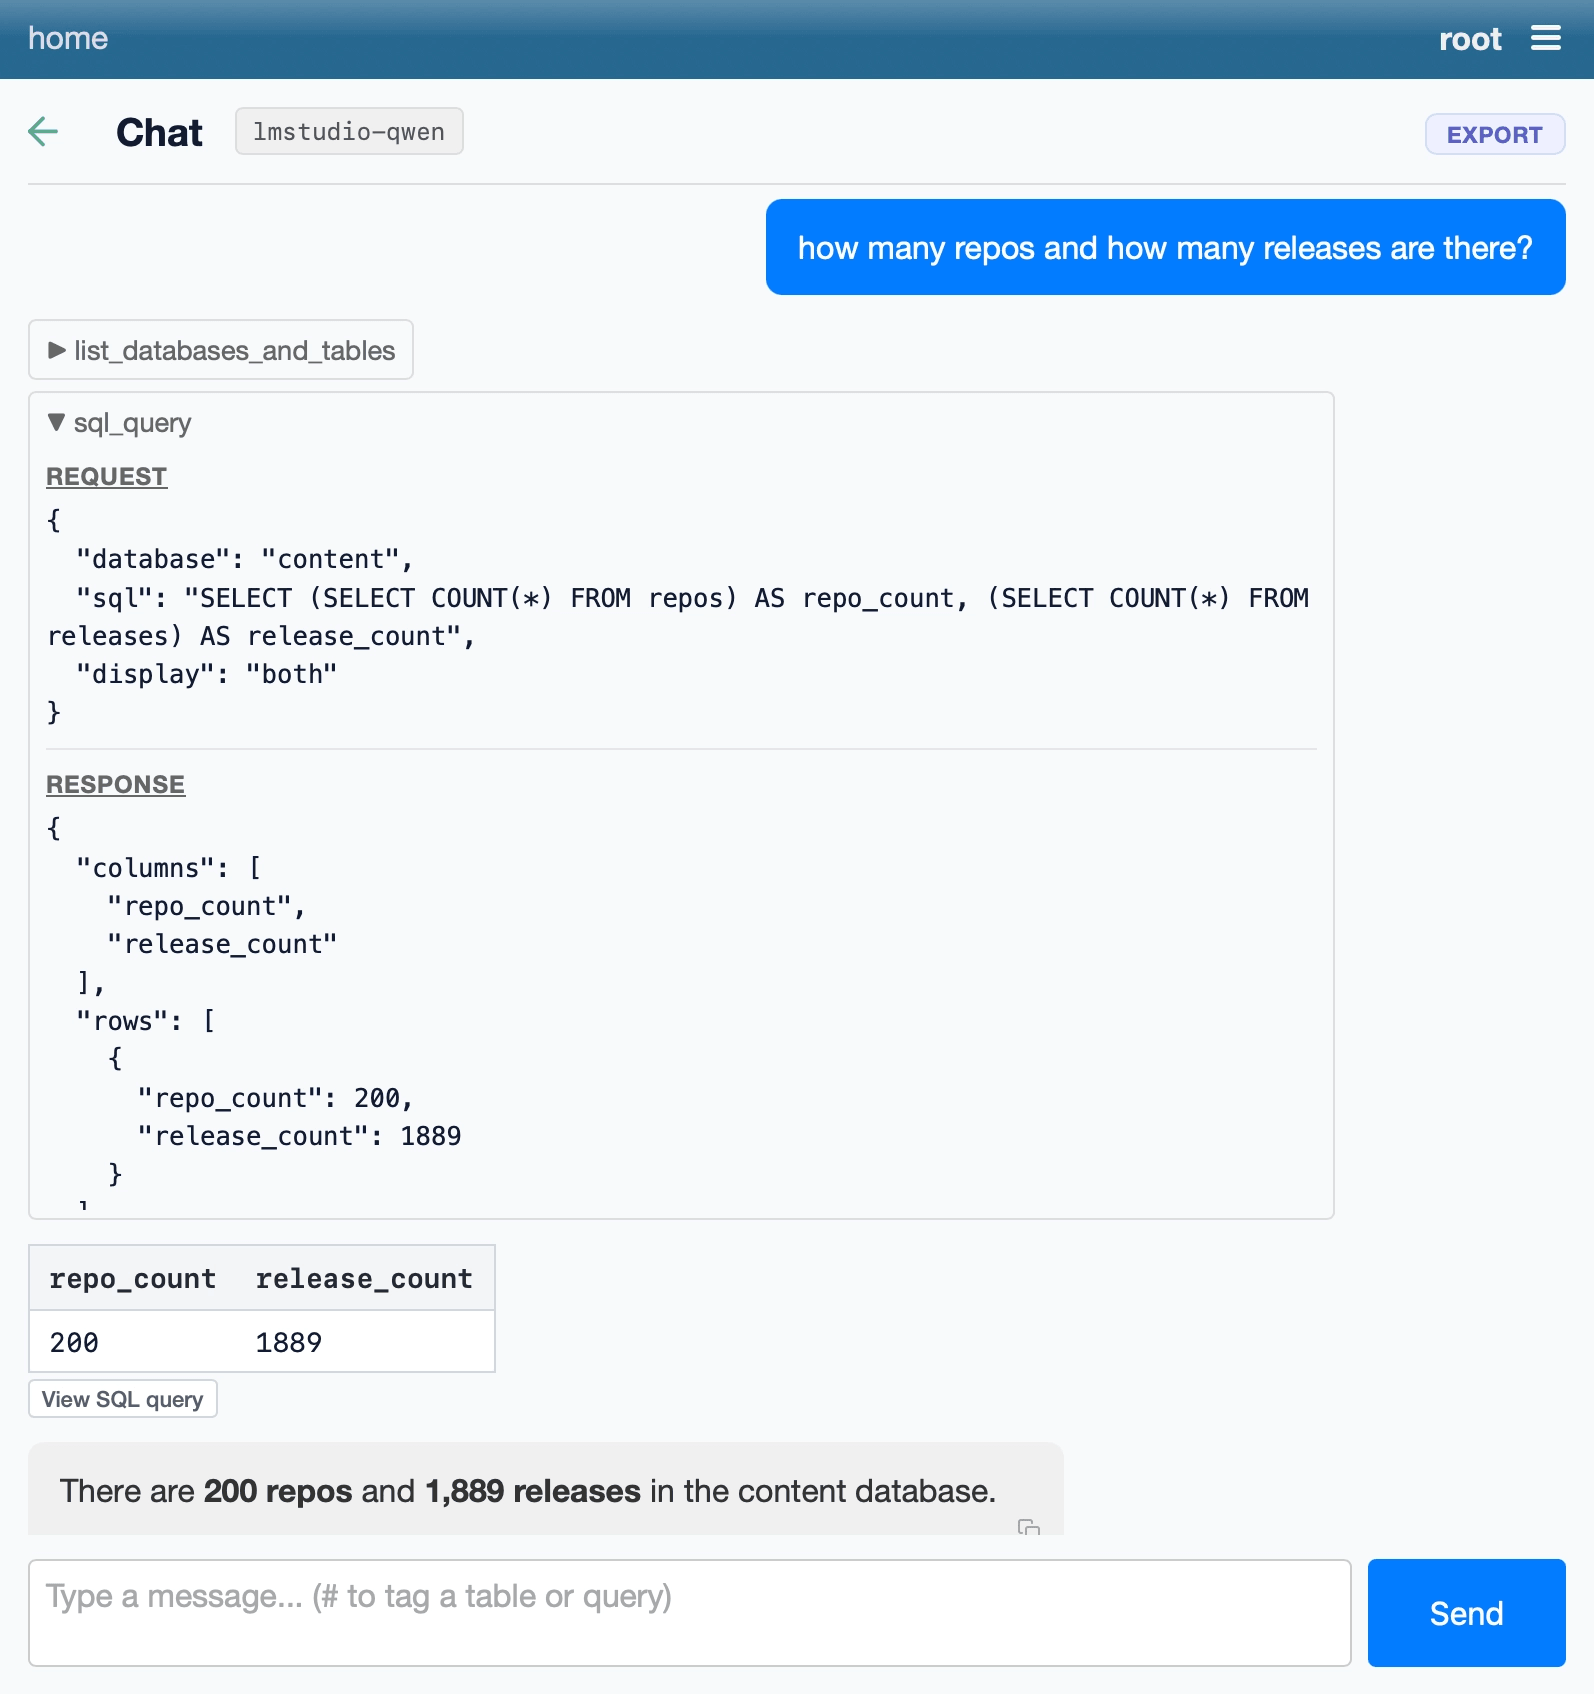
这张图展示了一个有用的过程:回答前有工具调用,调用里有 SQL,返回值也能查看。读者可以沿着查询过程检查答案,而不必只相信最后一句自然语言回复。
示例证明的是这条配置下的一次查询能够完成,不能据此推断所有兼容端点都能稳定执行同类任务。
我的判断
我认同这种把模型配置集中到中间插件的做法。与让每个 Datasette 插件分别处理模型连接相比,它有利于复用配置,也给尝试本地模型留出了入口。不过,原文没有提供维护成本或接入效率的对照数据,这部分属于架构判断。
实际效果还要分开看。接口能接通,只解决了连接问题;模型能否正确选择工具、理解表结构、写出 SQL,需要继续验证。作者展示的是计数查询,没有提供复杂查询准确率、响应耗时、硬件配置或资源占用数据,也没有与云端模型比较。
因此,这次更新更适合被理解为「接入选择增加了」。它给出了可操作的起点,但还不足以回答本地方案是否更快、更省,或者适不适合某个团队。
能拿来做什么
- 如果你已经使用 Datasette 管理 SQLite 数据,可以参考这份命令接入本地模型,先用记录计数等容易人工核对的问题验证完整流程。
- 更换 LM Studio、Ollama 或 llama.cpp 服务时,先核对
api_base、model_name和工具调用表现,再测试真实业务问题。 - 评估数据问答效果时,同时检查生成的 SQL、工具返回值和最终回答;逐步加入多表关联、筛选条件等查询,明确模型在哪些问题上可靠。