八卡 H100 的云租赁与自建成本账
作者按 AWS 按需报价、自建采购价、三年折旧及机房和能耗成本估算,八卡 H100 节点的成本平衡利用率约为 25.7%。测算未计入税费、出站流量、融资和额外互联等成本。
AI 深度解读
一台八卡 H100 节点,一年要有多少时间在干活,才比按需租用便宜?作者算出的临界点是 25.7%。换成二手八卡 A100 40 GB,临界点是 21.5%。这两个数字来自一套有明确假设的成本模型。对做 AI 应用的团队,更有用的是这套算法能把实验、线上推理和训练分开算,找出哪些负载值得长期留容量,哪些任务跑完就该释放。
25.7% 算的是整台机器一年用了多久
作者取的是 2026 年 11 月 16 日美国东部(弗吉尼亚北部)的 Linux 按需价。AWS p5.48xlarge 配 8 张 H100,每实例小时 55.04 美元。p4d.24xlarge 配 8 张 A100 40 GB,每实例小时 21.96 美元。自建侧,作者按 30 万美元估算八卡 H100 HGX,参考的是 11 月 20 日卖家公布的 29.5 万至 32 万美元区间。二手八卡 A100 HGX 则按 59,100 美元估算,依据是市场挂牌信息,实际成交价要另查。
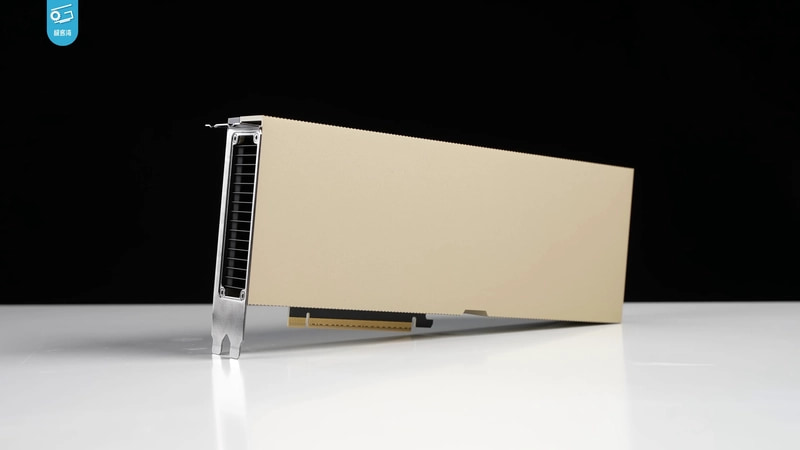
图片由 Geekerwan 拍摄,来自 Wikimedia Commons,采用 CC BY 3.0 许可。
原文对两台机器都按 3 年直线折旧、残值为零处理,每节点每年再计 15,000 美元的设施、支持和网络费用。H100 和 A100 节点分别按 8 kW 和 6 kW 的 IT 功耗估算,PUE 取 1.40,即每消耗 1 度 IT 用电,整座设施约消耗 1.4 度电。电价取美国能源信息署(EIA)2026 年 1 至 8 月的初步工业均价 0.0909 美元/kWh。
用采购价除以 3,加上年度固定费用,再加上按 8,760 小时估算的全年电费,就得到自建节点的年成本。把它除以同配置云实例跑满一年的费用,就是盈亏平衡点。H100 年成本约 123,918 美元,其中电费约 8,918 美元,摊到全年每小时约 14.15 美元。A100 年成本约 41,389 美元。两边相等的前提是,云实例做完任务就能释放,自建整机则全年占着容量并发生费用。
举个例子,每周做提示词扫描、检索评估和短微调,全年只需要 15% 的 H100 节点时间,也就是 1,314 小时。按文中的单价重算,云端实例费约 72,323 美元,原文写的是约 72,297 美元。这点差额对结论影响很小。真正容易改变账单的是实例跑完没关、存储和流量另算,或者用了有最低消费的云承诺。自建侧的税费、融资、额外互连和超出预算的人力也需要补进来。
推理要比合格 token,训练要比跑完一项任务
同样租一小时,两套环境可能交出的结果差很多。推理要数通过质量检查、且满足延迟目标的输出 token。训练可以比较达到目标损失、通过验证的 checkpoint 花了多少钱。模型、精度、批大小、序列长度和软件栈都要固定,才能看出差异来自哪里。显存不够会压小批次,通信开销也会吃掉加速器带来的好处。
原文用一个有稳定流量底盘的推理服务举例。模型能放进一台八卡节点,自建 H100 全年有 65% 的时间在有效工作,每个有效节点小时约 21.76 美元,按需 p5 则是 55.04 美元。如果两边都能达到每秒 8,000 个合格输出 token,一小时就是 2,880 万个。云端每美元约产出 523,256 个,自建约 132 万个,约为云端的 2.53 倍。到 25.7% 的临界点,两边都约为每美元 52.3 万个。8,000 是演算用的假设,作者没有跑出这个基准。如果云端实际快 1.5 倍,就要按更高的产出重算。
GPU 看着忙,服务也可能一直在等 CPU 预处理、远端存储或同步。连续批处理能提高吞吐,但显存里的 KV cache 会随着上下文和并发吃紧,线上服务还得留出容量来保尾延迟。做流量回放时,合格 token 数要和首 token 延迟、p95/p99、排队时间、显存高水位和错误一起看。生产故障切换副本、发布余量也要记进已配置容量,否则算出的利用率会偏高。
训练跨出一台机器,机房和网络也要入账
一台 HGX 里的 8 张卡可以通过 NVLink 高速通信。跨机训练还要看节点间互连、网络拓扑、集合通信库和存储供数速度。AWS p5 提供高速 Elastic Fabric Adapter 网络,p4d 配的是 8 张 A100 40 GB。两者的报价可以直接查,真实模型能否放下、训练多久、最终付多少钱,都要跑过才知道。原文算出二手 A100 节点在 60% 利用率时,每个有效节点小时约 7.88 美元。与 p4d 相比,每美元产出约为 2.79 倍也建立在吞吐相同的假设上。
自建 H100 的 8 kW IT 功耗乘以 1.40 的 PUE,对应 11.2 kW 的设施负载。机柜能否供得上电、带走热量,得找运营方确认。托管报价还要明确可用功率、需量费、网络交叉连接、远程动手服务和最短合同期。机器报价里也可能缺跨节点互连、光模块、备件和服务承诺。这些费用会直接改写前面算出的临界点。
我的判断
我认同作者先按负载拆账的做法。线上推理有稳定底盘,才可能持续摊薄固定成本。提示词回归和每周评估大多是间歇任务,按任务租、跑完释放更容易控制成本。纯云方案还能按实际折扣重算,Spot 则要把中断、checkpoint 和重跑算进去。混合方案可以让稳定负载用固定池,峰值和维护窗口走云端,同时要付出两套环境的运维成本,包括 checkpoint 恢复、驱动版本管理、权限和审计。
这篇给出了报价快照和可复算的账,没给同一模型在两套环境的实测对照。关于部署取舍的建议属于经验之谈,25.7% 则是特定输入下的计算结果。原文把 30 万美元称为报价区间的中点,按 29.5 万至 32 万美元计算,中点实际是 30.75 万美元。复用公式时应填供应商正式报价。即使某个月做到 30%,流量爬坡延迟、维护停机或云端吞吐更高,都可能吃掉账面优势。
能拿来做什么
- 给 Node 服务触发的提示词回归、检索评估和短微调分别记账。至少采集 4 个有代表性的周,记录已分配 GPU 小时、有效工作时间、重试和排队,并用 TTL 标签配合自动回收关闭空闲实例。
- 给线上 AI 接口留一份可版本化的流量回放,固定提示词构成、输入输出长度、批大小、并发、量化方式和验收条件。用同一镜像和数据跑两边,记录完成时间、p95/p99 和每百万合格输出 token 的成本。
- 按模型和资源池做月报,列出合格 token、计算与设施费用、闲置容量。准备采购时,用完整报价和回放数据重算,给利用率留出余量,并先验证故障时能从 checkpoint 恢复、峰值能切到云端。