Claude Fable 5.2 开放 API 并降价
据所给报道,Claude Fable 5.2 已向开发者开放,价格下调 20%,保留百万 token 上下文和最高 128K 输出,官方称生成速度最高提升 30%。同价的 Mythos 5.2 则仅向通过特定验证的组织开放。
AI 深度解读
Fable 5.2 的看点,是它能否把持续数小时、多角色协作的任务做完。原文把一次千代理数学证明演示、几组能力测试和价格变化放在一起,认为它的进步集中在长任务,而日常补代码未必值得升级。
对前端和全栈开发者,更值得看的是账单与调用细节:缓存价格可能比标价降幅更重要,部分请求还会转交其他模型回答。以下发布信息与成绩均按原文转述,其中厂商演示、作者测算和实际使用结论需要分开看。
30 小时完成证明,究竟证明了什么
据原文,Anthropic 在 11 月 9 日发布 Claude Fable 5.2 和 Claude Mythos 5.2。Fable 的 API ID 是 claude-fable-5-2,面向 Claude API、Amazon Bedrock、Google Cloud 和 Microsoft Foundry 的开发者开放;Mythos 同价,但限制访问。
两款模型都保留 1M-token 上下文、最高 128K 输出和 2026 年 6 月知识截止时间。厂商称输出速度比 5.1 系列最高快 30%。Fable 5.1 转为 legacy,退役不会早于 2027 年 9 月 1 日。
最吸引眼球的演示,是约 1,000 个 Fable 5.2 agents 在 30 小时内,用 Lean 完成费马大定理证明的形式化。Lean 会检查证明步骤是否合法;这里的任务是把数学证明变成机器能够逐步验证的形式,不能直接理解成模型重新发现了证明。
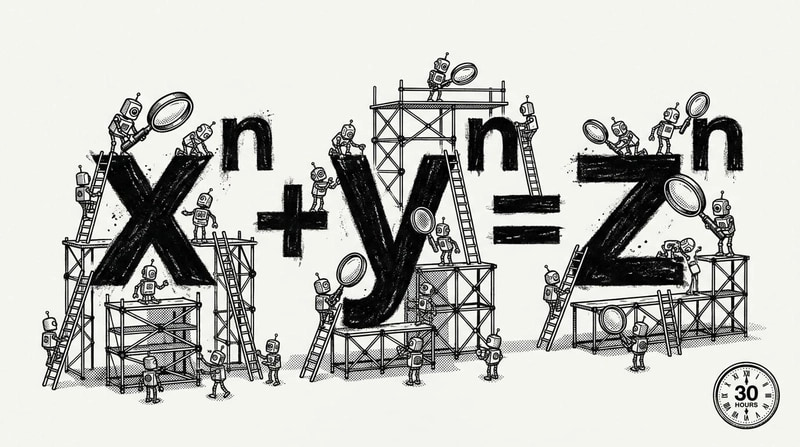
按 Anthropic 的描述,模型从少量提示开始,自行建立协作方式,没有使用数学参考资料,只拿到用于衡量进展的中间定理陈述列表。相同的约千代理配置下,Opus 5.5 在 18 小时完成 26%,到 30 小时后也几乎没有继续推进。原文还提到,一个未发布的 Claude 研究版本曾耗时 11 天,但没有交代它与这次演示的完整条件差异。
这是一场值得研究的演示,还不足以作为稳定性能承诺。
每个模型都只跑了一次。它提示新模型可能更擅长分工、维持共同计划和处理依赖,却没有给出重复成功率、总 token 消耗及人工介入细节。
提升集中在长任务,普通代码修改未必划算
原文列出的编码与工具测试都有增长:FrontierSWE v2 从 Fable 5.1 的 56.3% 升到 69.9%,OSWorld 2.1 从 83.5% 升到 89.3%,带工具的 Humanity's Last Exam 从 65.6% 升到 74.2%。
更大的差距出现在复杂任务。Remote Labor Index 的 high effort 成绩从 17.9% 升到 41.3%;根据摄像头图像控制模拟双臂机器人的 RoboDojo,Fable 5.2 得分 64.9%,对照是 Fable 5.1 的 27.6% 和 GPT-6 Astra 的 29.8%。
这些数字全部由 Anthropic 报告。它们支持作者的判断:升级价值可能更多体现在连续推进工作,而不是每次生成一小段代码。但机器人控制成绩,不能直接折算成前端项目交付效率。
Mythos 5.2 则侧重安全与生物领域。厂商称,它发现的漏洞比 Opus 5.5 多 10.2%,比 Mythos 5.1 多 14.4%;CVE Rediscovery 得分从 78.3% 升到 89.6%。
访问需要通过 Cyber Verification Program 或 Life Sciences Verification Program,fast mode 也受此限制。Claude Enterprise 客户可通过 Claude Security 使用。普通开发者不能仅凭模型价格相同,就假设拥有相同入口。
真正影响接入的,是回退规则和缓存账单
Fable 5.2 会对网络安全、生物等主题运行安全分类器。据原文,触发拦截后,网络安全请求由 Opus 4.8 回答,生物请求由 Opus 5 回答,少量 AI 研究主题也回退到 Opus 5。
所以,选择了 Fable 5.2,并不保证每条请求都由它生成答案。Anthropic 称回退是透明的,但原文没展示响应字段或识别方法。其早期测试还报告,claude.ai、Claude Code 和 Cowork 的拦截次数比 Fable 5.1 少约 55%;这不等于你的业务提示也会减少同样比例。
接入还有两个条件:默认要求保留数据 30 天,零数据保留需要 Anthropic 明确授权;fast mode 据称最高提速至 2.5 倍,价格则为标准模式的两倍。
标准价格从 Fable 5.1 每百万输入/输出 token 的 $10/$50,降到 $8/$40,确实下降 20%。缓存读取为每百万 token $0.20,Batch API 为 $4/$20,整个 1M 上下文窗口没有长提示附加费。
作者把缓存差价称为「Cache Gap」。代理工具会反复发送相同上下文,缓存命中足够多时,缓存单价就会明显影响总账单。GPT-6 Astra 的输入/输出价格为 $10/$50,缓存读取为 $1.00,是 Fable 的五倍。
作者测算的一次高缓存编码会话,Fable 花费 $17.44,Astra 为 $27.20,相差 35.9%;同一会话用 Opus 5.5 则为 $9.44,Fable 仍贵约 1.85 倍。原文没有附上完整用量拆分,这些金额不能直接当预算。它还列出 Tokely 的 $6/$30 报价,但没有说明与官方服务条件是否一致。
我的判断
作者把注意力放在「任务能否持续推进」上,这个方向有价值。长任务里,一次中途停滞就可能抵消局部生成速度的收益。不过,千代理证明演示和厂商测试,仍不足以证明普通团队接入后会获得同样提升。原文也没有提供作者在真实代码仓库里的对照实测。
价格部分需要纠正一个算术问题:原文称 Astra 的 $10/$50 比 Fable 的 $8/$40「只高 20%」,按 Fable 为基数实际高 25%;反向计算,Fable 比 Astra 低 20%。
模型是否便宜,最终要看完成一项合格任务花多少钱。
缓存命中率、输出长度、重试次数和人工返工都会改变结果。把日常请求交给 Opus 5.5 或 Sonnet 5.5,只让困难任务使用 Fable,是值得验证的分流思路;原文没有给出它们在相同验收标准下的完整成本对照,因此仍属经验建议。
能拿来做什么
- 如果你在用 AI 修改前端或 Node 项目,可以选一个跨文件任务,对比现有模型与 Fable 5.2 的完成情况,同时记录耗时、重试和人工修改量。
- 如果编码代理频繁携带相同上下文,应分别统计普通输入、缓存读取和输出费用,再判断 $0.20 的缓存价格能省多少。
- 如果工具涉及安全、生物或相关研究提示,应先测试真实请求,并核实回退识别方式及 30 天数据保留条件。
- 可以把 fast mode 留给有人等待的交互任务;异步工作则结合 Batch API 的适用条件评估,避免仅为提速承担双倍价格。