本地大模型测速为何难以复现
文章从 Mac 本地推理服务选型出发,分析内存带宽、模型格式、量化方式和计时口径如何影响生成速度。即使模型名称相同,MLX、GGUF与其他格式的测速结果也不能直接横向比较。
AI 深度解读
本地大模型跑出多少 tok/s,不能只看模型名称和服务器名称。作者为 Mac 项目挑选推理服务时,发现网上的基准测试很难复现,最后把问题追到了模型文件、推理开关、计时口径和机器状态上。
他的结论是:与其追着别人的排行榜选工具,不如用同一套客户端测量自己的请求。这篇值得读的地方,是给出了可照着做的测试方法,也明确承认:一台 Mac 上的结果,撑不起通用排名。
同一个模型名,为什么跑不出同一个速度
硬件差异只是第一层。作者指出,内存带宽对速度影响很大,同样叫 Apple Silicon Mac,机器之间也可能有两倍差距。
模型文件也不能只按名字对齐。「LFM3 1.7B」的 MLX 8-bit、GGUF Q4_K_M 和 Ollama 的 mxfp8,采用了不同表示方式。名字相同,不代表拿到的是同一份测试对象。
更隐蔽的问题是计时口径。部分服务器报告的速度不包含首个 token,部分不算提示词处理,还有的只报告生成阶段。把这些数字放在一起,比较的时间范围就已经不同了。
推理模型又增加了一层变量。同一个提示词,是否先思考,可能让输出从 30 tokens 变成 500 tokens。作者实际踩过这个坑:Rapid-MLX 默认关闭 thinking,需要显式请求;其他服务可能默认开启。这个差异后来由 Rapid-MLX 维护者在 issue 中解释清楚。
服务器默认值不同,足以让一次性能比较失去可比性。
怎么测,才能接近应用真正感受到的速度
作者选择自己计时:向各服务器发送相同的流式请求,用客户端的 time.perf_counter() 记录耗时,不采用服务器自行上报的速度。
他同时观察四项指标:首 token 延迟、生成速度、整体有效速度,以及系统 RAM 使用量。其中,整体有效速度是「输出 token 数 ÷ 总耗时」,包含提示词处理。对需要等待回复的应用来说,这比单看生成阶段更接近用户体验。
测试流程也有几处约束:
- 丢弃第一次运行,因为它涉及模型加载和预热。
- 预热后至少运行三次,取中位数,同时保留最小值和最大值。
- 每次请求明确设置 reasoning 开或关,不依赖默认值。
- 每条提示词以唯一 ID 开头,避免提示词缓存悄悄抬高后续成绩。
作者的笔记本即便重复同一项测试,结果也会在不同分钟间波动 10% 到 20%,可能受后台应用、温度等因素影响。因此,单次运行相差 5%,不足以证明谁更快。
他的示例条件是 M5 Pro、24 GB 内存、LFM3 1.7B 8-bit、短提示词、512 个输出 tokens、reasoning 关闭,取三次预热后运行的中位数。作者把结果理解为「几家很接近」,前两名在噪声范围内相当,换提示词语言甚至会改变顺序。所给原文没有列出逐项成绩,不能据此整理出具体排名。
TokenRace 把这些测量步骤装进了一个工具
作者把测试方法做成了开源应用 TokenRace。安装了 uv 后,可以直接启动:
uvx tokenrace
注意这条命令启动的是测试工具;进入后还要选择服务器和模型,才能开始比较。
工具会实时展示数据,结束后提供汇总、图表和 CSV。按作者描述,整个过程在本地运行,不向外发送数据。
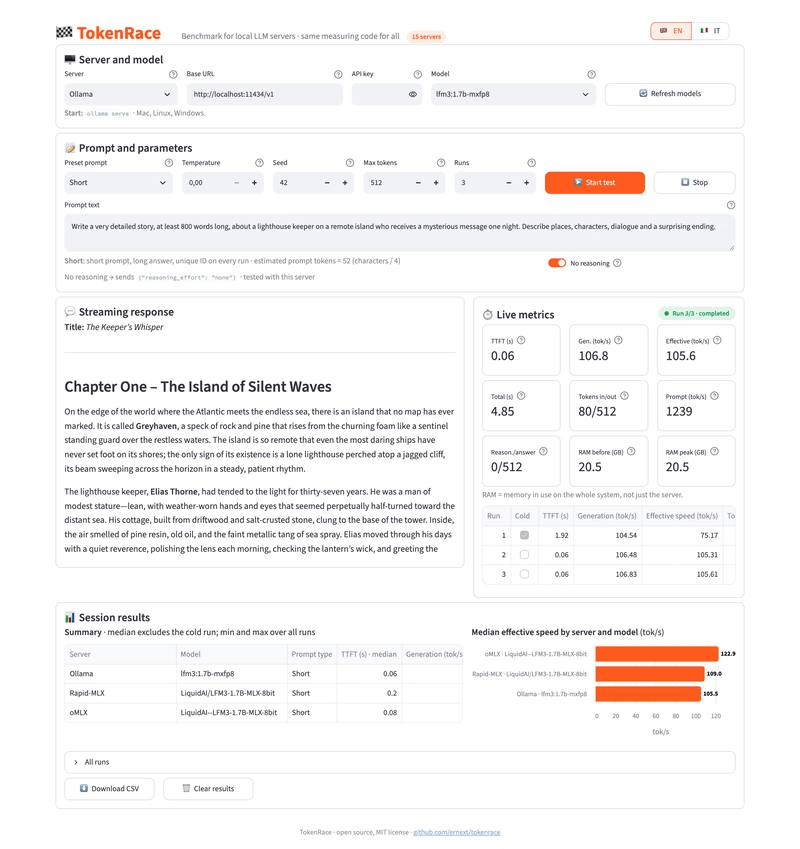
它预置了 15 个服务器:Ollama、LM Studio、llama.cpp、vLLM、SGLang、Rapid-MLX、oMLX、mlx_lm.server、LocalAI、Jan、KoboldCpp、text-generation-webui、Lemonade、Docker Model Runner 和 Unsloth Studio。
其他服务如果兼容 OpenAI API,可以修改 URL,或者在 config/servers.toml 中添加配置。不过,预置支持不等于全部经过作者实测。他只在一台 Mac 上测试过其中几个服务,仍希望收集 NVIDIA、AMD 和 Linux 环境的数据,以及端口、reasoning 参数方面的修正。
我的判断
我赞同先统一测量口径,再讨论谁快。尤其是流式聊天或 AI 编程工具,生成速度高,不一定代表首字出现快,也不一定代表整次请求结束早。把这些指标分开,才知道等待发生在哪里。
但这套方法仍有边界。唯一 ID 是作者规避缓存的办法,原文没有验证各服务是否都因此失去缓存收益。如果实际应用会反复发送相同的系统提示词,缓存表现也值得单独测试。
三次取中位数适合作为起点,不能自动保证结果稳定。至于提示词语言导致排名变化、各服务在示例中速度接近,都是作者当前环境下的观察。原文没有跨硬件对照,也没有并发负载数据,不能拿来决定团队部署方案。
这篇最有价值的是测试流程,而不是某个服务器的胜负。
能拿来做什么
- 给本地 AI 编程助手选推理服务时,先记录模型文件格式、量化方式和 reasoning 设置,再比较速度,避免只对齐模型名。
- 调试前端流式回复或 Node 中转服务时,同时记录首 token 延迟和请求总耗时,用它们区分「开始得慢」与「生成得慢」。
- 用真实提示词重复测试,保留中位数和波动范围;如果日常会使用中文,就把中文请求纳入样本。
- 将 TokenRace 导出的 CSV 与硬件、模型和请求配置一起保存,让后续换服务、换模型的比较有据可查。