近三百万字符的 MCP 返回,如何评估处理成本
作者真实调用了 30 个仓库的议题接口,累计返回约 295 万字符,其中 28 次超过 Claude Code 的结果落盘阈值。文章用手写 Node.js 脚本模拟 Code Mode 风格处理,未实际启用 Code Mode,模型令牌数和轮次也仅为估算。
AI 深度解读
查 30 个开源依赖最近有没有回归,作者光是拉取 GitHub Issues,就收到了近 300 万字符。Claude Code 的 Code Mode 提供了一种处理思路:让 JavaScript 批量调用工具,在脚本里筛数据,再把结果交给模型。作者用 Node.js 模拟这套流程,在同一批 25 个仓库上,把返回量压到了逐次调用的 0.067%。
这组数字能说明大批量 MCP 查询有多少内容可以在模型读到之前处理掉。实验也暴露了更实际的问题:10 条命中里有 5 条误报,3 条评论查询全部失败。脚本交给模型的内容越少,越要说清它查到了什么、漏了什么。
Code Mode 省下的是哪一段上下文?
默认流程里,模型发起一次 Bash、Read、Edit 或 MCP 调用,收到结果后再决定下一步。Code Mode 把中间这段交给 JavaScript。脚本可以并行查多个仓库,再根据第一批结果决定去查哪些评论,最后只把一个对象交回模型。对话里仍能看到工具调用与编辑差异,按 Ctrl+O 打开记录并展开 Code 行,可以看到脚本本身。
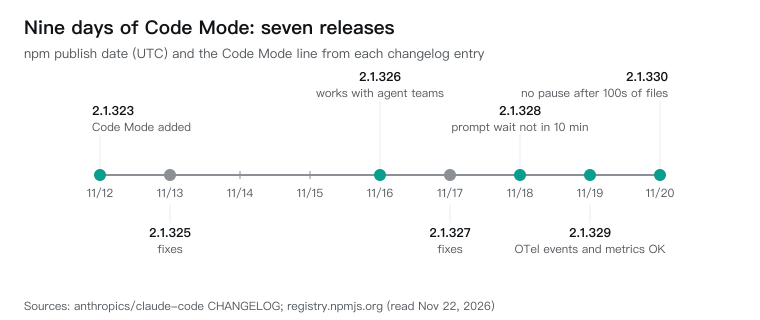
按原文记录,Code Mode 在 Claude Code v2.1.323 加入,npm 发布时间为 2026 年 11 月 12 日 20:29 UTC。它默认关闭,通过 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1 claude 在交互式终端启动,也可写进用户设置的 env,项目设置无权开启。中间五个版本都有修复,其中 2.1.326 支持 agent teams,2.1.328 将权限提示等待时间排除在 10 分钟限制之外,2.1.329 兼容开启 OpenTelemetry 事件与指标的会话,2.1.330 修复了读取数百个文件后的长时间停顿。按作者在 11 月 22 日的记录,11 月 20 日发布的 2.1.330 仍将它标为实验功能。
作者原计划在 Claude Code 里做开关对照。机器上有桌面应用附带的 2.1.328,但带着开关运行 claude -p 时,返回了 Not logged in · Please run /login,初始化工具里也没有 REPL。作者没有继续登录交互式会话。下文的 MCP 请求、响应大小、脚本耗时和账单来自实测,脚本由作者手写并在 Node.js 中运行,模型 token 和轮数都是估算或推断。
查 30 个仓库,为什么会收到近 300 万字符?
任务是扫描 React、Next.js、Vite、TypeScript 等 30 个 JavaScript 和 Python 依赖仓库。每个仓库查最新 30 项,筛出最近 7 天、标题或标签命中回归等关键词的 Issue,再按评论数取前 3 条查评论。EveryInfra 的 github/repository_issues 接收仓库 URL,默认返回 30 项,最多 100 项。github/issue_comments 接收 Issue URL。两项都是同步调用,每次成功收费 $0.000958,失败或限流收费 $0。作者在 12:38:05 SGT 查询免费目录 GET /api/v1/social/catalog 时,目录列出 714 项能力,其中 683 项可用。
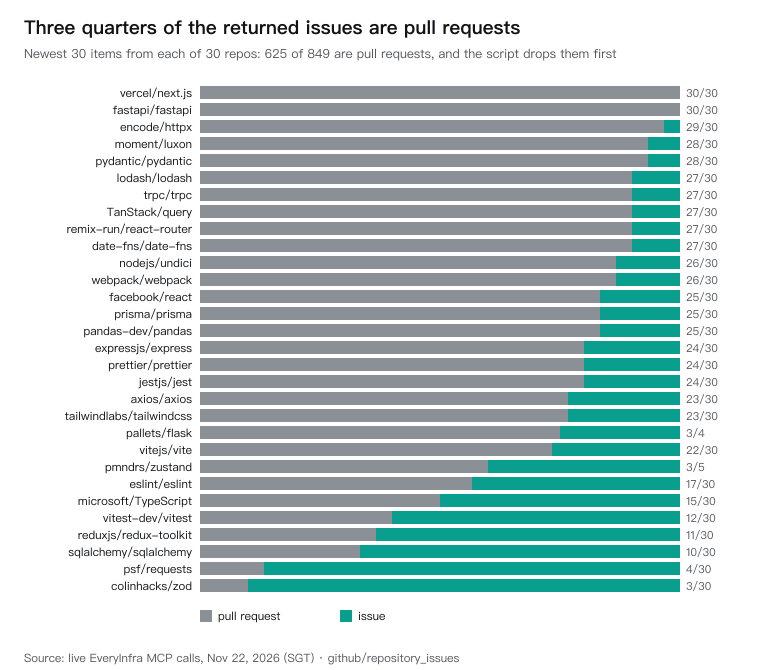
11 月 22 日 12:43 至 12:51 SGT,30 次真实 tools/call 共返回 2,953,102 个字符。单仓库中位数是 84,740 字符,TanStack/query 最大,为 323,135 字符,pmndrs/zustand 最小,为 4,538 字符。完整 Issue 正文占了大头。GitHub 的 Issues 列表也会返回 PR,849 项里有 625 项是 PR,占 73.6%。Next.js 和 FastAPI 当时各返回 30 项,全是 PR。这个取样窗口能看到什么,首先受接口返回顺序和条数限制。
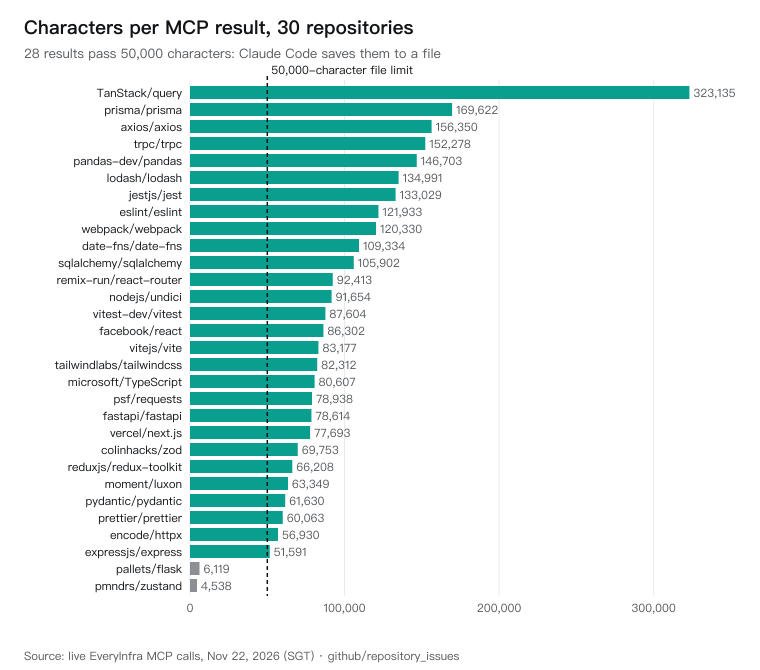
作者拿 Anthropic 词汇表里的旧分词口径作起点,每 token 约 3.5 个英文字符,再按 Claude 4.7 及后续分词器对同一段文本多产出约 30% 的 token,换算成每 token 约 2.69 个字符。整批约 109.7 万 token,高于原文列出的 Opus 5.5 的 100 万 token 上下文窗口。Claude Code 对单个 MCP 结果设有 10,000 token 的告警、25,000 token 的默认上限,后者可用 MAX_MCP_OUTPUT_TOKENS 调整。对未声明自身上限的工具,单条文本超过 50,000 字符会落盘。本次有 28 条越过落盘线,约 22 条越过默认 token 上限。若要逐页读回,Read 单次最多返回 25,000 token,超过 256 KB 的文件需要分页读取。
脚本压得有多小,又丢了什么?
下面是作者在 Node.js 里模拟的主体。它把查仓库、筛 Issue 和补评论串起来,再返回精简结果。
// In Code Mode, callTool is a ready-made function in the session (it calls mcp__everyinfra__everyinfra_call_api).
// In Node.js we replaced it with a small function that calls the MCP endpoint. The rest is unchanged.
const since = Date.now() - 7 * 864e5;
const RX = /regress|breaking|crash|segfault|security|vulnerab|CVE|memory leak|hang|broken|not working|fails?\b/i;

async function api(platform, action, params) {
  for (let i = 0; i < 6; i++) {
    const res = await callTool("everyinfra_call_api", { platform, action, params });
    if (res.isError) {
      const e = res.structuredContent?.error ?? {};
      if (e.code === "rate_limited") { await sleep(((e.retry_after ?? 10) + 2) * 1000); continue; }
      return { error: e.code ?? "error", charged_usd: 0 };
    }
    const j = JSON.parse(res.content[0].text);
    return { results: j.results ?? [], charged_usd: j.billing?.charged_usd ?? 0 };
  }
  return { error: "gave_up", charged_usd: 0 };
}

const pages = await pool(repos, 3, 7000, rp =>
  api("github", "repository_issues", { url: `https://github.com/${rp}` }));
const hits = [];
pages.forEach((p, i) => (p.results || []).forEach(x => {
  if (x.is_pull_request || Date.parse(x.posted_at) < since) return;
  if (!RX.test(x.title + " " + (x.labels || []).join(" "))) return;
  hits.push({ repo: repos[i], number: x.number, title: x.title.slice(0, 90),
              comments: x.comment_count, url: x.url, posted: x.posted_at.slice(0, 10) });
}));
hits.sort((a, b) => b.comments - a.comments);
const top = hits.slice(0, 3);
const threads = await pool(top, 3, 7000, h => api("github", "issue_comments", { url: h.url }));
top.forEach((h, k) => { h.last_comments = (threads[k].results || []).slice(-3)
  .map(c => (c.text || "").replace(/\s+/g, " ").slice(0, 200)); });
({ repos: repos.length, failed: pages.map((p, i) => p.error ? repos[i] : null).filter(Boolean),
   hits: hits.length, top, other_hits: hits.slice(3, 15).map(h => `${h.repo}#${h.number} ${h.title}`) });
看 threads[k].results || [] 这一行,评论查询失败也会生成空数组,而返回对象里的 failed 只记录仓库查询失败。模型拿到空数组时,缺少判断评论到底有没有查成功的信息。
第一轮脚本最多同时跑 3 个请求,启动间隔至少 7 秒。它用时 194 秒,发了 42 次请求,其中 25 次成功、9 次触发每个 key 每分钟 10 次的限流、8 次返回 unavailable。脚本只重试 rate_limited,因此漏掉了服务端已标记 retryable: true 的 5 个仓库和 3 次评论查询。
脚本实际读取 2,502,282 字符,返回 1,687 字符,约 627 token。对照轮里,同一批 25 个仓库的原始响应为 2,502,999 字符,这才是 0.067% 的分母。10 条候选中,eslint/eslint #21556 的 6 条评论排第一,另外还有标题以 7.0 regression 开头的 TypeScript #65600,以及在 Node 27 上截图断言失败的 Vitest #11976。作者报告 10 条里有 5 条误报,原文没有给出对未命中项的核查结果。
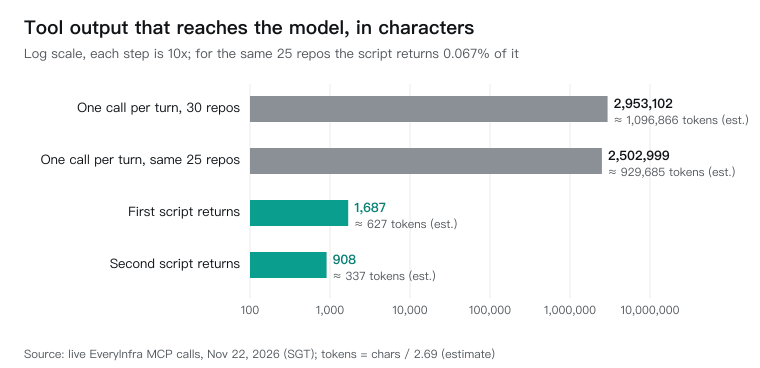
第二轮只补查失败的 5 个仓库,合并已有命中后再查前 3 条评论。它处理 retryable: true,按 retry_after 等待,上限 60 秒。每项最多尝试 3 次,24 次请求全返回 unavailable,收费 $0。378 秒后返回的 908 字符约合 337 token,5 个仓库仍缺数据,3 组评论仍为空。作者提出的技术目标是输出不超过原始体积的 10%、模型交互不超过 3 轮。体积目标有数据,轮数没有实测。
我的判断
这次实验最有说服力的是输出边界。按日期过滤、移除 PR、裁掉大段正文,这些操作用脚本就能完成,留给模型的应该是候选及其证据。5 条误报也提醒我们,关键词筛选只能当初筛。前 30 项又可能被 PR 占满,因此「没筛出回归」只适用于查到的范围。按评论数排前三可以挑出讨论热的报告,判断严重程度还得看受影响版本、复现条件和实际影响。
如果手头已经有落盘的 JSON,作者提到的 jq 就能做到先过滤再读。Code Mode 的额外价值在于脚本可以直接调用会话内的 MCP 工具,还能根据上一步结果发起下一批调用。已有维护稳定的 Node.js 巡检脚本时,继续用它也能取得这次实测的压缩收益。原文没有真实的 Code Mode 开关对照,因此 0.067% 只能用来解释返回体积,端到端耗时、模型账单和交互轮数仍缺测量。两轮脚本共用 572 秒,重试耗时比输出压缩更直接地影响这次任务能否完成。
能拿来做什么
- 给前端依赖做每周巡检时,用 Node.js 按日期和
is_pull_request初筛,给每条候选保留仓库名、Issue 编号、命中原因和可供复核的正文片段。对 Next.js 这类首批结果可能被 PR 占满的仓库,单独报告实际扫描范围。 - 给仓库查询和评论查询分别返回成功数、失败项和错误码。遇到
retryable: true时按retry_after退避,并给整批任务设时间预算,让后续脚本只补查失败项。 - 试用 Code Mode 时,用
claude mcp add --transport http按用户作用域配置远程 MCP,密钥放在EVERYINFRA_API_KEY。把工具限制写进权限规则和PreToolUsehook。原文指出,auto mode 在执行前只审查一次脚本,运行时从前一条响应算出的 URL 要靠逐次调用的规则约束。 - 用固定的一批仓库对比逐次调用和脚本过滤,分别记响应字符数、模型轮数、耗时和失败率。要算 token 时,用同一个模型 ID 调 token counting endpoint,并抽样复核命中项和未命中项。