单卡部署 NitroFusion2 的显存与延迟实测
作者在 RTX 4090 上提供 NitroFusion2 推理 API,实测生成 1024×1024 图像时,一步约耗时 0.8 秒,两步约 1.3 秒。完整模型叠加约 8GB 的文本编码器后峰值显存约 23GB;16GB 显存限制下,7.2GB 量化版本仍溢出,5GB 版本可容纳。
AI 深度解读
NitroFusion2 把 Z-Image-Turbo 的八步生图压到一两步,作者团队在单张 RTX 4090 上测到,1024 × 1024 图片的一步 GPU 耗时不到一秒。但部署成 API 后,决定它是否好用的,还有文本编码器占用、显存模式和图片里的文字。
这组测试值得看,因为它把「模型跑得快」拆成了几个可检查的问题:显卡装不装得下、请求实际等多久、少走几步会损失什么。结论是,预览图可以追求一步出图,菜单和价格标签却不能只看速度。
16 GB 显卡能不能跑,不能只看模型文件
NitroFusion2 由 University of Surrey 的 SketchX 研究者 Dar-Yen Chen 和 Yi-Zhe Song 开发,以 Apache-2.0 发布。它通过蒸馏,让学生网络用一两步逼近 Z-Image-Turbo 八步生成的结果。
主网络 transformer 的文件是 12.3 GB,看起来能塞进 16 GB 显卡,但提示词还要经过文本编码器,转换成模型能处理的数值表示。这个沿用自 Z-Image-Turbo 的组件,单独就占约 8 GB。作者实测,完整模型的峰值占用约 23 GB,全放 GPU 需要 24 GB 显卡。
量化能降低主网络的占用。官方提供 2.0 GB 到 7.2 GB 的 GGUF 文件,用更少位数存储权重。作者在 16 GB 显存上限下测试,7.2 GB 文件第一次生成就内存不足,5 GB 文件则能和文本编码器一起放下。
在实体 16 GB、功耗 70 watts 的 RTX 2000 Ada 上,全程驻留 GPU 时,一步约 4.0 秒,两步约 7.3 秒。至于 8 GB 显卡,文本编码器已经占满预算;作者没有测试更小的编码器,不能据此承诺能跑。
还有一个容易漏掉的配置:示例的显存模式默认是 auto,只有空闲显存至少达到 23 GiB,才会让整条流水线留在 GPU。低于这个门槛,就把部分组件放到系统内存,需要时再搬回 GPU。
因此,16 GB 显卡即便用了合适的量化文件,也要明确指定驻留模式:
NF2_TRANSFORMER=nf2-Q4_K_M.gguf
NF2_MEMORY_MODE=gpu
要看的是第二行。作者用完整模型、限制到 16 GB 并启用卸载时,每张图耗时达到 14 至 19 秒。卸载后的图片看起来相同,配置问题只能从耗时里暴露出来。
一步不到一秒,为什么接口没有同样快
NitroFusion2 接受 1 至 4 步,guidance 必须为 0。guidance 可以理解为采样时向提示词靠拢的力度,这里不能直接套用其他模型的习惯参数。
作者自己的控制台测试器默认是 20 步、guidance 4.5,请求直接返回 400。SDK 示例的 README 已写明限制,测试器默认值却没有同步。这是接入时很实际的问题:模型换了,表单默认值和参数校验也得跟着换。
在 RTX 4090 上生成 1024 × 1024 图片,一步 GPU 耗时为 0.78 至 0.82 秒,两步为 1.32 至 1.33 秒。两步方案还建议搭配一个 0.38 GB 的附加组件,让第一步混入一半 Z-Image-Turbo 的计算,再由学生网络独立完成。
但 GPU 耗时只覆盖绘制。完整往返还包括请求、PNG 编码和网络,一步场景下耗时接近翻倍。作者举出的单步海报请求约 1.1 秒,API 整体吞吐约为一步每分钟 40 张、两步每分钟 30 张。
这些数字都有边界:请求逐个执行,没有批处理、没有并发,也没有八步基线。测试用的 4090 实际有 48 GB 显存,再限制为常见的 24 GB 条件。
服务是否够快,要同时记录 GPU 耗时和完整请求耗时。
真正决定步数的,往往是图片里的文字
作者用猫和标牌提示词、seed 42 测试,4090 在一步时生成了「HELLO WORd」,两步搭配附加组件后才得到「Hello World」。
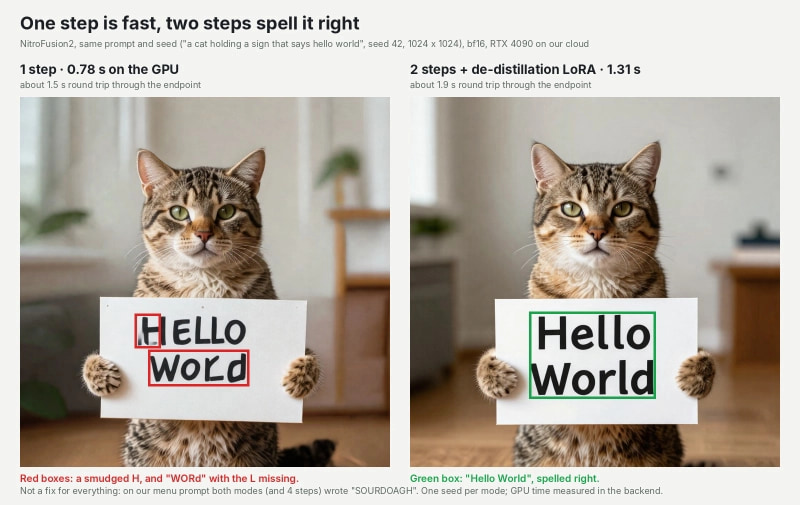
然而,同一个 seed 在 16 GB 显卡上,一步就写对了「HELLO WORLD」。固定 seed 只是固定随机起点,不能保证跨显卡复现同一张图。每条提示词只测一个 seed,最多证明流程能跑通,不能当作质量评分。
短而大的文字表现相对好。里斯本电车海报中的「LISBOA」和「Tram 28 - every 12 minutes」,在一步、两步以及 16 GB 显卡上都拼写正确。小字却不稳定:咖啡馆菜单要求「SOURDOUGH 4.50」,4090 在一步、两步和四步下都写成了「SOURDOAGH」。
论文也承认文字渲染仍有明显差距。其长文本测试中,一步为 43/100,两步为 76/100,八步 Z-Image-Turbo 为 92/100。这是论文作者的数据,部署团队没有复现。
多加几步有帮助,却不是文字正确性的保证。
我的判断
这份记录最有用的地方,是把显存账算到了文本编码器,也揭示了 auto 模式可能让量化模型失去预期速度。相比默认卸载,指定量化文件并驻留 GPU,在这次 16 GB 测试里更适合追求低延迟。
但它还不足以证明 NitroFusion2 在完整服务成本或质量上优于八步方案。作者没有提供批处理、并发和八步基线,单提示词、单 seed 的图片也只能作为案例。一步用于预览、两步用于短标题,是有依据的使用建议,尚不是普遍适用的质量结论。
对于必须准确的文字,我更认可原文建议的后期叠字。让模型负责画面,用浏览器、SVG 或 Canvas 排版文字,能直接控制拼写、字号和价格。代价是文字与画面的融合需要额外设计。
能拿来做什么
- 接入生图 API 时,把步数限制为 1 至 4、guidance 固定为 0,并同步修改测试页默认值,避免沿用 20 步和 4.5 导致 400。
- 用 16 GB 显卡部署时,优先复核约 5 GB 的量化方案与
NF2_MEMORY_MODE=gpu,同时记录峰值显存和单张耗时,确认没有进入卸载路径。 - 在 Node 服务中分别记录模型报告的 GPU 耗时和请求总耗时,再用实际请求节奏评估吞吐,别直接把 GPU 秒数换算成接口容量。
- 海报预览可以先试一步,短标题用两步后人工检查;菜单、标签和价格用真实文字叠加,或者评估八步 Z-Image-Turbo,并继续核对文字。