Kimi K3.1 Pro 跃居智能指数第四
Kimi K3.1 Pro 在 Artificial Analysis 智能指数中获得 55 分,比前代提升 11 分,排名第四。若按计划开放权重,开放权重模型与该榜领先闭源模型的差距将缩至 3 分。
AI 深度解读
Kimi K3.1 Pro 这次最值得关注的,是模型规模没变,靠更多后训练计算把综合评测成绩推到了头部附近,同时降低了 API 单价。对程序员而言,真正有用的信号在于:它执行终端任务、调用工具和完成建模工作的能力,出现了明显提升。
但「接近 Claude」需要拆开看。第三方排名、厂商内部测试、计划开放权重,是三种不同性质的信息。把它们分清,才能判断它是否值得进入你的 AI 编程工作流。
距离 Claude 还有多远,要看具体任务
按原文引用的 Artificial Analysis Intelligence Index,Kimi K3.1 Pro 得到 55 分,比 Kimi K3 提高 11 分,排名第四。前面是 Claude Opus 5.5 的 58 分,以及同为 56 分的 Claude Sonnet 5.5 和 Muse Wonder Full。
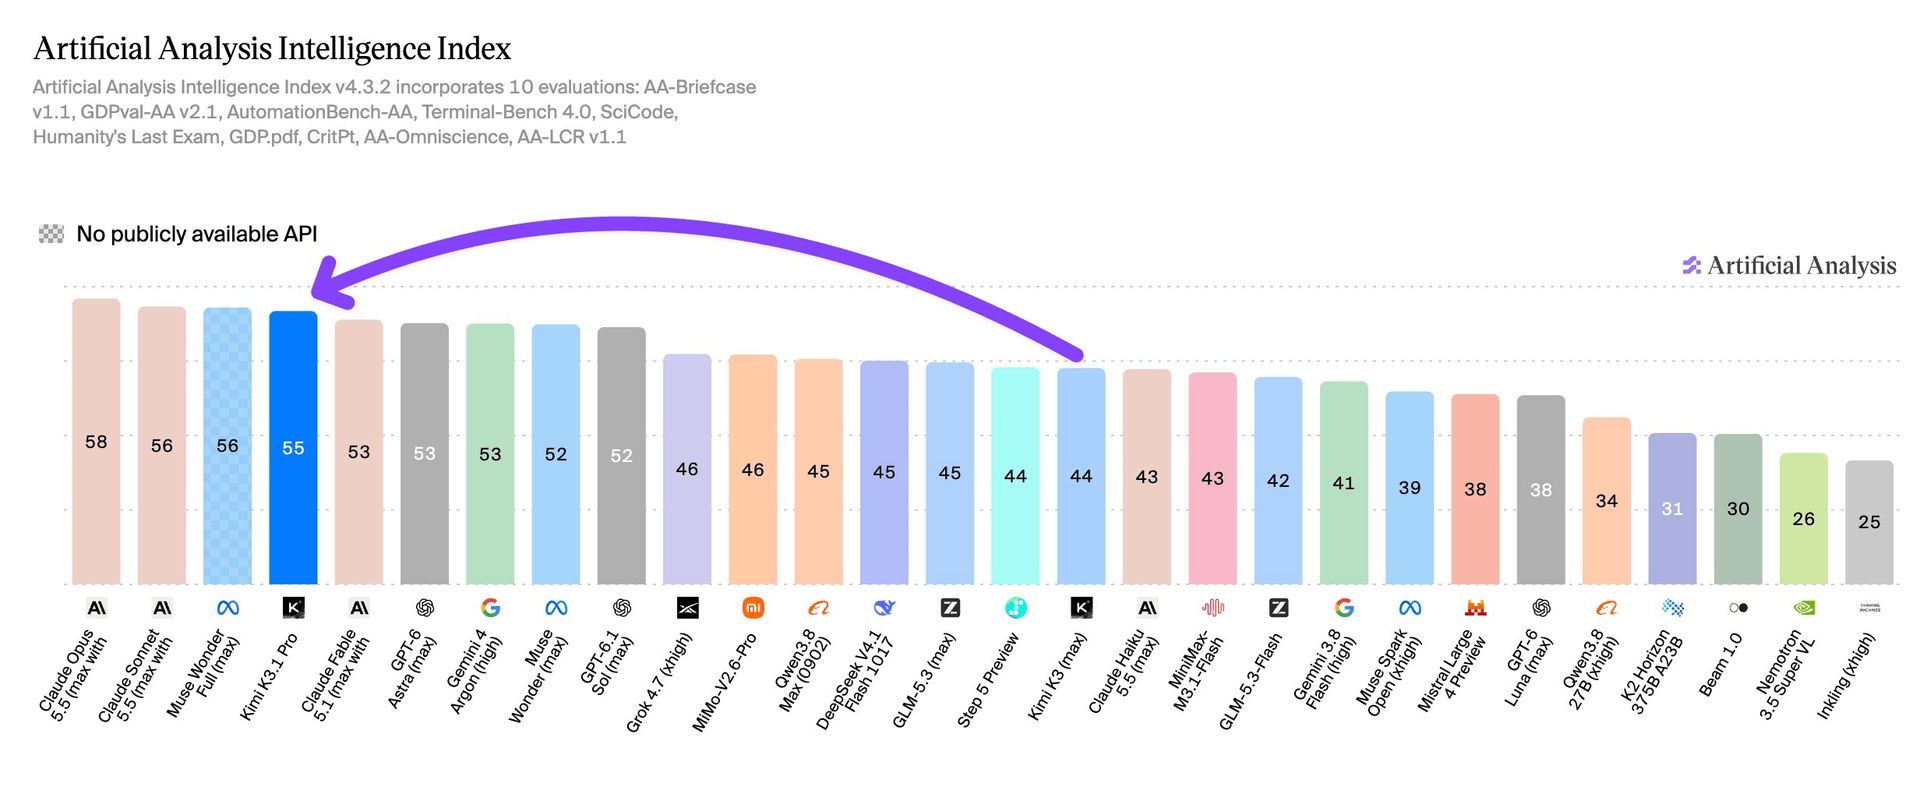
这个排名支持「综合能力接近头部」,但不能直接推出所有编程任务都接近 Claude。
更贴近实际工作的,是智能体(Agent)测试,也就是模型能否连续执行步骤、使用工具并完成任务。第三方 GDPval-AA 给 K3.1 Pro 的成绩是 1,846 Elo,比 K3 高 312 分,接近 Claude Opus 5.5 的 1,866 和 Muse Wonder Full 的 1,857。
终端操作方面,Moonshot 公布的 Terminal-Bench 4.0 成绩为 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;K3 在同一测试上只有 13%。这里提升很大,但数据来自厂商,原文也注明其基准表全部使用 reasoning effort="max",不能把这些结果当成默认配置下的表现。
可靠性也有改善。内部 Kimi Hallu Bench Hard 中,按单条断言统计的幻觉率从 23.4% 降到 8.3%,GPT-6 Astra 则为 5.5%。Moonshot 明确说这是压力测试,不能拿 8.3% 当作日常使用的通用错误率。
办公能力的证据更依赖内部测试:Financial Modeling 提高 7.2 分,Financial Research 提高 11.6 分,OfficeQA Pro v2 则据称超过全部参测模型。原文没有提供足够细节,让读者独立判断这些提升能否迁移到自己的业务。
编程能力的亮点,是把软件工具真正用起来
Moonshot 称,K3.1 Pro 可以直接配合 Unity、Unreal Engine 和 Godot,处理局部修复,也能完成整个项目的构建。不过,原文没有给出这些项目的规模和验收标准,「完整项目」仍需保留判断。
相对具体的是 BenchCAD:使用工具时得分 92.7%,接近 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%;不用工具时为 72.8%,与 Claude Opus 5.5 的 73.0% 接近。
厂商强调的优势是机械零件、建筑模型和可配置产品的参数化建模。可以把它理解为:用尺寸、约束和脚本描述模型,让修改一个参数能够带动整体调整。它可以编写并运行 Blender、CAD 脚本,无需 MCP 连接器,但这不代表运行环境、软件权限和结果验收都能省掉。
Kimi.com 同时推出了「3D Make」,支持预览、编辑和导出 3D 模型。普通入口则包括 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API。另有 K3.1 Pro Highspeed,厂商称速度达到普通版本的 2 至 3 倍,原文没有交代加速后的质量差异。
Token 便宜三分之一,任务账单为什么几乎没变
K3.1 Pro 仍是 2.8 万亿总参数、1040 亿激活参数,支持文本和图像,上下文窗口为 100 万 tokens。它是 K3 增加后训练计算后的版本,提升并非来自参数规模扩大。
API 单价下降 33%:每百万输入 tokens 从 3 美元降到 2 美元,输出从 15 美元降到 10 美元,缓存命中从 0.30 美元降到 0.20 美元。
但 Artificial Analysis 测得,每项 Intelligence Index 任务的成本只是从 2.00 美元降到 1.98 美元,原文解释为输出 tokens 增加了 14%。报道没有展开完整账单构成,仅凭这些数字,还无法独立复算两者之间的关系。
每百万 tokens 的报价,不能代替完成一次任务的成本。
AA 将它放在帕累托前沿,表达的是在所比较的条件下,没有明显全面占优的替代项。原文还称,相近参数规模的模型没有更高综合得分。但这都不等于它对每个团队最划算:延迟、失败重试和人工检查同样需要计入成本。
开放权重也尚未兑现。Moonshot 计划在 2026 年 11 月 4 日前发布权重。只有届时其他模型不变,它才会成为最高分的开放权重模型,并把开放权重与闭源模型的分差从 12 分缩到 3 分。
我的判断
我更认可这次发布体现的方向:同样规模的模型,通过后训练,可以显著改善多步骤任务表现。但从榜单接近到团队可用,中间还隔着工具权限、仓库环境和验收标准。原文没有给出一般团队接入后的对照数据,不能替它背书。
安全能力的取舍也值得看。Moonshot 称,网络安全能力随训练增强,因此为开放权重版本清理了中期训练和强化学习阶段的相关数据。在复现 Linux kernel、Node.js、JavaScriptCore 等软件近期漏洞的内部 xdev-bench-hard 上,清理前成功率为 90.5%,清理后为 81.0%;DeepSeek-V4.1-Flash 为 85.7%,Kimi K3 为 33.3%。
这说明厂商主动降低了部分攻击能力,但不能仅凭一项内部测试认定安全问题已经解决。原文还转述 Anthropic 的研究:AA 指数只有 45 分的 GLM-5.3,也能写出接近 Claude Mythos 水平的漏洞利用代码。这恰好提醒我们,综合分数不能覆盖所有专项能力。
与继续使用熟悉的闭源模型相比,K3.1 Pro 值得加入候选;与立即全面迁移相比,先做真实任务对照更合理。它的优势已经有评测信号,稳定性、速度和完整任务成本仍要自己验证。
能拿来做什么
- 从现有前端或 Node 项目中挑选可验收的任务,例如修复构建失败、执行测试并修正报错,让 K3.1 Pro 与当前模型使用相同工具和权限,比较最终完成情况。
- 调用 Kimi API 时,同时记录输入、输出、缓存命中、重试次数和总耗时,再计算每个成功任务的成本,避免只按降价 33% 做预算。
- 有 Blender、CAD 或游戏引擎需求的团队,可以先试参数明确的小模型或局部修改,检查导出结果和脚本是否满足要求,再决定是否扩大任务范围。
- 计划自部署的团队,可以先验证 API 表现;等权重实际发布后,再核对许可、硬件需求和部署条件,原文尚未给出这些信息。