自然语言查数据,如何限制模型权限
作者计划构建 Rails 引擎,让 SaaS 用户用自然语言查询业务数据,同时避免模型直接生成 SQL 或访问数据库。系列将通过已测试代码、方案取舍与评估结果讨论 LLM 和 RAG 集成,当前篇主要说明设计动机。
AI 深度解读
让 SaaS 客户用自然语言查订单,难点不只是把问题翻成 SQL,还包括:客户能查什么、查询属于哪个租户、哪些信息会离开应用。DataTeller 的选择是让 LLM 填写受限的查询结构,再由 Rails 引擎校验、编译和执行。
这篇开篇文章值得看的是权限边界怎么划,而不是模型表现有多好。作者还没有给出评测成绩,部分界面也只是演示稿,但已经明确了一条工程原则:模型可以理解问题,数据访问规则必须由应用控制。
为什么不让模型直接写 SQL
作者设想的用户是网店店主。他打开订单管理系统,问一句「明天有多少订单要发货」,希望直接拿到数字,不必等待开发者新增看板。
text-to-SQL 的路线很直接:模型生成 SQL,应用执行,再展示结果。作者承认,它适合内部分析师;但面向 SaaS 终端客户时,他担心三件事。
第一,模型输出的是可执行查询,安全防线容易退化成关键词黑名单和只读事务。只读能限制写入,却不能单独解决越权读取。第二,如果租户隔离依赖提示词里的「只查询 account 42」,权限边界就交给了模型。第三,数据库结构,以及某些方案中的查询结果,会被发送给 AI 服务商。
DataTeller 要拿走的,是模型决定如何访问数据库的权力。
它是一个可挂载的 Rails engine。开发者提前声明数据集、指标、维度、分群,以及业务名称和同义词。模型只看到用户问题和这份词汇表,不接触数据库。
这种做法也有成本:业务能问什么,需要开发者先定义。它减少了自由探索空间,也把数据暴露范围变成了可以审查的应用配置。
模型填 JSON,租户条件由谁补上
对于「明天有多少已付款订单要发货」,模型负责生成下面的结构化查询:
{
  "version": 1,
  "intent": "answer",
  "dataset": "orders",
  "metric": "count",
  "period": { "dimension": "ship_on", "range": { "relative": "tomorrow" } },
  "filters": [ { "segment": "paid" } ]
}
关键看 dataset、metric 和 segment:它们需要匹配开发者声明的能力,不能因为模型填了一个名字,就获得对应的数据访问权。version: 1 则明确了查询格式的版本。
引擎先校验 JSON,再将它编译成 ActiveRecord 查询。作者给出的 dummy app SQL 如下:
SELECT COUNT(*) AS c0 FROM "orders"
WHERE "orders"."status" = $1                                -- 开发者声明的 paid 分群
  AND "orders"."ship_on" >= $2 AND "orders"."ship_on" < $3  -- 租户时区中的 tomorrow
  AND "orders"."account_id" = $4                            -- 编译器添加的租户过滤
最需要盯住的是最后一行:account_id = $4 由编译器添加,与模型生成的查询内容独立。所有值都通过绑定参数传入,列名来自开发者声明;tomorrow 也按租户时区解释,而不是含糊地采用服务器日期。
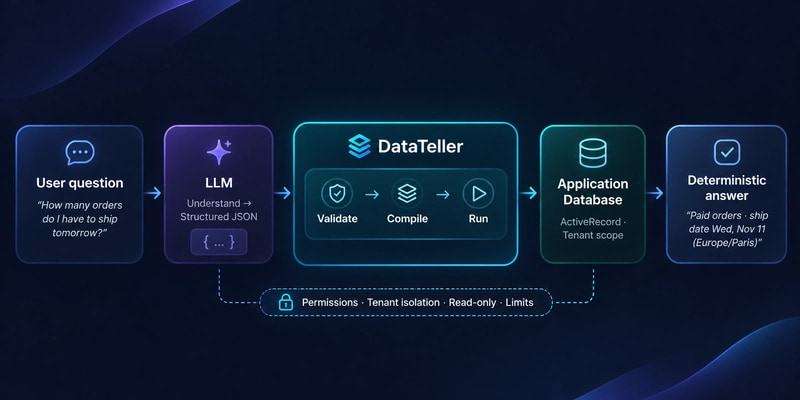
这里有几层不同的责任。参数绑定负责处理值,声明限制可选字段,服务端执行宿主应用的授权规则,编译器负责租户范围。不能指望其中一层替其他层兜底。
作者还做了一个更克制的选择:用户看到的解释,从已经校验的查询生成,不让 LLM 自由撰写。这样,界面展示的「我理解你要查什么」可以和实际执行内容对应起来。
计划中的界面支持数字、表格、查询理解说明、固定选项的澄清问题,以及拒绝回答,不提供图表。原文展示的商店、数据和回答都是预设的演示内容,不能当作功能已经完成的证据。
限制查询能力,究竟换来了什么
DataTeller 当前设定的表达范围很窄:每次查询只有一个指标,过滤条件只用 AND 组合,不支持子查询。
这让校验器和编译器需要处理的情况更少,也方便围绕明确规则编写测试。但代价同样直接:有些真实问题表达不了。作者准备通过评测统计这种情况出现的频率,目前没有给出覆盖率或准确率。
系列的推进顺序也体现了这个取舍:先搭建引擎和多租户 dummy app,再定义查询格式、实现校验器与编译器,接着处理执行保护、权限和聚合信息泄露。评测套件会在第一份提示词之前编写,接入 LLM 后再建立可测量的基线。
后续还计划比较向量检索与混合检索的 RAG 效果,并处理澄清、解释和提示词注入。Part 1 将先使用 Postgres 和 pgvector 搭建基础环境,还不写 AI 集成代码。原文发布时仓库仍是私有,作者计划随 Part 1 公开源码。
隐私边界也没有被包装成绝对承诺。查询结果行不发送给服务商,不等于没有数据外发:用户的问题里就可能包含客户姓名。作者承诺后续说明实际离开应用的信息,目前还没有完整清单。
我的判断
我认同把授权和租户隔离放在模型之外。对于面向客户的查询入口,即便模型误解问题或受到恶意输入影响,也应该只能在应用允许的范围内行动。结构化查询提供了一个便于校验和测试的接口。
但作者对 text-to-SQL 的批评有适用前提。原文没有证明所有这类系统都把隔离交给提示词,也没有与具备数据库权限控制、受限视图或其他隔离机制的方案做对照。不能据此认定「生成 SQL 就一定不安全」。
原文提到,Blazer 提供 Rails BI 能力及 SQL 生成等 AI 扩展,QueryLens 围绕自然语言查询和 SQL 执行构建 Rails engine,Cube 则提供更完整的语义层,包括指标、维度和访问策略。它们都是可选路线,文章没有提供足以比较效果的数据。
受限 JSON 能缩小模型的行动空间,但安全性最终取决于校验器、编译器和授权实现。
编译器是否始终保留租户条件,非法声明能否被绕过,聚合结果会不会泄露敏感信息,都需要证据。作者也承认这些是项目要解决的问题。因此,这篇更适合当作架构方案和验证计划阅读,还不能视为安全结论。
能拿来做什么
- 给 Node 或 Rails SaaS 增加自然语言查询时,可以先列出允许暴露的数据集、指标和筛选条件,再设计受限 JSON 格式。先确认业务问题能否表达,再接模型,能更早发现范围缺口。
- 将租户身份和权限从服务端会话、宿主应用授权逻辑中取得,并在查询构建阶段强制应用。不要把模型传回的租户字段直接当作访问依据。
- 前端可以从校验后的查询生成确认说明,明确展示统计对象、时间范围和筛选条件。无法唯一理解的问题,用固定选项让用户澄清,避免界面解释与执行内容脱节。
- 接入 LLM 前先准备正常问题、无法表达的问题和恶意输入用例,接入后再记录表现。同时梳理问题文本、业务词汇和结果各自是否外发,不把「不传结果行」当作完整隐私说明。