浏览器本地转写的线程与取消机制
FlowPick 作者介绍使用 Transformers.js、Mediabunny 和独立 Web Worker 实现浏览器本地转写,讨论取消操作、进度展示及音频分窗边界。文章区分媒体文件本地处理与模型资源联网下载,未提供准确率或性能基准。
AI 深度解读
浏览器里做语音转写,难点不只在于让模型吐出文字。模型下载到哪了、录音处理到哪了、取消后计算是否停止、分段识别有没有漏句,这些问题决定了一个演示能否变成可用工具。
FlowPick 作者分享了用 Transformers.js、Mediabunny 和 Web Worker 实现本地转写的做法。核心结论是:先把任务生命周期、进度和失败边界讲清楚,再打磨转写界面。这是一份工程实现记录,没有提供准确率或速度的对照测试。
文件留在本地,模型仍然需要下载
FlowPick 在浏览器里读取用户选择的文件并完成识别,不上传媒体文件用于转写。当前提供多语言 Whisper Tiny 和 Base,模型与运行时文件按需从 FlowPick 的静态资源站点下载。
因此,「本地转写」不能直接等同于「首次打开就能断网使用」。媒体是否上传、模型是否需要联网获取,是两件不同的事。原文也没有承诺完整的离线可用条件。
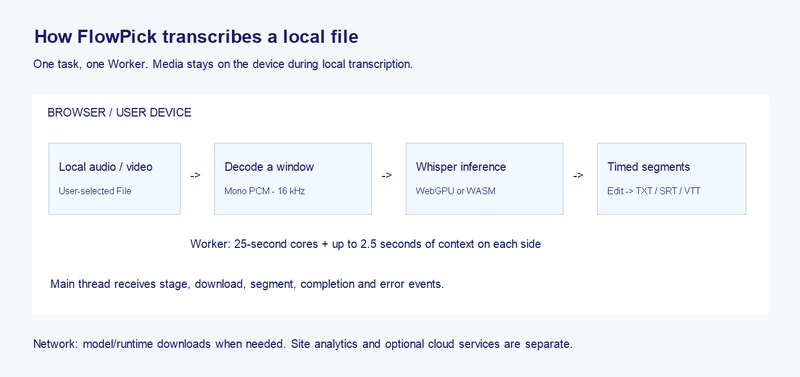
作者还划清了另一条边界:推理在本地运行,不能证明整个网站没有网络请求。网站统计和可选云服务要另行判断。对开发者来说,隐私说明应该描述具体数据流,不能只放一个「Local」标签。
任务开始后,主线程创建独立的模块 Worker,配置为 { type: 'module' },通过 worker.postMessage({ file, settings }) 传入文件和设置。Worker 负责检查输入、初始化模型、解码和推理,主线程负责界面。
一项任务对应一个 Worker,所有权清楚,取消也有明确落点。代价是每次都要重新初始化识别器,即便模型文件已经缓存。常驻 Worker 可以复用模型实例,但要额外处理并发请求、过期消息和取消后的状态。
进度条必须说清楚自己量的是什么
下载模型有字节数,转写录音有时间轴,检查音轨能否解码却未必有可计算的百分比。把它们混成一个进度条,用户很难知道现在到底在等什么。
FlowPick 将事件分开:阶段事件包含 checking、loading、decoding、detecting、transcribing;下载事件带上文件名、loaded、total 和可为 null 的 progress;识别事件返回片段、已处理位置和总时长,另有语言、完成与错误事件。
不知道下载总量时,就显示不确定进度。识别阶段则采用:
progress = coreEnd / duration * 100
它表示已经完成了多少录音内容,不是已经花掉多少计算时间。处理到录音的 50%,不能承诺剩余耗时等于前半段。
进度的价值在于解释任务状态,不在于让百分比持续上涨。
执行后端也需要同样克制。navigator.gpu 存在,只能说明浏览器暴露了接口,不能证明设备适合默认使用 GPU。FlowPick 结合适配器是否可用、报告的内存、缓冲区限制和适配器信息给出建议;未知或集成适配器通常推荐 WASM。
两条路径的配置也不同:WebGPU 使用 encoder_model: 'fp32' 和 decoder_model_merged: 'q4',WASM 使用 'q8',且这条 WASM 路径配置为单线程。自动模式允许 WebGPU 在模型初始化失败时回退 WASM,并没有把所有 GPU 错误都当作静默重跑的理由。这些属于产品策略,原文没有提供硬件基准来证明其最优。
音频切成窗口后,重复句子归谁处理
加载识别器前,Worker 先检查容器是否可读、是否存在音轨、音轨能否解码、时长是否有限且大于零。视频工具还要检查视频轨。文件扩展名无法替代这些检查。
随后通过 Mediabunny 的 AudioSampleSink 按区间读取音频,混为单声道并重采样为 16 kHz 的 Float32Array。下面这段代码解决了分块处理与边界上下文的问题:
for (let coreStart = 0; coreStart < duration; coreStart += 25) {
  const coreEnd = Math.min(duration, coreStart + 25)

  const start = Math.max(0, coreStart - 2.5)
  const end = Math.min(duration, coreEnd + 2.5)

  const audio = new Float32Array(
    Math.ceil((end - start) * 16_000)
  )

  // 解码这个区间,然后运行识别。
}
要看清 coreStart += 25 和前后各 2.5 秒的关系:每次负责 25 秒核心区间,最多读取 30 秒音频,与 Whisper 的音频窗口设计对应。
完整窗口的输入数组约占 1.92 MB,计算是 30 × 16,000 × 4 字节。这只计算输入数组,不包含模型权重、推理张量、解码缓冲区、原文件和累计字幕。分窗限制的是这部分内存,不能据此宣称整个应用内存恒定。
上下文会帮助识别跨边界语句,也会带来重复结果。FlowPick 先把窗口内时间戳换算到原始录音,再用片段中点 (segment.start + segment.end) / 2 判断归属,只保留落在当前核心区间内的片段。
针对上一窗末尾截断、下一窗识别更完整的情况,还有一次基于规范化文本前缀的协调替换。这是应用层启发式规则,无法保证完美断句。
语言检测同样保留了失败出口。实现通过音频特征和解码起始 token,比较支持的语言 token 得分;最高归一化得分至少为 0.5,且领先次高候选至少 0.15 才接受,否则返回 language-uncertain,让用户手动选择。
这里的 confidence 是候选间的归一化分数,不是校准过的正确概率。检测结果还会复用于后续窗口,所以不能把它宣传成可靠的多语言对话切换方案。
取消要停止计算,导出要守住格式
FlowPick 用 Worker 的生命周期作为取消边界。下面这段代码让取消真正结束任务,并向调用方返回明确结果:
cancel() {
  if (settled) return

  finish() // 标记任务已结束,并调用 worker.terminate()

  rejectTask(
    new DOMException('Cancelled', 'AbortError')
  )
}
关键在 finish() 内的 worker.terminate()。界面将 AbortError 视为取消,已经收到的片段可以作为部分结果保留。
但强制终止不会等待 Worker 内部代码收尾。正常路径虽有 finally 释放媒体输入和识别器,取消路径却不能依赖它执行。作者也没有承诺所有底层资源都在点击取消时同步回收。
转写结果以 start、end、text 三个字段保存,支持编辑并导出 TXT、SRT、WebVTT。导出前会清除无效或空字幕、排序,并按下一条的开始时间裁剪上一条结束时间;编辑文本中的空行或 --> 也需要处理,避免意外制造新的字幕结构。WebVTT 还要包含 WEBVTT 头部,并用点分隔毫秒。
识别正确和格式正确,是两份独立工作。
我的判断
我认可作者把工程边界摆在模型调用前面的取舍。对前端团队而言,任务状态、取消、分段和导出都能直接影响用户是否信任结果,比一个流畅的演示更有参考价值。
但这些实现不能直接当作性能结论。作者没有提供词错误率、跨浏览器兼容矩阵或实时处理速度,也没有证明 Tiny、Base 或某组量化配置更适合你的设备。GPU 推荐规则、语言检测阈值、边界文本协调都属于经验做法,需要拿实际录音验证。
独立 Worker 适合优先保证任务隔离;频繁连续转写时,常驻 Worker 的模型复用可能更有吸引力。两者的取舍要结合初始化成本和任务频率,原文没有对照数据。
同样,本地处理适合不希望上传媒体的场景,但首次下载和设备算力仍是门槛。原文没有比较云端转写,不能据此判断哪条路线更快、更准。
能拿来做什么
- 给浏览器 AI 功能设计事件协议时,分开表达任务阶段、下载字节和内容处理位置。无法计算进度的阶段直接显示状态,不要拼一个缺乏依据的总百分比。
- 为 Worker 推理任务明确取消契约:停止执行、结束 Promise、识别
AbortError,并决定部分结果是否保留。分别验证加载、解码和识别期间的取消。 - 测试长音频时,专门挑选跨越 25 秒核心边界的句子,以及静音、无可解码音轨、语言模糊的输入;模型冷缓存和热缓存加载也要分开检查。
- 把字幕导出作为独立模块验证,并在实际播放器里检查 SRT、WebVTT。人名、技术术语、重叠说话和噪声音频仍要人工复核。